转载归纳说明:本文归纳自 IEEE Spectrum 的一篇报道,不是八发金豆本人的研究或观点。原文中的产品时间表、性能数字和企业说法,大部分来自厂商自述,这里保留原文口径,没有做独立核实。读者引用前请自行回到原文与一手资料。
先统一一个词:这里的"推理"是什么意思
中文里的"推理"容易被理解成逻辑推演。但在 AI 硬件的语境里,推理(inference)指的是"使用一个已经训练好的模型去生成结果"——写代码、写文章、回答问题,都算推理。
和它对应的是训练:用海量文本反复做"猜下一个词"的游戏,通过反向传播把几十亿到几万亿个参数一点点调出来。训练是把参数调好,推理是拿参数干活。
大约从 2020 年起,行业的主线一直是训练更大的模型,而且这条路确实有效:原文引用的数据是,2020 年的 GPT-3 在一项常用的知识与推理基准上只答对 43.9%,四年后的 GPT-4o 达到 88.7%。
但到了 2026 年,话题中心换了。原文引用 Moor Insights & Strategy 分析师的说法:"感觉训练已经是昨天的新闻了,首席信息官现在想聊的全是推理。"英伟达(NVDA)CEO 黄仁勋在 GTC 2026 上把这一变化称为"推理的拐点"。
推理需求为什么突然爆发
原文给了三条并行的原因:
- 模型变得真正有用,于是用的人和用的次数都在涨;
- 推理型模型会自己跟自己对话。面对一个问题,它不是跑一次推理,而是通过"思维链"反复向自身提示、跑很多次。原文的口径是:高推理强度的模型,生成的文本量可以达到低推理强度模型的 20 倍;
- 智能体全天候工作。推理不再只是对用户提问的即时响应,而是朝着一个目标自主推进,24 小时不停。
一次推理分成两段,吃的资源完全不同
这是整篇报道最值得记住的一点。
第一段叫"预填充"(prefill),也就是读题。模型把你的提示、上传的文件、之前的对话一次性读进去,同时计算所有词元之间的关系(也就是 Transformer 的"注意力")。这一步天然可以并行拆开——这正是 GPU 成为主流 AI 加速器的原因,图形渲染也是高度并行的活。
这一步会产生大量"键"和"值"向量,被存进所谓的 KV 缓存。理论上它不是必需的(每次重算也行),但几乎所有模型都用它来省算力。KV 缓存放在内存里,可能从很小一路膨胀到几十 GB。
第二段叫"解码"(decode),也就是吐字。模型一个词元一个词元往外生成:每生成一个,都要拿它和 KV 缓存里的全部内容做一遍关联计算,再把新的键值写回缓存。
关键在于,解码是自回归的——下一个输出依赖上一个输出,步骤之间有先后,没法并行。而且每生成一个词元,都要把整个模型的权重从内存读一遍,模型本身就有几十到几百 GB,这还没算 KV 缓存。
所以瓶颈往往在内存,不在算力
当数据供不上时,再强的计算单元也只能干等。原文引用的研究结果是:跑开源大模型的英伟达 H100,有 50% 到 80% 的时间处于闲置状态。
Meta(META)前芯片工程负责人、Majestic Labs 联合创始人的总结很直接:用 GPU 方案,最后往往是算力严重过剩、内存严重不足。
改内存的四条路
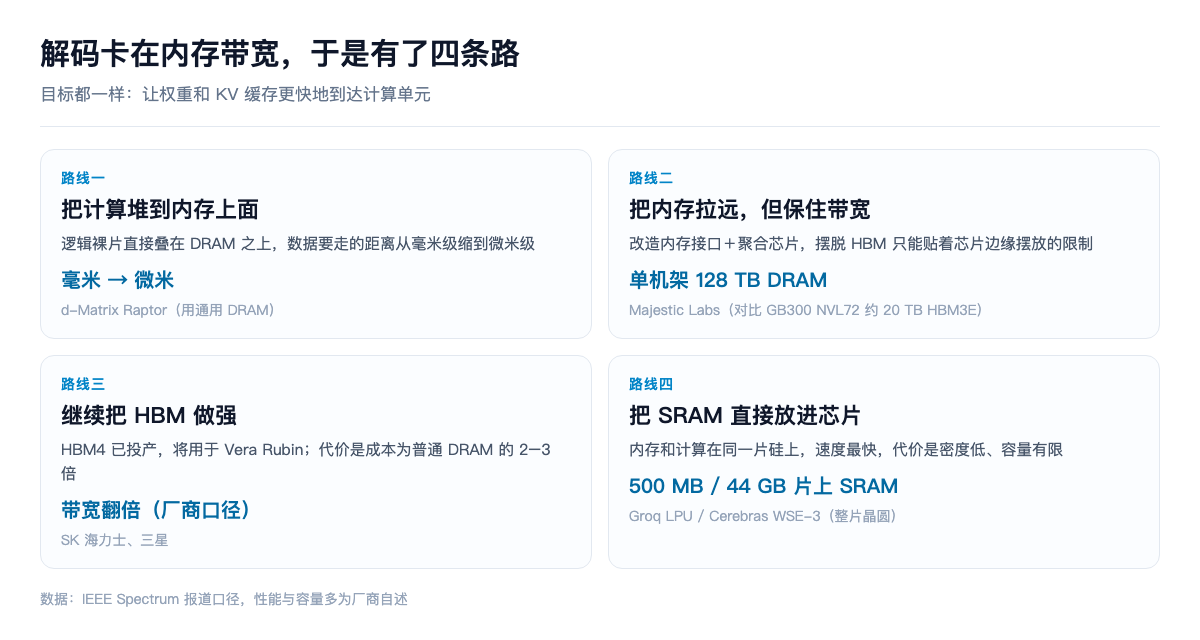
第一条:把计算搬到内存上面去。推理芯片公司 d-Matrix 的第二代加速器 Raptor,把逻辑裸片直接堆叠在 DRAM 之上,让数据要走的距离"从毫米级缩短到微米级"。原理像盖楼——同样的占地面积,往上长。
第二条:把内存拉远,但保住带宽。Majestic Labs 反过来做:不缩短距离,而是改造内存接口,让它能支撑更长的线路。原文的说法是,HBM 的接口物理距离只有 2 到 3 毫米,芯片周边只有一圈有限的"海岸线";而 Majestic 用专有铜互连加一颗内存聚合芯片,号称能把数据送到大约一米之外,单个机架挂到 128 TB 的普通 DRAM——对比英伟达 GB300 NVL72 机架约 20 TB 的 HBM3E。
这两家有个共同点:都用便宜的通用 DRAM,不用 HBM。原文引用内存分析师的数字:HBM 的成本是普通 DRAM 的两到三倍。
第三条:继续把 HBM 做强。HBM4 已经投产,将用于英伟达计划 2026 年下半年出货的 Vera Rubin GPU。SK 海力士方面称,HBM4 会把最大内存带宽翻倍、并增加每个堆栈的容量。
第四条:把高速的 SRAM 直接放进芯片。SRAM 和处理器在同一片硅上,速度最快,缺点是密度低、成本高,大多数芯片只有几十 MB。但推理让它重新变得有吸引力,因为它能把权重放到离计算单元最近的地方。
大厂的答案:让不同芯片各干各的
原文最有信息量的部分,是两家巨头不约而同选择了"双芯片分工"。
英伟达 + Groq。原文称英伟达在 2025 年底以一笔约 200 亿美元、颇有争议的交易,拿到了推理创业公司 Groq 的知识产权和核心团队;三个月后在 GTC 2026 发布 Groq 3 语言处理单元(LPU)。LPU 的原始算力远低于标准 GPU,但有 500 MB 片上 SRAM 直连浮点运算单元,英伟达高管称其内存带宽是 GPU 的七倍。
分工方式是:Vera Rubin GPU 做注意力和上下文处理(预填充),LPU 做矩阵乘(解码)。256 个 LPU 组成一套机架级系统 Groq 3 LPX。
AWS + Cerebras。亚马逊(AMZN)自己有 Trainium,但仍然选择和 Cerebras(CBRS)配对:Trainium 做预填充,Cerebras 的晶圆级引擎 WSE-3 做解码。WSE-3 把一整片晶圆做成一颗芯片,超过 4 万亿个晶体管,不外挂内存,而是直接在晶圆上做出 44 GB 的 SRAM,权重就住在里面。
原文举的例子是:OpenAI 用 WSE-3 为其编程模型的一个变体供能,输出速度超过每秒 1,000 个词元,而其标准部署的模型是每秒 50 到 125 个。Cerebras 也可以把多片 WSE-3 联网成一个统一内存池,独立完成包括预填充在内的全部推理,原文称已展示过运行万亿参数级的模型。
用英伟达高管的原话概括这一节:要完成现代 AI 推理,你需要各种芯片。
软件侧:用更少的比特做更多的事
硬件之外,另一条主线是量化——把模型里的数值从高精度格式转成低精度格式,比如从 8 位转到 4 位。位数少了,占的内存和消耗的算力都少,代价是可能损失模型质量。
原文引用 Tensordyne 联合创始人的一个提问方式,很适合用来理解这个权衡:同样的内存和算力预算下,你要一个规模为 x 的 8 位模型,还是一个规模翻倍的 4 位模型?他的判断是,人们正在发现 4 位方案更划算——相当于"突触"数量翻倍。
格式之争已经开打:英伟达推自己的 NVFP4,超威半导体(AMD)、英特尔(INTC)、高通(QCOM)支持另一种格式 MXFP4(英伟达也参与了它的开发)。英伟达给的数据是,把 DeepSeek-R1 从 FP8 量化到 NVFP4 后,七项主要基准得分下降不到 1%,性能提高到三倍。
更激进的一路:用通用性换效率
原文还列了两家把赌注下得更重的公司:
- Tensordyne 用对数数制做推理。利用"乘积的对数等于对数之和",把芯片里昂贵的乘法电路换成便宜的加法电路(乘法更耗电、更占裸片面积)。它称机架级产品 Napier 能给每位用户最高每秒 1,300 个词元,耗电不到同类英伟达硬件的十分之一,预计 2027 年推出;
- Etched 更极端,直接把 Transformer 架构固化进硅片,不做通用 GPU。它称首款芯片 Sohu 跑 Llama 70B 能达到每秒 50 万个词元,但代价是跑不了偏离典型 Transformer 的模型。原文提到它在 8 月交付了第一套机架系统。
这两家的共同点,也是这条路线的共同风险:效率来自放弃通用性,而模型架构一旦变了,固化进硅片的东西就可能作废。
原文的结论:不会只有一个赢家
面对这么多方向——把计算堆到内存上、把接口从毫米拉到一米、用整片晶圆装 SRAM、把模型压到 4 位——很容易想问"谁会赢"。
原文认为这可能不是正确的问题。它给出的类比是 CPU:晶体管微缩放缓之后,性能提升并没有沿着单一方向继续,而是靠架构创新、系统创新等多条路一起推进,写下来能装满几十本书。AI 推理的演进,很可能是同一种形态。
需求侧的理由则更直白,用原文引述分析师的话说:你可以往组织里加一百万个智能体,它们一天工作 24 小时,不会像人一样五点下班。
归纳要点
- 重心转移:行业关注点正从"训练更强的模型"转向"让模型跑得更快、更便宜";
- 两个阶段:预填充读输入、可并行;解码逐词元生成、有先后依赖;
- 真正的瓶颈:解码卡在内存带宽而不只是算力,H100 闲置率可达 50%–80%;
- 四条内存路线:计算堆到内存上、远端内存聚合、升级 HBM、把大容量 SRAM 放上芯片;
- 芯片分工成型:英伟达用 GPU + Groq LPU,AWS 用 Trainium + Cerebras,各干擅长的那一段;
- 量化降本:用更少的比特表示数值,关键是尽量保住模型质量,NVFP4 与 MXFP4 正在竞争;
- 专用芯片:用对数运算、把 Transformer 固化进硅,效率换来的是适用范围变窄;
- 没有单一赢家:推理性能的进步更可能像 CPU 那样,靠多种技术长期共同推进。
本文为对 IEEE Spectrum 报道的归纳整理,不代表本站观点,也不构成任何投资建议。文中所有性能数字、产品时间表和市场份额均为原文口径,多数源自厂商自述;涉及具体公司和产品的判断,请以一手资料为准。