先说结论:今天一颗顶级 AI 芯片的性能,有一半是在晶圆厂里做出来的,另一半是在封装里"拼"出来的。
过去五十年,芯片进步靠的是把晶体管做小。但到了 AI 芯片这一代,单纯把晶体管做小已经不够了:芯片面积撞上了光刻机的物理上限,内存的速度跟不上计算的速度,芯片之间的连接成了瓶颈。这三道墙,最后都要靠封装来翻过去。
这篇从英伟达(NVDA)的 H100 和 B200 出发,把先进封装拆成一套完整的框架:四个问题、四个部件、四种关键结构、四家主要玩家。读完之后,你拿到任何一颗 AI 芯片的资料,都能看懂它的封装在解决什么问题。
如果想先看入门版,可以读之前的先进封装系列第一篇。
先把几个词讲清楚
英文缩写:
| 缩写 | 英文全称 | 中文意思 | 通俗解释 |
|---|---|---|---|
| AI | Artificial Intelligence | 人工智能 | — |
| GPU | Graphics Processing Unit | 图形处理器 | 训练和运行 AI 模型的主力芯片 |
| HBM | High Bandwidth Memory | 高带宽内存 | 把多层内存芯片竖着叠起来、紧贴 GPU 摆放的高速内存 |
| DRAM | Dynamic Random-Access Memory | 动态随机存取存储器 | 最常见的内存芯片,HBM 就是用它叠起来的 |
| CoWoS | Chip on Wafer on Substrate | 晶圆上芯片再上基板 | 台积电的 2.5D 封装技术:先把芯片装到中介层上,再装到基板上 |
| CoWoS-S / R / L | S = Silicon,R = RDL,L = LSI | 硅中介层版 / 重布线层版 / 局部硅桥版 | CoWoS 的三个版本,区别在"中间那一层"用什么做 |
| RDL | Redistribution Layer | 重布线层 | 在芯片表面或中介层上做出的多层细金属线,用来重新安排走线 |
| LSI | Local Silicon Interconnect | 局部硅互连(局部硅桥) | 只在需要高密度连接的地方放一小块硅片当"桥" |
| TSV | Through-Silicon Via | 硅通孔 | 在硅片上垂直打穿、填满铜的小孔,让信号上下穿过 |
| InFO | Integrated Fan-Out | 集成扇出型封装 | 台积电的扇出型封装,不用中介层和传统基板 |
| FOPLP | Fan-Out Panel Level Packaging | 面板级扇出型封装 | 用方形大面板代替圆形晶圆来做扇出封装 |
| SoIC | System on Integrated Chips | 系统整合芯片 | 台积电的 3D 堆叠技术,芯片之间直接键合 |
| EMIB | Embedded Multi-die Interconnect Bridge | 嵌入式多芯片互连桥 | 英特尔的技术:把小块硅桥埋进封装基板里 |
| UCIe | Universal Chiplet Interconnect Express | 通用芯粒互连标准 | 让不同公司的小芯片能互相连接的行业标准 |
| NV-HBI | NVIDIA High-Bandwidth Interface | 英伟达高带宽接口 | B200 两颗芯片之间的高速连接 |
| OSAT | Outsourced Semiconductor Assembly and Test | 专业封装测试厂 | 专门替别人做封装和测试的公司,如日月光、安靠 |
| MR-MUF | Mass Reflow Molded Underfill | 批量回流模塑底部填充 | SK 海力士堆叠 HBM 的工艺 |
| TC-NCF | Thermal Compression Non-Conductive Film | 热压非导电薄膜 | 三星、美光堆叠 HBM 常用的工艺 |
| TB/s | Terabytes per second | 太字节每秒 | 内存带宽单位,1 TB/s 约等于每秒传 1,000 GB |
中文术语:
| 词 | 通俗解释 |
|---|---|
| 封装 | 把裸芯片装进"外壳"、接上外部电路的过程。传统封装只是"保护 + 接线",先进封装是"把多颗芯片拼成一个系统" |
| 光罩极限 | 光刻机一次曝光能覆盖的最大面积,约 26 × 33 毫米、即约 858 平方毫米,单颗芯片不能比这个更大 |
| 中介层 | 垫在芯片和基板之间的一层"转接板",上面布满细密的连线 |
| 基板 | 封装最底层的"地基",一般是有机材料,负责把芯片接到主板上 |
| 凸点 / 微凸点 | 芯片底部的小金属球,用来和下一层焊接;微凸点更小、更密 |
| 混合键合 | 不用凸点,让上下两颗芯片的铜垫直接"长"在一起,连接密度高得多 |
| 芯粒(Chiplet) | 把一颗大芯片拆成的若干小芯片 |
| 2.5D / 3D 封装 | 2.5D 是芯片并排放在中介层上;3D 是芯片直接叠在另一颗芯片上面 |
| 良率 | 一片晶圆上能用的芯片所占的比例 |
一、从 H100 到 B200:问题是怎么被逼出来的
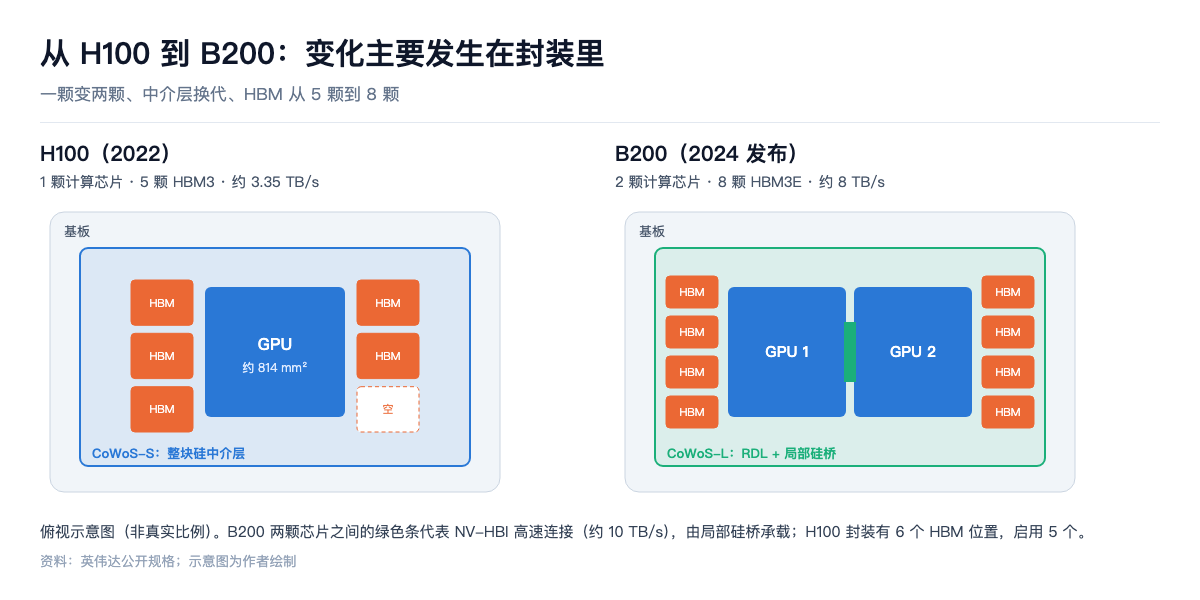
先看两颗芯片的对比(英伟达公开的规格):
| H100(2022 年) | B200(2024 年发布) | |
|---|---|---|
| 计算芯片 | 1 颗,约 800 亿个晶体管 | 2 颗,合计约 2,080 亿个晶体管 |
| 单颗计算芯片面积 | 约 814 平方毫米,已接近光罩极限 | 每颗都接近光罩极限 |
| 两颗芯片之间的连接 | —— | NV-HBI,每秒约 10 太字节 |
| HBM | 5 颗 HBM3(封装上有 6 个位置,启用 5 个),80 GB | 8 颗 HBM3E,最高 192 GB |
| 内存带宽 | 约 3.35 TB/s(SXM 版本,即英伟达服务器专用的插槽式模块) | 约 8 TB/s |
| 封装技术 | 台积电 CoWoS-S | 台积电 CoWoS-L |
这张表里藏着 AI 芯片面对的三道墙:
第一道墙:面积墙。H100 的计算芯片已经有约 814 平方毫米,离约 858 平方毫米的光罩极限只差一点点。想再多塞晶体管,单颗芯片已经做不大了。B200 的办法是做两颗接近极限的芯片,再用封装把它们连成"一颗"——这就是芯粒(Chiplet)思路。
第二道墙:内存墙。AI 模型越来越大,计算单元等数据的时间越来越长。B200 把 HBM 从 5 颗增加到 8 颗,内存带宽从约 3.35 提高到约 8 TB/s。内存必须紧贴着 GPU 放,而且要足够多——这就要求一块更大的"底座"。
第三道墙:连接墙。两颗芯片之间、GPU 和内存之间,需要每秒几个到十几个太字节的连接。普通电路板上的走线根本做不到这个密度,只有硅级别的超细连线才行。
这三道墙,就是先进封装存在的全部理由。从 H100 到 B200,最大的变化不在晶体管本身(两者用的是同一代工艺的改进版),而在于:从一颗芯片变成两颗、从 CoWoS-S 换成 CoWoS-L、HBM 从 5 颗变成 8 颗。
二、先进封装的"四个部件"
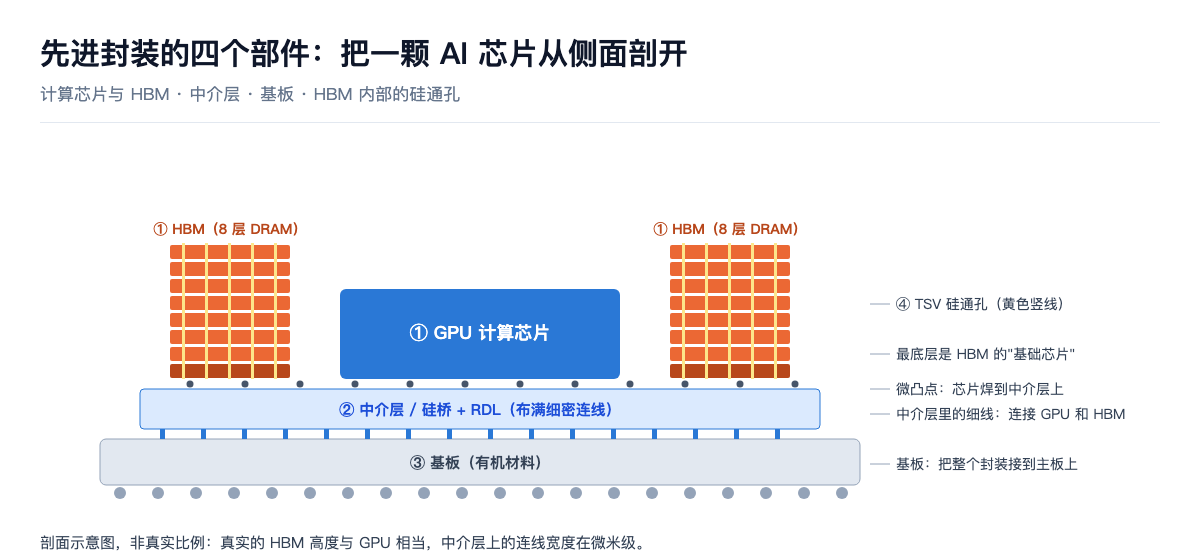
把一颗 B200 这样的芯片从侧面剖开,从上到下可以看到四样东西:
- 计算芯片和 HBM:最上层,并排摆放;
- 中介层(或桥):把它们连起来的"转接层",上面布满细密的连线;
- 基板:最下面的"地基",把整个封装接到主板上;
- HBM 内部:每颗 HBM 本身又是 8 到 12 层内存芯片竖着叠起来的"小楼",层与层之间靠硅通孔连接。
先进封装的所有技术,都可以归到这四个方向里:
| 方向 | 解决的问题 | 代表技术 |
|---|---|---|
| 横向连接(2.5D) | 让并排的芯片之间高速通信 | CoWoS、EMIB、I-Cube |
| 纵向堆叠(3D) | 把芯片叠起来,距离更短、占地更小 | HBM、SoIC、Foveros、混合键合 |
| 重新布线 | 把芯片密密麻麻的接口"展开"成外部能接的形式 | RDL、扇出型封装(InFO) |
| 拆分重组(Chiplet) | 把大芯片拆小,突破面积和良率限制 | 芯粒设计 + UCIe 等互连标准 |
下面逐一展开。
三、CoWoS:AI 芯片最主流的"底座"
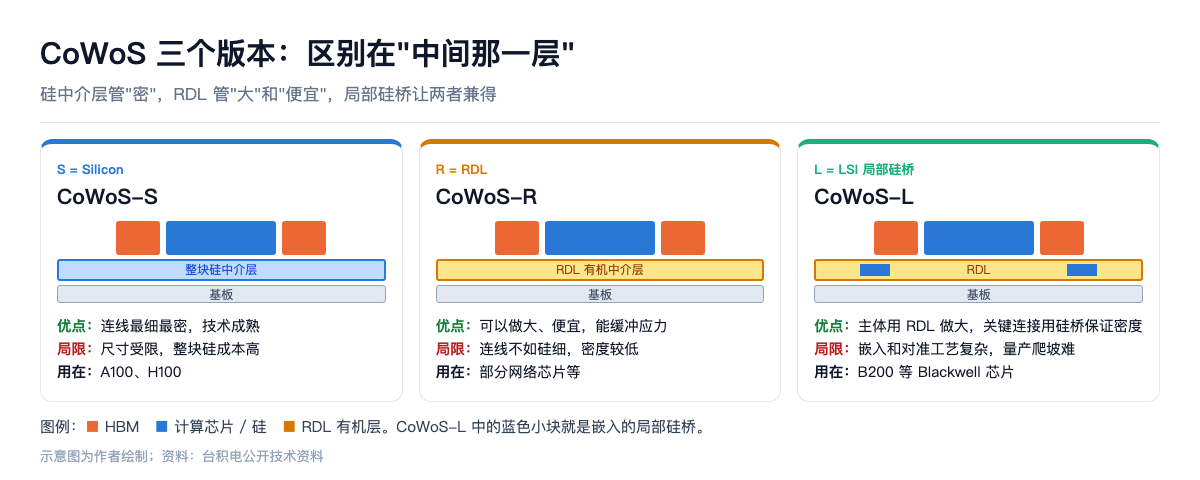
CoWoS 的名字就是它的做法:先把芯片(Chip)装到晶圆(Wafer)上的中介层,再装到基板(Substrate)上。关键在"中间那一层"用什么做——这就分出了三个版本。
CoWoS-S:完整的硅中介层
做法:在计算芯片和 HBM 下面,垫一整块硅片当中介层。硅中介层用晶圆厂的工艺做,连线可以做到不到 1 微米宽、层层密布,所以芯片之间的连接密度极高。
解决的问题:让 GPU 和 HBM 之间有成千上万条超短、超密的连线。HBM 的接口有上千根数据线,只有硅中介层能承载这个密度。
局限:
- 尺寸受限:硅中介层本身也是用光刻做出来的,做得越大越难,成本和良率都会恶化。H100 这种"一颗 GPU 加五六颗 HBM"的规模还可以,B200 需要放两颗接近光罩极限的大芯片再加 8 颗 HBM,一整块硅中介层就太大、太贵了;
- 成本高:大部分面积其实只是"走线",却要用昂贵的硅和晶圆工艺来做。
代表产品:英伟达 A100、H100,以及多代数据中心 AI 芯片。
CoWoS-R:用重布线层(RDL)代替硅
做法:中介层不用硅,而是用有机材料加多层细金属线(RDL)做成。
解决的问题:成本和尺寸。有机的 RDL 中介层可以做得更大、更便宜,也更有弹性,能缓解芯片和基板之间因为热胀冷缩不同带来的应力。
局限:有机材料上的连线做不到硅那么细(通常在几微米级别),连接密度比硅中介层低。对于需要极高密度的 GPU 和 HBM 之间的连接,只用 RDL 不够。
适合:对连接密度要求没那么极致、但芯片面积大、对成本敏感的产品,比如部分网络芯片。
CoWoS-L:局部硅桥 + RDL,两者取长补短
做法:中介层主体用 RDL 做,只在真正需要超高密度连接的地方——比如两颗计算芯片之间、GPU 和每颗 HBM 之间——嵌入一小块硅片当"桥"(局部硅互连,LSI)。
解决的问题:同时要"大"和"密"。
- 大部分面积用便宜、可以做大的 RDL;
- 少数关键连接用硅桥,保证连接密度;
- 整个中介层可以做到好几倍光罩的尺寸,放得下两颗大芯片和 8 颗甚至更多 HBM。台积电公开的路线图,是把中介层继续做大到接近 9 倍光罩尺寸。
这就是 B200 换用 CoWoS-L 的原因:两颗大芯片之间每秒约 10 太字节的连接走硅桥,其他走线走 RDL。
代价:工艺更复杂——要把硅桥精确地嵌进有机层里,对准精度、翘曲控制、良率爬坡都更难。Blackwell 初期的量产爬坡,封装就是公认的难点之一。
四、HBM:把内存"竖起来"
HBM 本身就是一个 3D 封装的产物。
做法:把 8 层、12 层甚至 16 层 DRAM 芯片叠起来,每层芯片上打出几千个硅通孔(TSV)——垂直穿透硅片、填满铜的小孔——让信号和电力上下贯通;层与层之间用微凸点连接;最底下是一颗"基础芯片",负责和 GPU 通信。
为什么要这么做?
- 宽:HBM 的接口有 1,024 根数据线(HBM4 翻倍到 2,048 根),而普通显卡内存只有几十根。宽度换来带宽;
- 近:HBM 就放在 GPU 旁边几毫米的地方,通过中介层连接,距离短、功耗低;
- 省地方:竖着叠,占地面积小,一颗 GPU 旁边能放 8 颗。
HBM 的难点全在封装上:
- 堆叠工艺:SK 海力士用 MR-MUF 工艺(先把芯片叠好,再一次性回流焊接并灌入填充材料),散热和良率表现较好;三星和美光(MU) 较多使用 TC-NCF 工艺(每层用热压和一层非导电薄膜粘合)。工艺路线的差别,是 HBM 良率和散热差距的重要原因之一;
- 越叠越高越难:层数越多,总高度受限(要和 GPU 一样高),每层芯片就得磨得更薄,翘曲、散热、良率问题越突出。16 层以上,行业普遍认为要转向混合键合;
- HBM4 的新变化:最底下的基础芯片开始用逻辑芯片工艺制造。SK 海力士和台积电合作生产 HBM4 的基础芯片——内存厂和晶圆代工厂的边界开始模糊。
所以 HBM 的供给,不只取决于内存产能,还取决于堆叠和封装能力。网站之前的 HBM 系列对这部分有更详细的拆解。
五、Chiplet:把大芯片拆开
芯粒(Chiplet)的核心是一道良率算术题。
晶圆上的缺陷是随机分布的。芯片面积越大,碰上缺陷的概率越高。用一个简化的模型做个示意(仅用于说明原理,真实数字因工艺而异):假设每平方厘米平均有 0.1 个致命缺陷——
- 一颗 800 平方毫米的大芯片,良率大约是 45%;
- 拆成两颗 400 平方毫米的芯片,每颗良率约 67%;而且坏了只丢一半,好的可以和别的好芯片配对。
拆开之后,同样的晶圆能做出更多"能用"的芯片。
芯粒的另外两个好处:
- 混用工艺:计算核心用最先进、最贵的工艺,输入输出和模拟电路用成熟便宜的工艺。超威半导体(AMD,Advanced Micro Devices)的服务器 CPU(Central Processing Unit,中央处理器)最早大规模采用这个思路;它的 MI300 系列 AI 芯片更进一步,把计算芯片通过台积电的 SoIC 直接叠在底层芯片上,再用 CoWoS 和 HBM 拼在一起;
- 突破面积上限:单颗受光罩限制,拼起来就没有上限。
代价是"拼接"本身:拆开的芯片之间必须有足够快的连接,否则拼出来的只是"一堆芯片"。B200 两颗芯片之间每秒约 10 太字节的连接,就是为了让软件把它当成一颗 GPU 来用。
行业正在推动 UCIe 标准,目标是让不同公司、不同工艺的芯粒像乐高一样互相连接。但目前顶级 AI 芯片仍然主要用各家自己的专有互连。
六、扇出型封装:不用中介层也能"拼"
扇出型封装(Fan-Out)走的是另一条路:不用中介层,也不用传统基板。
做法:把切好的芯片重新摆到一块临时载板上,用塑封材料包起来,形成一块"重组晶圆";然后直接在上面做多层 RDL,把芯片的接口"扇出"到更大的面积上,再接到外部。
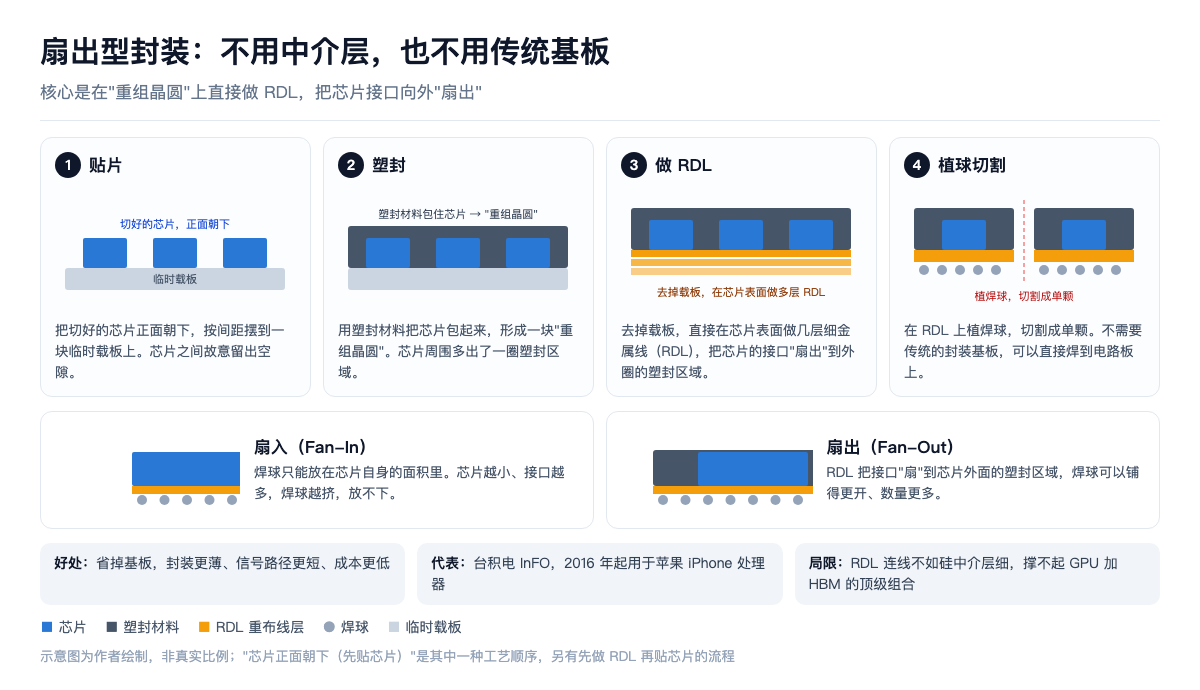
"扇出"这个名字的意思,看上图下半部分就明白了:传统的"扇入"封装,焊球只能放在芯片自己的面积里——芯片越小、接口越多,焊球就越挤;扇出封装则通过 RDL,把接口"扇"到芯片外圈的塑封区域,焊球可以铺得更开、数量更多。
解决的问题:更薄、更便宜、性能更好。因为省掉了基板,封装更薄、电信号路径更短。台积电的 InFO 最早在 2016 年用于苹果(AAPL) 的 iPhone 处理器,这也是台积电从"只做晶圆"走向"也做封装"的起点。
在 AI 芯片上的角色:
- 纯扇出的连线密度,不如硅中介层,单靠它撑不起 GPU 加 HBM 这样的顶级组合;
- 但它的思路正在被借用:台积电的 InFO 系列也加入了局部硅桥;CoWoS-R、CoWoS-L 里的 RDL,本质上就是扇出技术的延伸;
- 面板级扇出(FOPLP):用方形大面板代替 300 毫米圆形晶圆,一块面板能放下更多超大封装,面积利用率更高。这是行业解决"中介层越做越大、圆晶圆装不下几颗"的方向之一,台积电、日月光等都在推进。
七、四种关键结构,分别解决什么问题
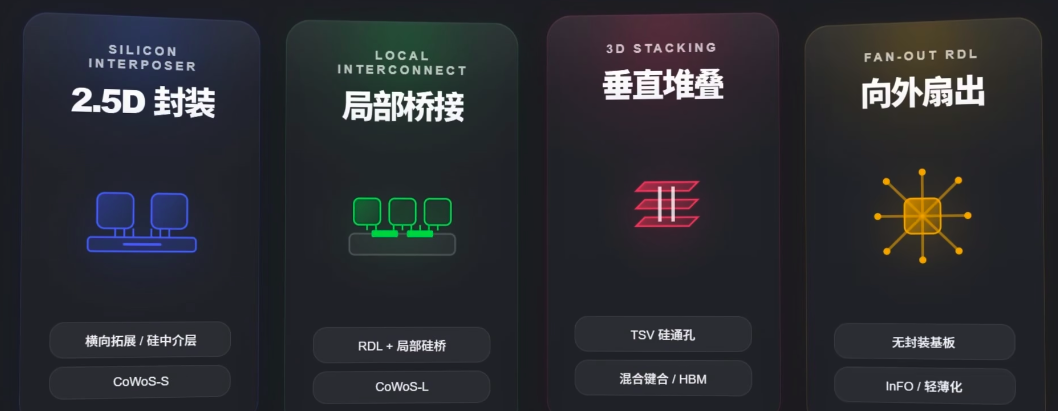
上面这张图把四种技术放在了一起:2.5D 封装靠硅中介层横向拓展(CoWoS-S);局部桥接用 RDL 加局部硅桥(CoWoS-L);垂直堆叠靠 TSV 硅通孔和混合键合(HBM);向外扇出不用封装基板(InFO,更轻薄)。下面的表格把它们对应到四种关键结构上,逐项对比:
把前面讲的四个关键结构放在一起对比:
| 结构 | 是什么 | 解决什么问题 | 优点 | 代价 | 典型用法 |
|---|---|---|---|---|---|
| 完整硅中介层 | 一整块硅片当"转接板" | 芯片之间超高密度的横向连接 | 连线最细最密,技术成熟 | 尺寸受限、成本高 | CoWoS-S:A100、H100 |
| RDL 重布线层 | 多层细金属线,做在有机层或芯片表面 | 把芯片接口"展开",做大面积低成本的走线 | 可以做大、便宜、缓冲应力 | 连线不如硅细,密度较低 | CoWoS-R、扇出型封装、CoWoS-L 的主体 |
| 局部硅桥 | 只在关键位置嵌入的小块硅片 | 在大面积中介层上,只给关键连接提供高密度 | 兼顾"大"和"密",成本低于整块硅 | 嵌入和对准工艺复杂 | CoWoS-L:B200;英特尔 EMIB |
| TSV 硅通孔 | 垂直打穿硅片的铜柱 | 让信号和电力在上下叠放的芯片之间穿行 | 实现 3D 堆叠,距离最短 | 打孔、填铜、减薄都很难,影响良率 | HBM、硅中介层、SoIC 等 3D 堆叠 |
一句话记住:硅中介层管"密",RDL 管"大"和"便宜",局部硅桥让你两者兼得,TSV 让芯片可以往上叠。
八、竞争格局:四类玩家,四种打法
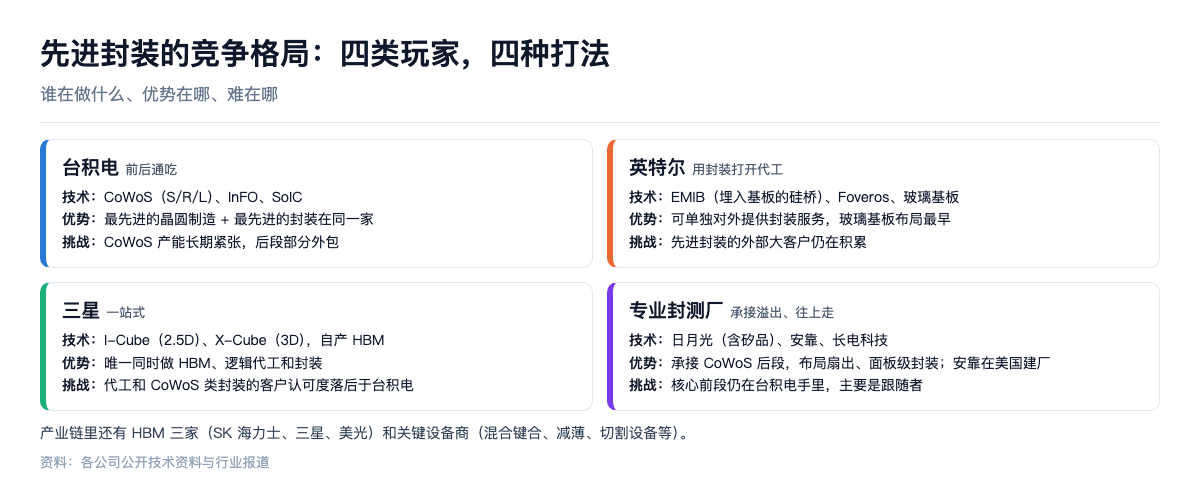
台积电(TSM):前后通吃
台积电把先进封装做成了一个完整的体系,统称 3DFabric:
- CoWoS(2.5D):AI 芯片的绝对主流,英伟达、超威半导体、谷歌、亚马逊等的 AI 芯片大多依赖它;
- InFO(扇出):手机和部分高性能芯片;
- SoIC(3D 混合键合):芯片直接叠芯片,已用于超威半导体的产品。
它的最大优势是"前后一体":最先进的晶圆制造和最先进的封装都在同一家。客户用了台积电的 3 纳米、2 纳米,再用它的 CoWoS,良率、设计配合、交付节奏都最顺。这也让 CoWoS 产能长期是整个 AI 芯片供应链最紧的瓶颈之一,先进封装系列第三篇专门拆过这个供需账本。
台积电也在把部分工序外包:CoWoS 分成"芯片装到中介层上"(前段)和"再装到基板上"(后段)两步,后段的一部分交给了日月光旗下的矽品、安靠等封测厂。
英特尔(INTC):用封装打开代工市场
英特尔的两张王牌:
- EMIB:把小块硅桥直接埋进有机基板里,不需要整块中介层。思路和 CoWoS-L 的局部硅桥相近,但做法不同——一个埋在基板里,一个嵌在中介层里;
- Foveros:3D 堆叠,把芯片叠在一块底层芯片上;更进一步的 Foveros Direct 用混合键合。
英特尔的数据中心 GPU(如 Ponte Vecchio)曾同时用 EMIB 和 Foveros,把几十颗芯粒拼在一起。
它的战略意义在于:先进封装是英特尔代工业务最容易切入的口子。即使客户的芯片不在英特尔的晶圆厂生产,也可以只用它的封装服务——这在 CoWoS 产能紧张时尤其有吸引力。英特尔也是玻璃基板最早的推动者之一,押注下一代的封装"地基"。
三星:唯一"内存 + 代工 + 封装"一站式的公司
三星的打法是"全包":它同时生产 HBM、代工逻辑芯片、提供封装(2.5D 的 I-Cube、3D 的 X-Cube 等)。理论上,它能给客户提供"从 GPU 代工到 HBM 到封装"的一站式方案。
现实中的挑战:它在最先进的逻辑代工和 CoWoS 这类封装上,客户认可度都不如台积电;HBM3E 早期在英伟达的认证上也落后于 SK 海力士。但据行业报道,它拿下了向英伟达供应 HBM4 的首发,处境正在改善。三星在美股没有上市。
独立封测厂(OSAT):承接溢出,也在往上走
- 日月光(ASX):全球最大的专业封测厂,旗下有矽品。承接 CoWoS 后段等工序,自己也在做扇出、面板级封装;
- 安靠(AMKR):美国公司,全球第二大专业封测厂之一,正在美国亚利桑那州建设先进封装厂,并和台积电合作,为台积电在当地生产的芯片提供封装;
- 长电科技:中国最大的封测厂,也在推进 2.5D 和芯粒封装(未在美股上市)。
封测厂的位置是"跟随者":最核心的 CoWoS 前段仍在台积电手里,封测厂主要承接溢出订单和后段工序。但随着 AI 芯片封装越来越大、越来越复杂,产能缺口让它们有了往上走的机会。
别忘了:HBM 厂和设备厂也是封装产业链的一部分
- HBM 三家:SK 海力士、三星、美光——HBM 的堆叠本身就是先进封装;
- 设备厂:混合键合、晶圆减薄、切割、键合设备都是关键,荷兰的 Besi、日本的 Disco 等在各自环节有很强的地位。
九、下一步:先进封装往哪里走
- 混合键合:不用凸点,铜对铜直接连接,连接间距可以从微凸点的几十微米缩小到 10 微米以下。HBM 走向 16 层以上、芯片之间 3D 堆叠,都要靠它;
- 更大的中介层:CoWoS-L 继续往更大的尺寸走,能放下更多芯片和 HBM;
- 面板级封装:从圆形晶圆走向方形面板,解决大封装"装不下"的问题;
- 玻璃基板:用玻璃代替有机材料做地基,更平整、更耐热、尺寸稳定性更好,英特尔押注最早,业内普遍认为要到本十年后期才会成熟;
- 共封装光学(CPO,Co-Packaged Optics):把光器件也封进来,让芯片直接用光对外通信——这是封装和光通信的交汇点,我在光通信那篇里专门讲过。
这些方向有一个共同点:芯片的进步,越来越多地发生在"芯片之间",而不是"芯片之内"。
十、看懂任何一颗 AI 芯片封装的五个问题
以后再看到一颗新的 AI 芯片,可以用这五个问题快速拆解它的封装:
- 计算芯片是一颗还是几颗?几颗的话,它们之间用什么连接、带宽多少?(判断是否用了芯粒)
- 下面垫的是什么?完整硅中介层、RDL,还是局部硅桥?(判断是 CoWoS-S、R 还是 L,或者英特尔 EMIB)
- 有几颗 HBM,是第几代、叠了几层?(判断内存带宽和容量的来源)
- 有没有芯片直接叠在芯片上?用的是微凸点还是混合键合?(判断是否用了 3D 堆叠)
- 谁来封装?台积电、英特尔、三星,还是专业封测厂?产能够不够?(判断供应链瓶颈在哪里)
拿 B200 来试一下:两颗计算芯片,用 NV-HBI 连接(芯粒);CoWoS-L,局部硅桥加 RDL(大而密);8 颗 HBM3E(高带宽);由台积电封装(瓶颈在 CoWoS 产能)。五个问题答完,这颗芯片的封装逻辑就清楚了。
金豆划重点
- 为什么离不开先进封装:AI 芯片撞上三道墙——面积墙(单颗芯片最大约 858 平方毫米)、内存墙(数据跟不上计算)、连接墙(芯片之间需要每秒十几太字节的连接);三道墙都要靠封装来翻越;
- H100 到 B200:从 1 颗计算芯片变成 2 颗、从 CoWoS-S 换成 CoWoS-L、HBM 从 5 颗变成 8 颗、内存带宽从约 3.35 TB/s 提高到约 8 TB/s——变化主要发生在封装里;
- 四个方向:横向连接(2.5D)、纵向堆叠(3D)、重新布线(RDL / 扇出)、拆分重组(芯粒);
- CoWoS 三兄弟:S 用整块硅中介层(最密但受尺寸和成本限制)、R 用 RDL(大而便宜但不够密)、L 用 RDL 加局部硅桥(兼顾大和密,B200 采用);
- 四种关键结构:硅中介层管"密",RDL 管"大"和"便宜",局部硅桥让两者兼得,TSV 让芯片往上叠;
- HBM 本身就是 3D 封装:多层 DRAM 靠硅通孔叠起来,堆叠工艺(MR-MUF 与 TC-NCF)影响良率和散热;HBM4 的基础芯片开始由逻辑代工厂制造;
- 竞争格局:台积电前后通吃(CoWoS、InFO、SoIC);英特尔用 EMIB、Foveros 和玻璃基板打开代工市场;三星是唯一"内存 + 代工 + 封装"一站式;日月光、安靠等专业封测厂承接溢出并往上走;
- 下一步:混合键合、更大的中介层、面板级封装、玻璃基板、共封装光学;
- 五个问题:几颗计算芯片、下面垫什么、几颗 HBM、有没有 3D 堆叠、谁来封装。
资料来源:英伟达 H100、B200 公开规格;台积电、英特尔、三星关于各自封装技术的公开资料;SK 海力士与台积电关于 HBM4 基础芯片合作的公告;安靠与台积电关于亚利桑那州封装合作的公告;行业公开报道。文中良率计算为简化模型示意,仅用于说明原理。本文只讨论技术和产业格局,不构成任何投资建议。
— 金豆