先说一句最重要的话:所有存储芯片,本质上都在回答同一个问题——怎么用最低的成本,把"0"和"1"存得又快、又多、又久。
问题是,"快、多、久、便宜"这四件事不可能同时做到。于是就有了一整个家族:有的极快但极贵(SRAM),有的便宜量大但慢(NAND),有的一断电就忘(DRAM),有的几十年都不丢(闪存)。电脑、手机和 AI 服务器里,不是只用一种存储,而是把它们像金字塔一样叠起来用。
这篇先搭这座金字塔,再一层一层拆开看每种存储的原理。需要深入了解的,网站上有专门的 HBM 系列 和 NAND 系列。
先把几个词讲清楚
英文缩写:
| 缩写 | 英文全称 | 中文意思 | 一句话解释 |
|---|---|---|---|
| RAM | Random Access Memory | 随机存取存储器 | 可以随时读写任意位置的存储,断电通常会丢数据 |
| SRAM | Static Random Access Memory | 静态随机存取存储器 | 用 6 个晶体管存 1 位,极快,只要通电就不用刷新 |
| DRAM | Dynamic Random Access Memory | 动态随机存取存储器 | 用 1 个晶体管加 1 个电容存 1 位,要不停"刷新" |
| ROM | Read-Only Memory | 只读存储器 | 出厂写好、只能读不能改的存储 |
| PROM | Programmable Read-Only Memory | 可编程只读存储器 | 用户可以写入一次,写完不能改 |
| EPROM | Erasable Programmable Read-Only Memory | 可擦除可编程只读存储器 | 能用紫外线整片擦掉、重新写入 |
| EEPROM | Electrically Erasable Programmable Read-Only Memory | 电可擦除可编程只读存储器 | 能用电按字节擦写,不用紫外线 |
| Flash | Flash Memory | 闪存 | 由 EEPROM 演变而来,按"块"一次性擦除,所以叫"闪" |
| NOR / NAND | —— | 或非型 / 与非型闪存 | 闪存的两种电路排法,名字来自逻辑门"或非""与非"的连接方式 |
| SLC / MLC / TLC / QLC | Single / Multi / Triple / Quad-Level Cell | 单层 / 多层 / 三层 / 四层单元 | 每个闪存单元存 1 / 2 / 3 / 4 位 |
| SSD | Solid-State Drive | 固态硬盘 | 用 NAND 闪存做的硬盘 |
| HDD | Hard Disk Drive | 机械硬盘 | 用磁盘存数据的传统硬盘 |
| DDR | Double Data Rate | 双倍数据速率 | 在时钟的上升沿和下降沿各传一次数据,速度翻倍 |
| SDRAM | Synchronous DRAM | 同步动态随机存取存储器 | 跟着时钟节拍工作的 DRAM,DDR 是它的升级版 |
| DIMM | Dual In-line Memory Module | 双列直插内存模组 | 我们说的"内存条" |
| LPDDR | Low-Power DDR | 低功耗 DDR | 手机、笔记本里焊死在主板上的省电内存 |
| GDDR | Graphics DDR | 图形 DDR | 显卡专用的高带宽内存 |
| HBM | High Bandwidth Memory | 高带宽内存 | 把多层 DRAM 竖着叠起来、贴着 GPU 放的内存 |
| TSV | Through-Silicon Via | 硅通孔 | 垂直打穿芯片的铜柱,让叠起来的芯片上下通信 |
| ECC | Error-Correcting Code | 纠错码 | 能自动发现并修正少量数据错误的技术 |
| CPU / GPU | Central / Graphics Processing Unit | 中央处理器 / 图形处理器 | 电脑的"大脑"和擅长并行计算的"加速器" |
| AI | Artificial Intelligence | 人工智能 | 让计算机学会理解、生成和决策的技术 |
| L1 / L2 / L3 | Level 1 / 2 / 3 Cache | 一级 / 二级 / 三级缓存 | CPU 里的 SRAM 缓存,数字越小离计算核心越近、越快、越小 |
| BIOS | Basic Input/Output System | 基本输入输出系统 | 电脑开机时最先运行的固件程序 |
| CL | CAS Latency(CAS = Column Address Strobe) | 列地址选通延迟 | 内存收到读命令后要等几个时钟节拍才吐出数据,越小越快 |
| PMIC | Power Management Integrated Circuit | 电源管理芯片 | DDR5 内存条上负责稳压供电的小芯片 |
| MB / GB / TB | Megabyte / Gigabyte / Terabyte | 兆字节 / 吉字节 / 太字节 | 容量单位,每级约差 1,000 倍 |
| MT/s | Mega-Transfers per second | 每秒百万次传输 | 内存速度单位,DDR5-6400 即每秒传输 64 亿次 |
| JEDEC | Joint Electron Device Engineering Council | 固态技术协会 | 制定 DDR、HBM 等内存标准的行业组织 |
| RS 触发器 | Reset-Set Latch | 复位-置位触发器 | 两个逻辑门交叉相连、能"记住"一个 0 或 1 的基本电路 |
| 6T | 6-Transistor | 6 晶体管 | 指用 6 个晶体管存 1 位的 SRAM 单元 |
| CMOS | Complementary Metal-Oxide-Semiconductor | 互补金属氧化物半导体 | 今天几乎所有芯片使用的电路工艺,用成对的晶体管组成逻辑门 |
| LPU | Language Processing Unit | 语言处理单元 | Groq 公司专为大模型推理设计的芯片,把模型放在片上 SRAM 里 |
| TSP | Tensor Streaming Processor | 张量流处理器 | Groq 芯片早期的名字,后来改叫 LPU |
| TPU | Tensor Processing Unit | 张量处理单元 | 谷歌自研的 AI 芯片 |
| ASIC | Application-Specific Integrated Circuit | 专用集成电路 | 只为某一类任务定制的芯片,效率高但不通用 |
| WSE | Wafer-Scale Engine | 晶圆级引擎 | Cerebras 把整张晶圆做成一颗芯片的产品名 |
| TB/s | Terabytes per second | 每秒太字节 | 带宽单位,1 TB/s 约等于每秒传输 1,000 GB |
| token | —— | 词元 | 大模型处理文字的最小单位,大约一个汉字或半个英文单词 |
中文术语:
| 词 | 通俗解释 |
|---|---|
| 易失性 / 非易失性 | 断电就丢数据的叫"易失性"(如 DRAM、SRAM);断电不丢的叫"非易失性"(如闪存、ROM) |
| 内存 / 存储(外存) | 中文里常混用。"内存"一般指 DRAM,是 CPU 正在干活时用的"工作台";"存储"或"外存"一般指 SSD、硬盘,是长期存放文件的"仓库" |
| 位(bit) | 最小的数据单位,一个 0 或一个 1 |
| 带宽 | 每秒能搬运多少数据,决定"快不快" |
| 延迟 | 从发出请求到拿到数据要等多久 |
| 擦写寿命 | 闪存单元能被反复擦除、写入多少次才会损坏 |
| 字线(Word Line) | 存储芯片里横着走的导线,一根连着一整行单元的"开关",用来选中哪一行 |
| 位线(Bit Line) | 存储芯片里竖着走的导线,一根连着一整列单元,数据从这里写进去、读出来 |
| 读出放大器(Sense Amplifier) | 接在每根位线末端的小电路,把位线上极微弱的电压变化放大成清楚的 0 或 1 |
一、存储金字塔:一张图看懂所有存储的位置
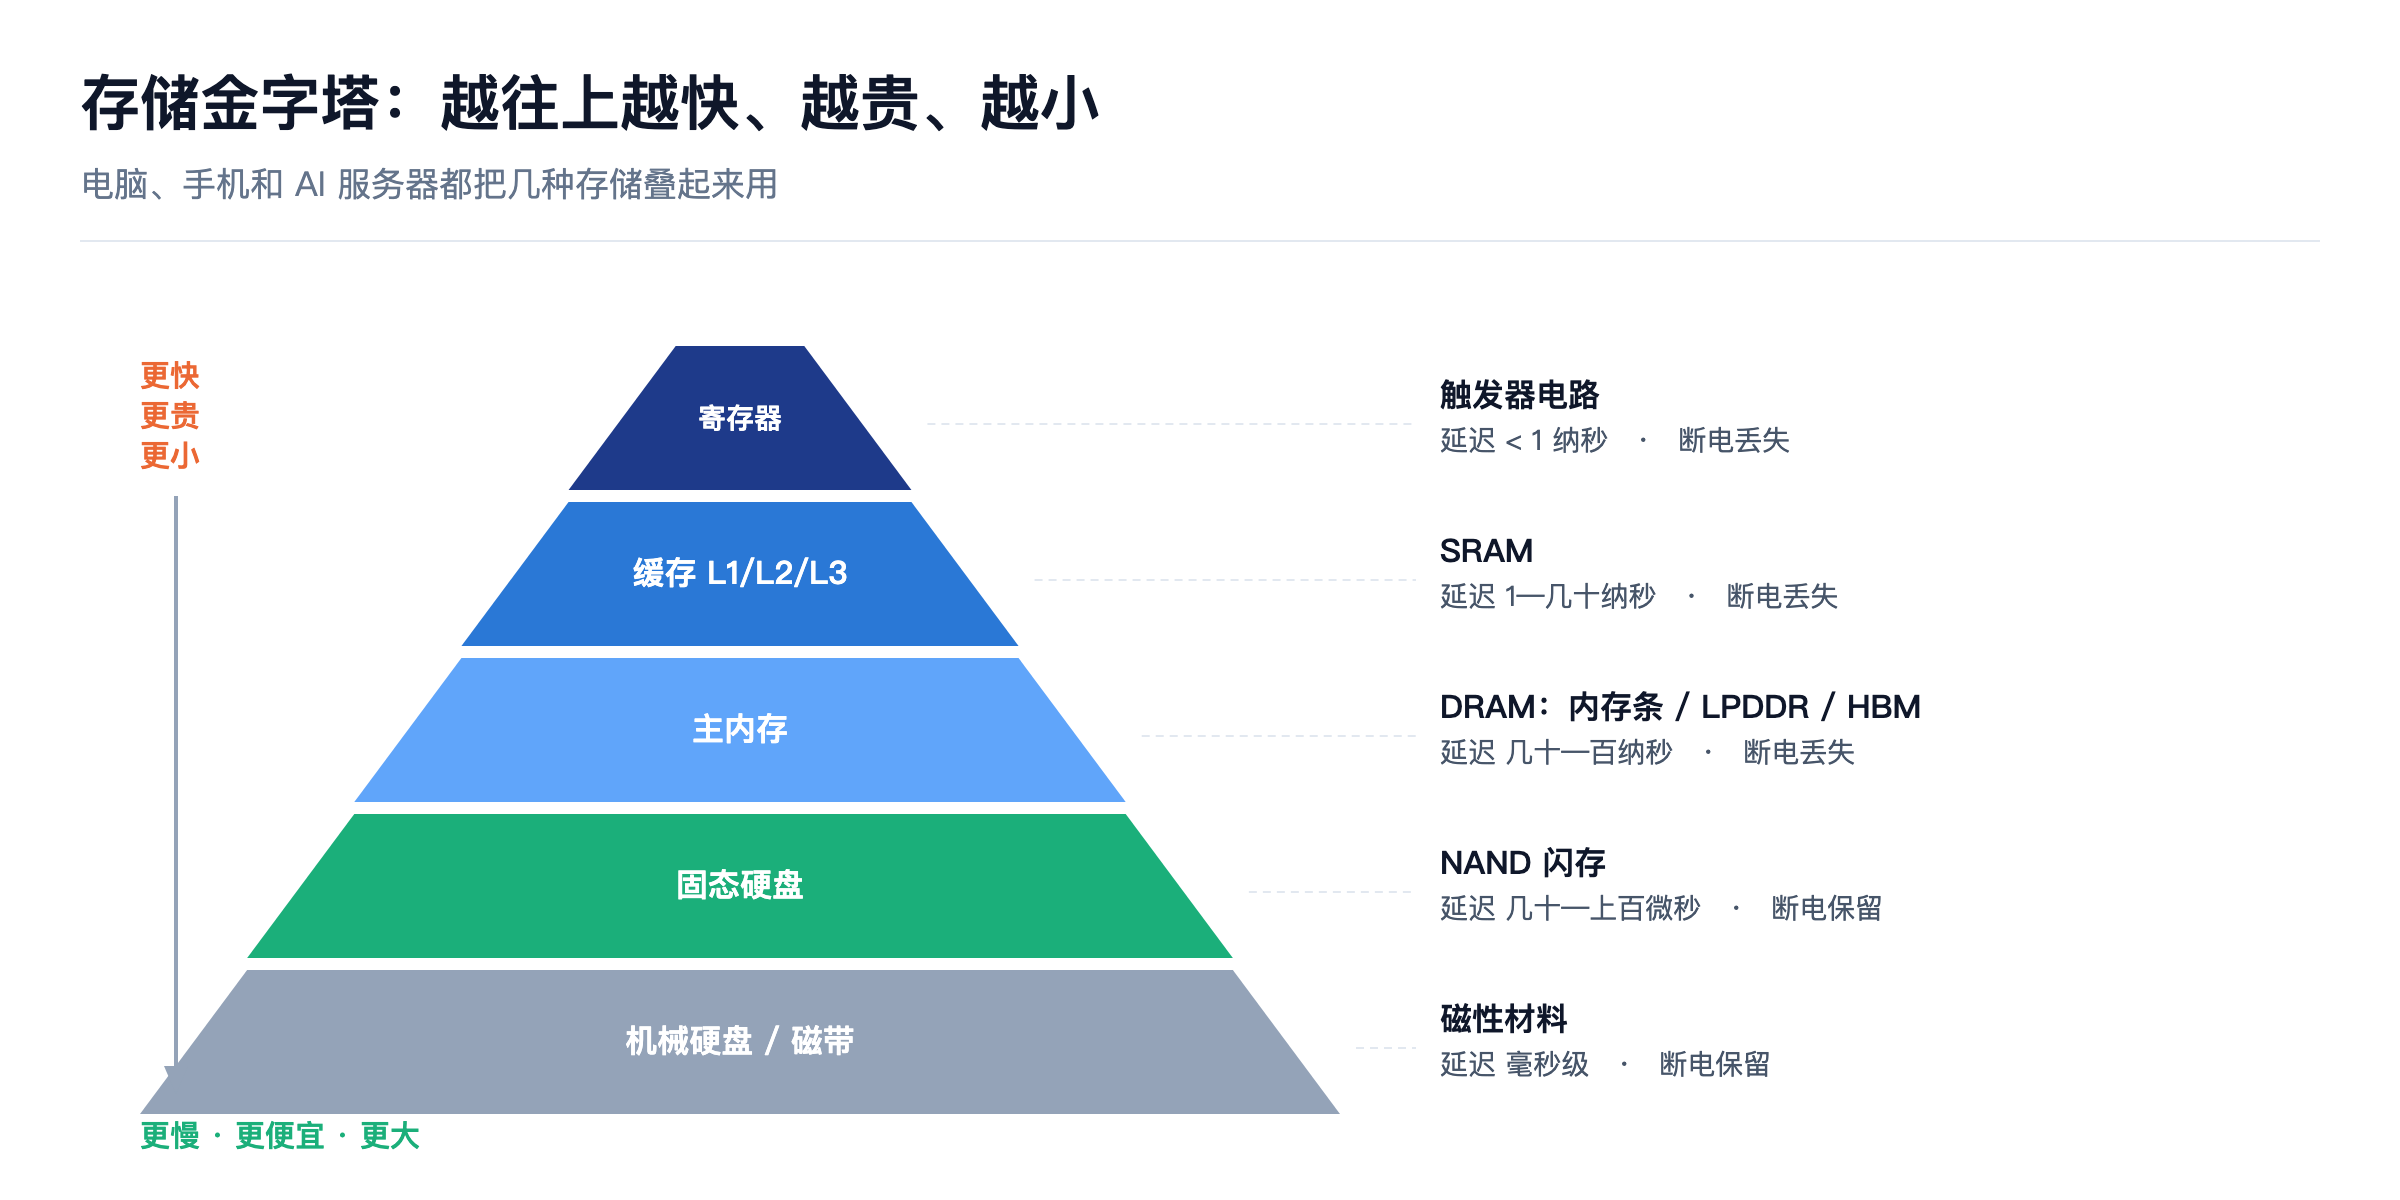
从上往下,存储越来越慢、越来越便宜、容量越来越大:
| 层级 | 用什么做 | 大致延迟 | 断电 | 在哪里 |
|---|---|---|---|---|
| 寄存器 | 触发器电路 | 不到 1 纳秒 | 丢 | CPU 内部 |
| 缓存(L1/L2/L3,Level 1/2/3 Cache) | SRAM | 1 到几十纳秒 | 丢 | CPU、GPU 芯片内部 |
| 主内存 | DRAM(内存条、LPDDR、HBM) | 约几十到一百纳秒 | 丢 | 内存条、GPU 旁边 |
| 固态硬盘 | NAND 闪存 | 几十到上百微秒 | 不丢 | SSD、手机存储 |
| 机械硬盘 / 磁带 | 磁性材料 | 毫秒级 | 不丢 | 数据中心冷存储 |
(延迟为大致数量级,因产品和使用方式而异;1 微秒 = 1,000 纳秒,1 毫秒 = 1,000 微秒。)
为什么要这样分层?因为 CPU 需要的数据,大部分时候集中在很小的一部分(这叫"局部性")。把最常用的一小部分放在最快的 SRAM 里,把正在处理的放在 DRAM 里,把所有文件放在便宜的 NAND 里——整个系统就能兼顾速度和成本。
一个生活化的比喻:寄存器是你手里正拿着的笔;缓存是桌面上摊开的几页纸;内存是身后的书架;硬盘是楼下的仓库。你不会把整个仓库搬到桌上,但最常用的东西一定要离手最近。
读懂后面电路图的钥匙:字线和位线
后面每一张电路图里都会出现两个词:字线和位线。先把它们讲清楚,后面的内容会好懂很多。
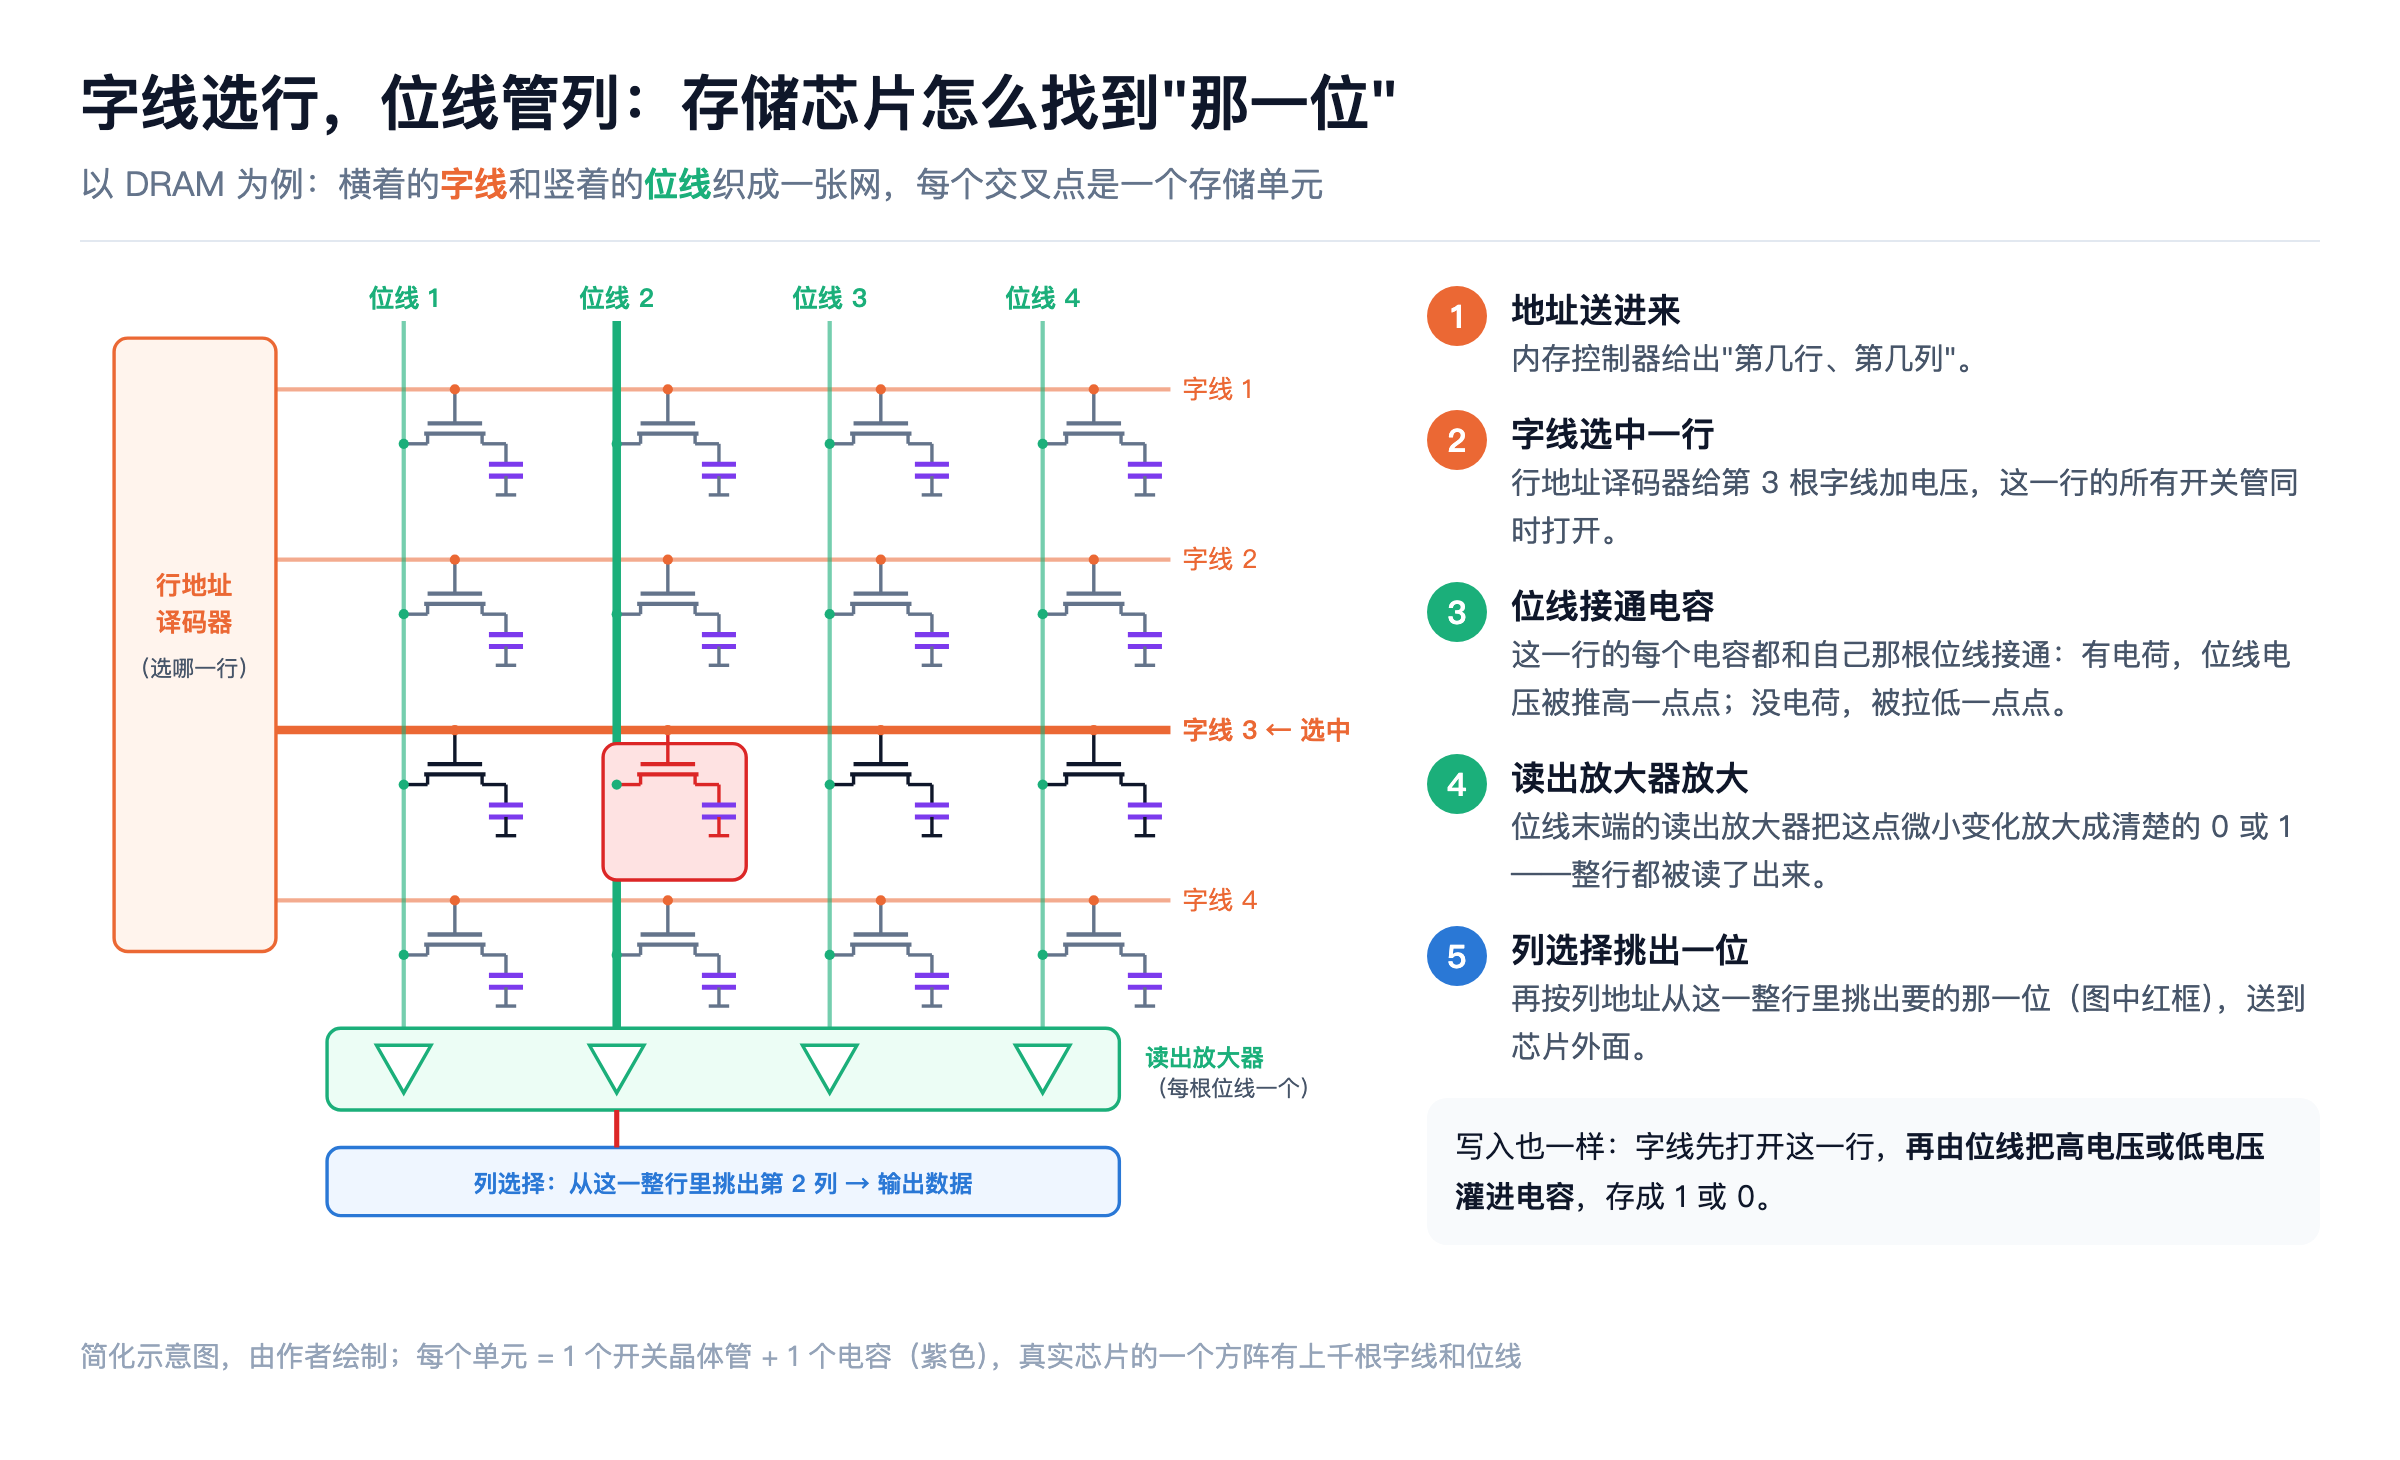
存储芯片里的存储单元,是排成方阵的。一颗内存芯片里有几十亿个单元,它们像棋盘上的格子一样横成行、竖成列,每个格子存 1 位数据。要找到其中某一个格子,就靠两组互相垂直的导线:
- 字线(Word Line)横着走:一根字线连着同一行所有单元的"开关"(晶体管的栅极)。给某根字线加上电压,这一整行的开关就同时打开——相当于"选中这一行";
- 位线(Bit Line)竖着走:一根位线连着同一列的所有单元。数据就是从位线上进出的:读的时候,单元里存的 0 或 1 通过位线传出来;写的时候,外面的数据通过位线灌进单元。
一行字线和一列位线交叉的地方,就是一个存储单元。就像在表格里找数据:字线决定"第几行",位线决定"第几列"。
以 DRAM 为例,读一位数据分五步(对照上图):
- 地址送进来:内存控制器告诉芯片"要第 3 行、第 2 列的数据";
- 字线选中一行:"行地址译码器"只给第 3 根字线加电压,这一行的所有开关管同时打开;
- 位线接通电容:这一行每个单元的电容,都和自己那一列的位线接通了。电容里有电荷,位线电压就被推高一点点;没有电荷,就被拉低一点点——这个变化非常微弱,因为单元里的电容极小,而位线很长、自身电容反而大得多;
- 读出放大器放大:每根位线末端都有一个"读出放大器",它把这点微弱变化放大成清楚的 0 或 1。注意,这时整整一行都被读了出来;
- 列选择挑出一位:最后按列地址,从这一整行里挑出要的那一位,送到芯片外面。
写入也是同样的路:字线先打开这一行的开关,再由位线把高电压(1)或低电压(0)灌进电容。
两个值得记住的细节:
- 为什么内存"按行"工作最快:字线一打开就是一整行,所以连续读同一行里的数据非常快;要换一行,就得先关掉当前这行、再打开另一行,要多等一段时间。内存条上标的时序参数(比如第七节提到的 CL,即 CAS Latency,列地址选通延迟),很多就是在描述这些等待;
- 为什么 DRAM 读完要"写回":第 3 步里电容把电荷分给了位线,原来的数据就被"读没了"。所以读出放大器在放大之后,还会顺手把数据重新写回这一行——这就是第三节说的"读取会破坏数据"。
后面的图里,字线和位线的角色都一样:SRAM 的"门卫"晶体管由字线打开,锁住的数据通过位线(和反位线)读写;NOR 闪存每个单元都直接接在位线上;NAND 闪存几十个单元串成一串,只在一头接到位线上。一句话:字线决定"选哪一行",位线负责"这一列的数据进出"。
二、SRAM:6 个晶体管,最快也最贵
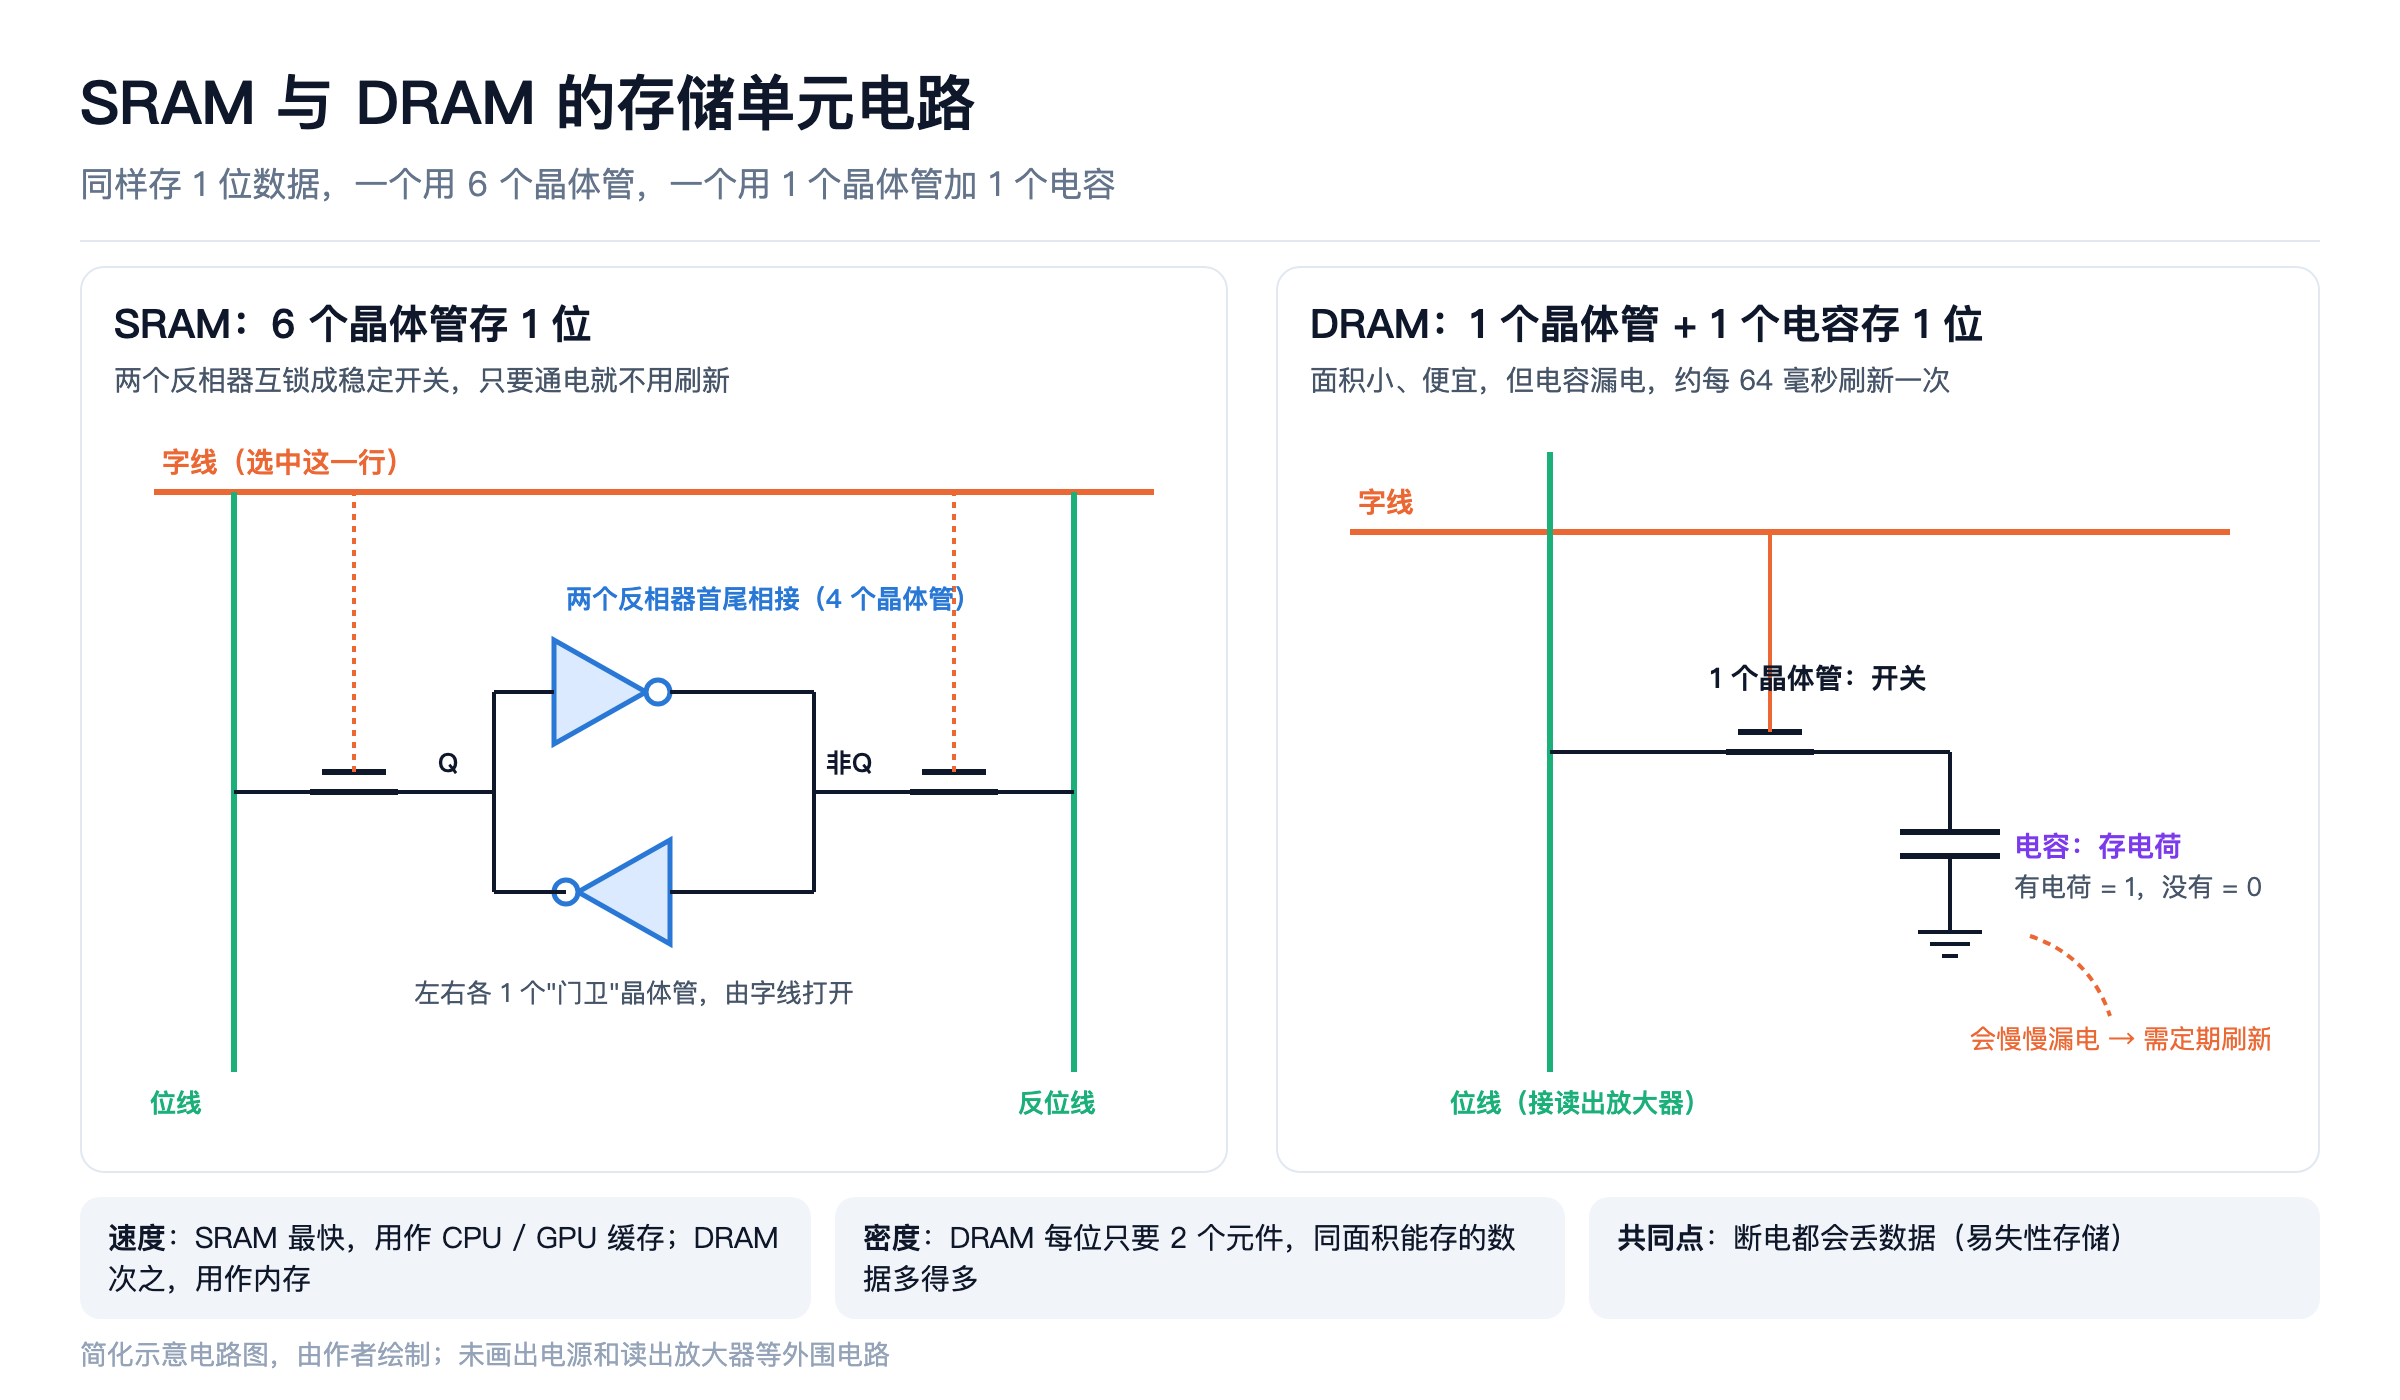
结构:一个 SRAM 单元用 6 个晶体管存 1 位数据。其中 4 个晶体管组成两个首尾相接的"反相器"——一个输出 1,另一个就输出 0,两者互相锁住,形成一个稳定的开关;另外 2 个晶体管是"门卫",由"字线"控制,决定什么时候让外面的"位线"读写这个开关。
如果你学过 RS 触发器:它就是 SRAM 的"祖先"
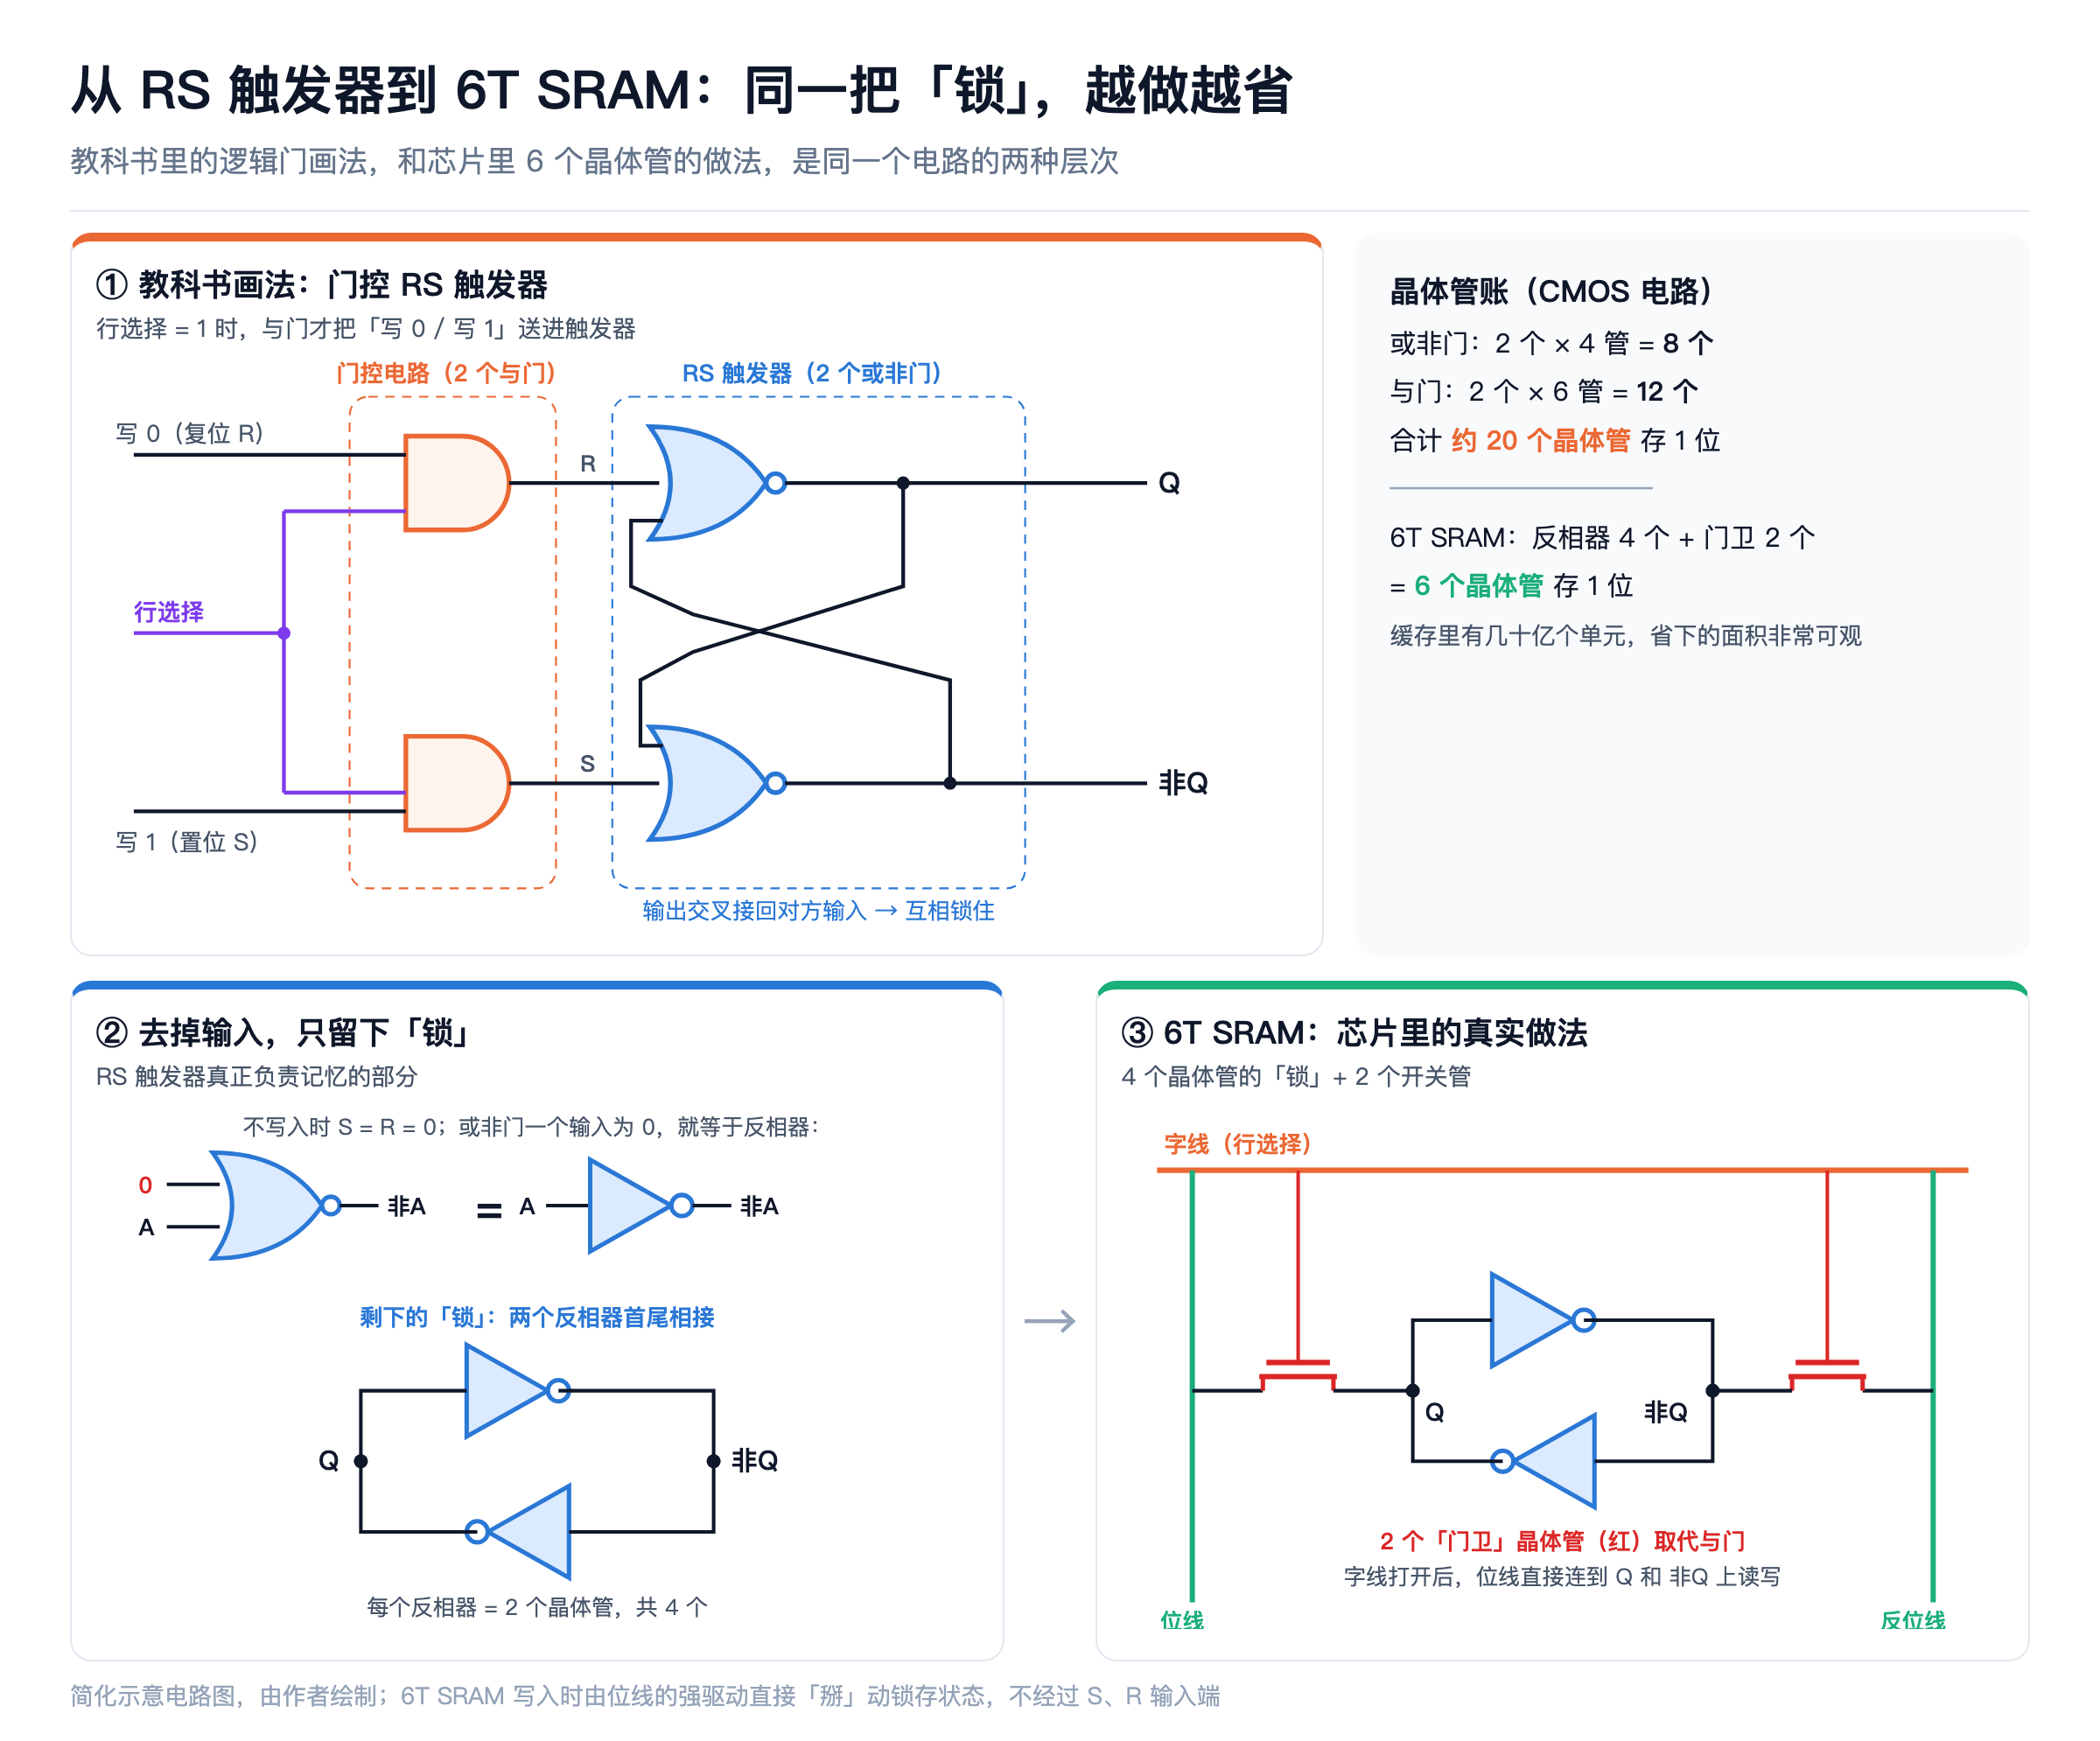
学过数字电路的读者,可能记得教科书里的存储单元是这样画的:一个 RS 触发器(RS,Reset-Set,复位-置位),前面加一组简单的门控电路。这个记忆没错,它和上面的 6 个晶体管其实是同一个电路,只是看的层次不同。可以分三步看它是怎么"瘦身"的:
第一步,教科书画法:门控 RS 触发器。两个"或非门"交叉相连:每个门的输出,接回另一个门的输入。结果是两个输出永远一个 0、一个 1,而且会互相"顶住",一直保持下去——这就是"记住"的来源。前面再加两个"与门"做门控:只有"行选择"信号为 1 时,"写 0"或"写 1"的指令才能送进触发器,其他时候触发器不受外界干扰。
第二步,去掉输入,只留下"锁"。不写入的时候,S 和 R 两个输入都是 0;而一个或非门只要有一个输入固定为 0,它的作用就等于一个"反相器"(输入 1 输出 0,输入 0 输出 1)。所以 RS 触发器里真正负责记忆的,就是两个首尾相接的反相器——正是 6T SRAM 中间那 4 个晶体管。
第三步,把门控电路换成 2 个开关管。芯片里不再用与门,而是在"锁"的两端各放 1 个"门卫"晶体管,由字线控制。字线打开后,位线直接连到 Q 和非Q 两个点上:读的时候看哪边是高电平;写的时候,由位线上更强的驱动电流直接把"锁"的状态"掰"过来,不需要单独的 S、R 输入端。
为什么芯片要这样省?按今天芯片通用的 CMOS(Complementary Metal-Oxide-Semiconductor,互补金属氧化物半导体)电路来数:两个或非门要 8 个晶体管,两个与门要 12 个,教科书版存 1 位约需 20 个晶体管,而 6T SRAM 只要 6 个。一颗处理器的缓存里有几十亿个这样的单元,每个少用十几个晶体管,省下的面积非常可观。
一句话:6T SRAM 就是把 RS 触发器精简到只剩"锁",再把门控电路换成两个开关管。
特点:
- 快:不需要充放电容,读写几乎和逻辑电路一样快,所以用来做 CPU 和 GPU 的缓存;
- 不用刷新:只要通电,这个"互锁开关"就会一直保持状态,这就是"静态"的意思;
- 贵、占面积:6 个晶体管存 1 位,同样面积能存的数据量,远少于 DRAM;
- 断电即丢。
在 AI 里的角色:一颗 GPU 芯片里的 SRAM 通常只有几十到几百 MB,却是速度最快的一层。一些推理芯片(如 Groq 的 LPU(Language Processing Unit,语言处理单元)、Cerebras 的晶圆级芯片)的思路,就是把大量 SRAM 直接放在计算单元旁边,减少来回搬数据的时间——我在光通信那篇和 IEEE(Institute of Electrical and Electronics Engineers,电气电子工程师学会)推理归纳里讲过。
SRAM 是不是越做越大了?
是的,芯片里的 SRAM 总量确实在变大,但主要不是靠把单元做小实现的。
1. 总量在涨。英伟达(NVDA)GPU 的二级缓存从 A100 的 40MB 增加到 H100 的 50MB;AMD(AMD)的 MI300X 加速器配有 256MB 的 Infinity Cache(无限缓存,AMD 给自家大容量缓存起的名字);专门做推理的芯片更激进,Groq 一颗芯片约 230MB SRAM,Cerebras 的晶圆级芯片 WSE-3(WSE,Wafer-Scale Engine,晶圆级引擎)有 44GB SRAM。
2. 但 SRAM 单元几乎缩不动了。这是业内公认的大问题:逻辑电路每换一代工艺还能明显缩小,SRAM 单元却基本停滞。台积电(TSM)3 纳米(N3E)的 SRAM 单元面积约 0.021 平方微米,和 5 纳米几乎一样,到 2 纳米才略有缩小。SRAM 在芯片上占的面积,越来越"贵"。
3. 于是厂商用别的办法塞进更多 SRAM:
- 把芯片做大,或用多颗芯粒拼起来:面积大了,自然装得多;
- 把 SRAM 叠在上面:AMD 的 3D V-Cache(3D 垂直缓存)在计算芯片上再叠一层 64MB 缓存,锐龙 9800X3D 的三级缓存因此达到 96MB,服务器版 EPYC(霄龙)处理器可以超过 1GB;
- 把缓存放到下面的芯片里:MI300 系列就是把大缓存做在底层芯片里,计算芯片叠在它上面。
4. SRAM 再大,也替代不了 HBM。一颗 GPU 片上的 SRAM 是几十到几百 MB,而 HBM 是几十到近两百 GB,差了上千倍。原因还是本节开头那条:SRAM 一个位要 6 个晶体管,DRAM 只要 1 个晶体管加 1 个电容,同样面积 SRAM 存得少得多、也贵得多。所以 SRAM 只能放最常用的数据,大模型的主体仍然得放在 HBM 里。
一句话:SRAM 在变多,但单元不再缩小,所以只能靠叠层和把芯片做大;它越难扩容,HBM 就越重要。第十节会讲一种反其道而行的芯片:Groq 的 LPU。
三、DRAM:1 个晶体管 + 1 个电容,便宜但"健忘"
结构:一个 DRAM 单元只用 1 个晶体管加 1 个电容(简称 1T1C)。电容里有电荷代表"1",没有代表"0";晶体管是开关,由字线控制,打开时电容和位线接通,就能读写。
为什么叫"动态"?因为电容会漏电。电荷几十毫秒就会漏掉一部分,所以控制器必须定期把每个单元读出来、再按原样写回去,这叫"刷新"。按行业标准,一般每 64 毫秒要把所有单元刷新一遍(高温下更频繁)。
读取还会"破坏"数据。电容里的电荷很少,读的时候要把它分享到位线上,再由"读出放大器"放大判断是 0 还是 1——读完之后电容的电荷已经被放掉了,必须马上写回去。
特点:
- 便宜、密度高:1 个晶体管 + 1 个电容,比 SRAM 的 6 个晶体管省得多;
- 比 SRAM 慢,但比闪存快几个数量级;
- 要刷新、断电即丢。
DRAM 的难点在"电容"。芯片越做越小,电容也要越做越小,但它必须存下足够的电荷才能被可靠读出。所以 DRAM 电容越做越"高"、越做越"深",工艺上越来越难,这也是 DRAM 的制程进步比逻辑芯片慢的原因之一。
全球 DRAM 市场主要由三家公司占据:韩国的三星、SK 海力士(SK Hynix,韩国 SK 集团旗下),和美国的美光(MU);中国的长鑫存储在快速追赶。
四、从 ROM 到 EEPROM:断电不丢的秘密
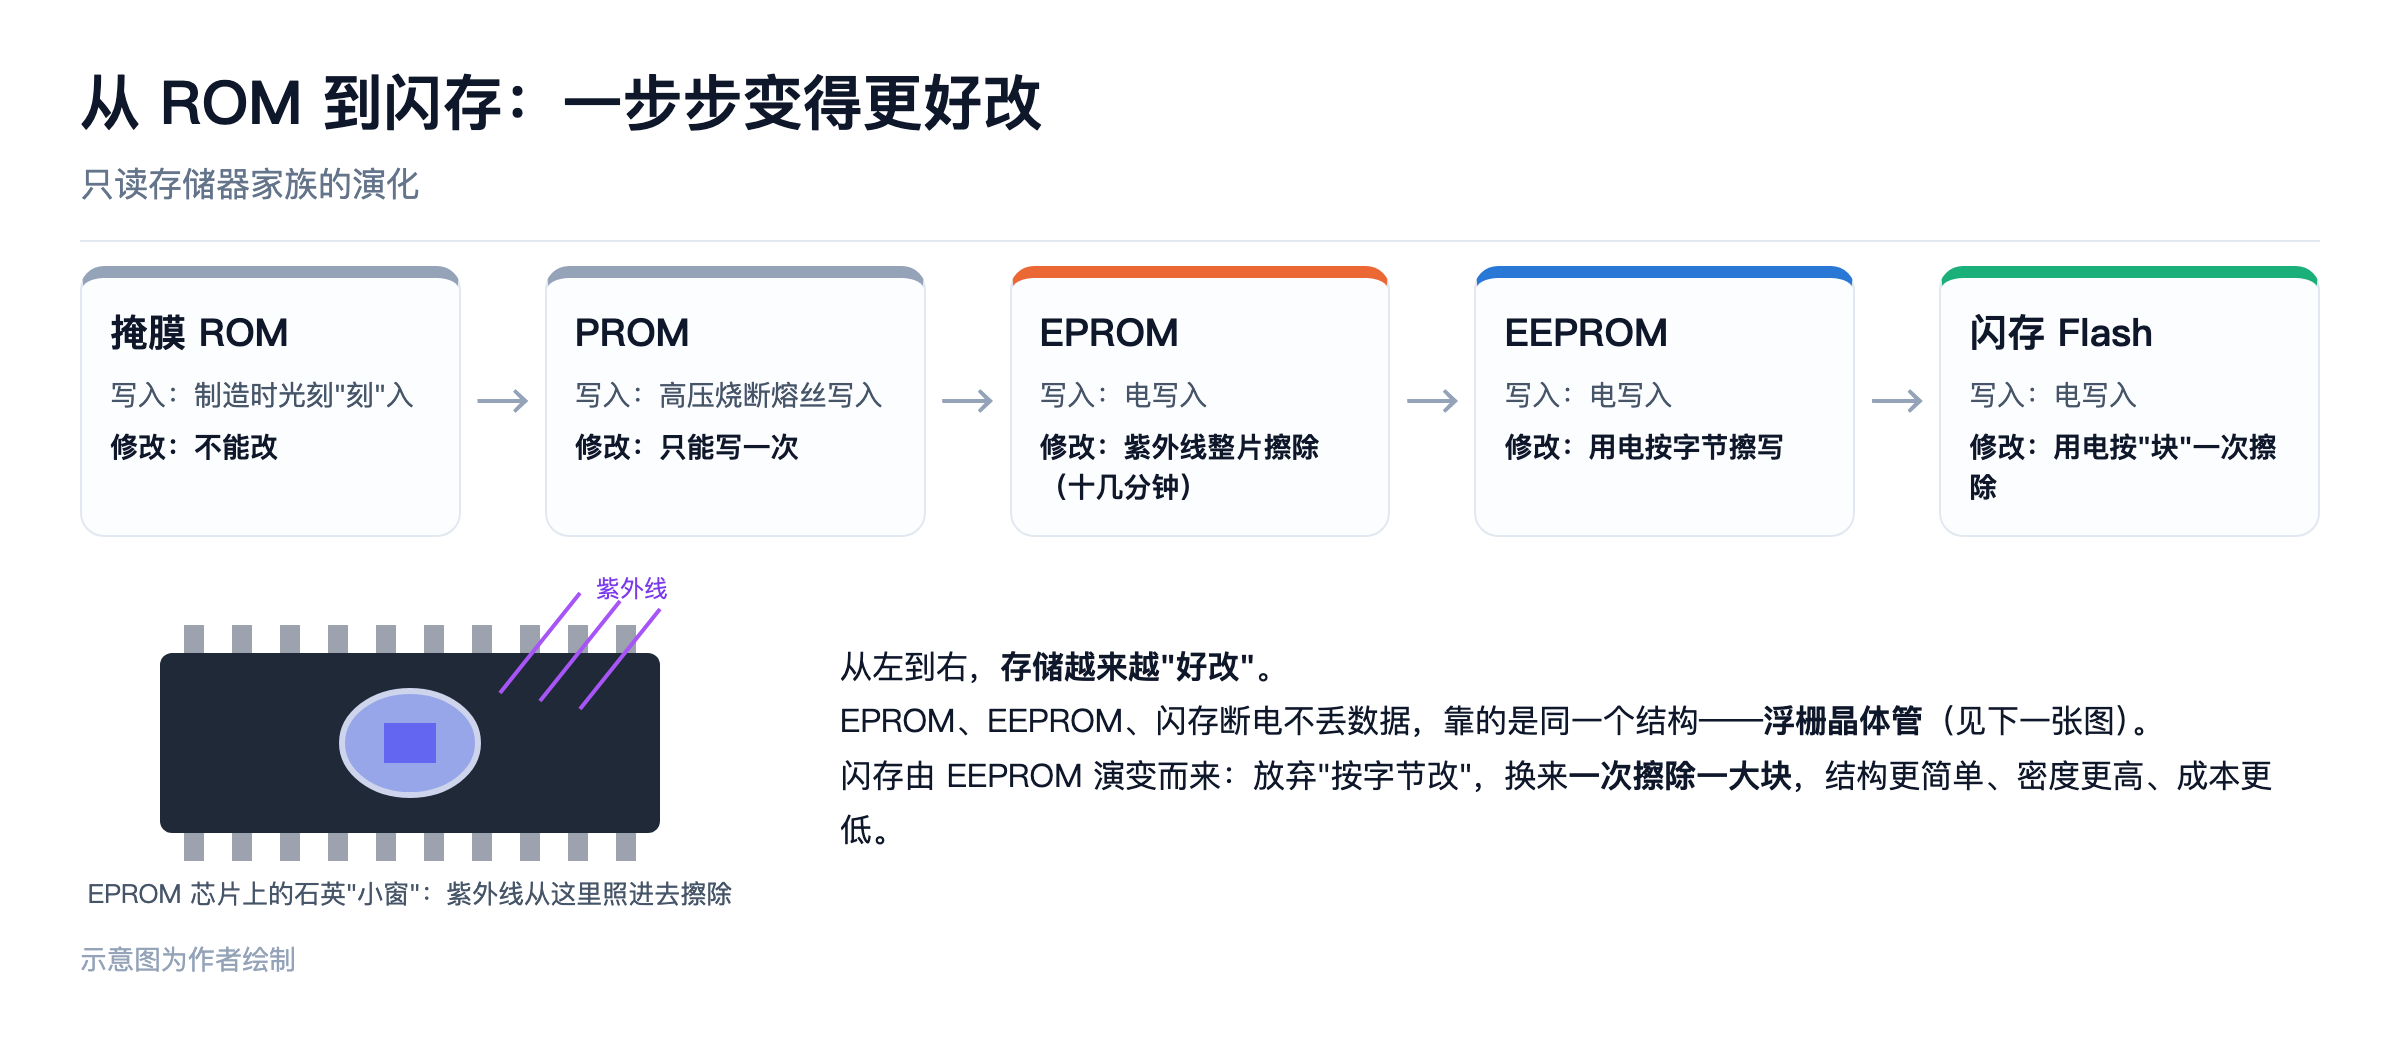
ROM 家族的演化,就是一部"越来越好改"的历史:
| 类型 | 怎么写入 | 能不能改 | 典型用途 |
|---|---|---|---|
| 掩膜 ROM | 芯片制造时用光刻直接"刻"进去 | 不能改 | 早期游戏卡带、大批量固定程序 |
| PROM | 用户用高电压烧断内部的熔丝 | 只能写一次 | 小批量的固定程序 |
| EPROM | 电写入 | 用紫外线照射整片擦除,擦除要十几分钟 | 早期电脑的 BIOS(Basic Input/Output System,基本输入输出系统) |
| EEPROM | 电写入 | 用电擦除,可以按字节修改 | 保存少量设置、校准数据、银行卡芯片 |
| 闪存(Flash) | 电写入 | 用电按"块"一次性擦除 | 固件、U 盘、SSD、手机存储 |
EPROM 有个很容易认出来的特征:芯片上有一扇透明的石英"小窗",紫外线从这里照进去擦除数据;平时要贴上标签挡光。
关键原理:浮栅晶体管
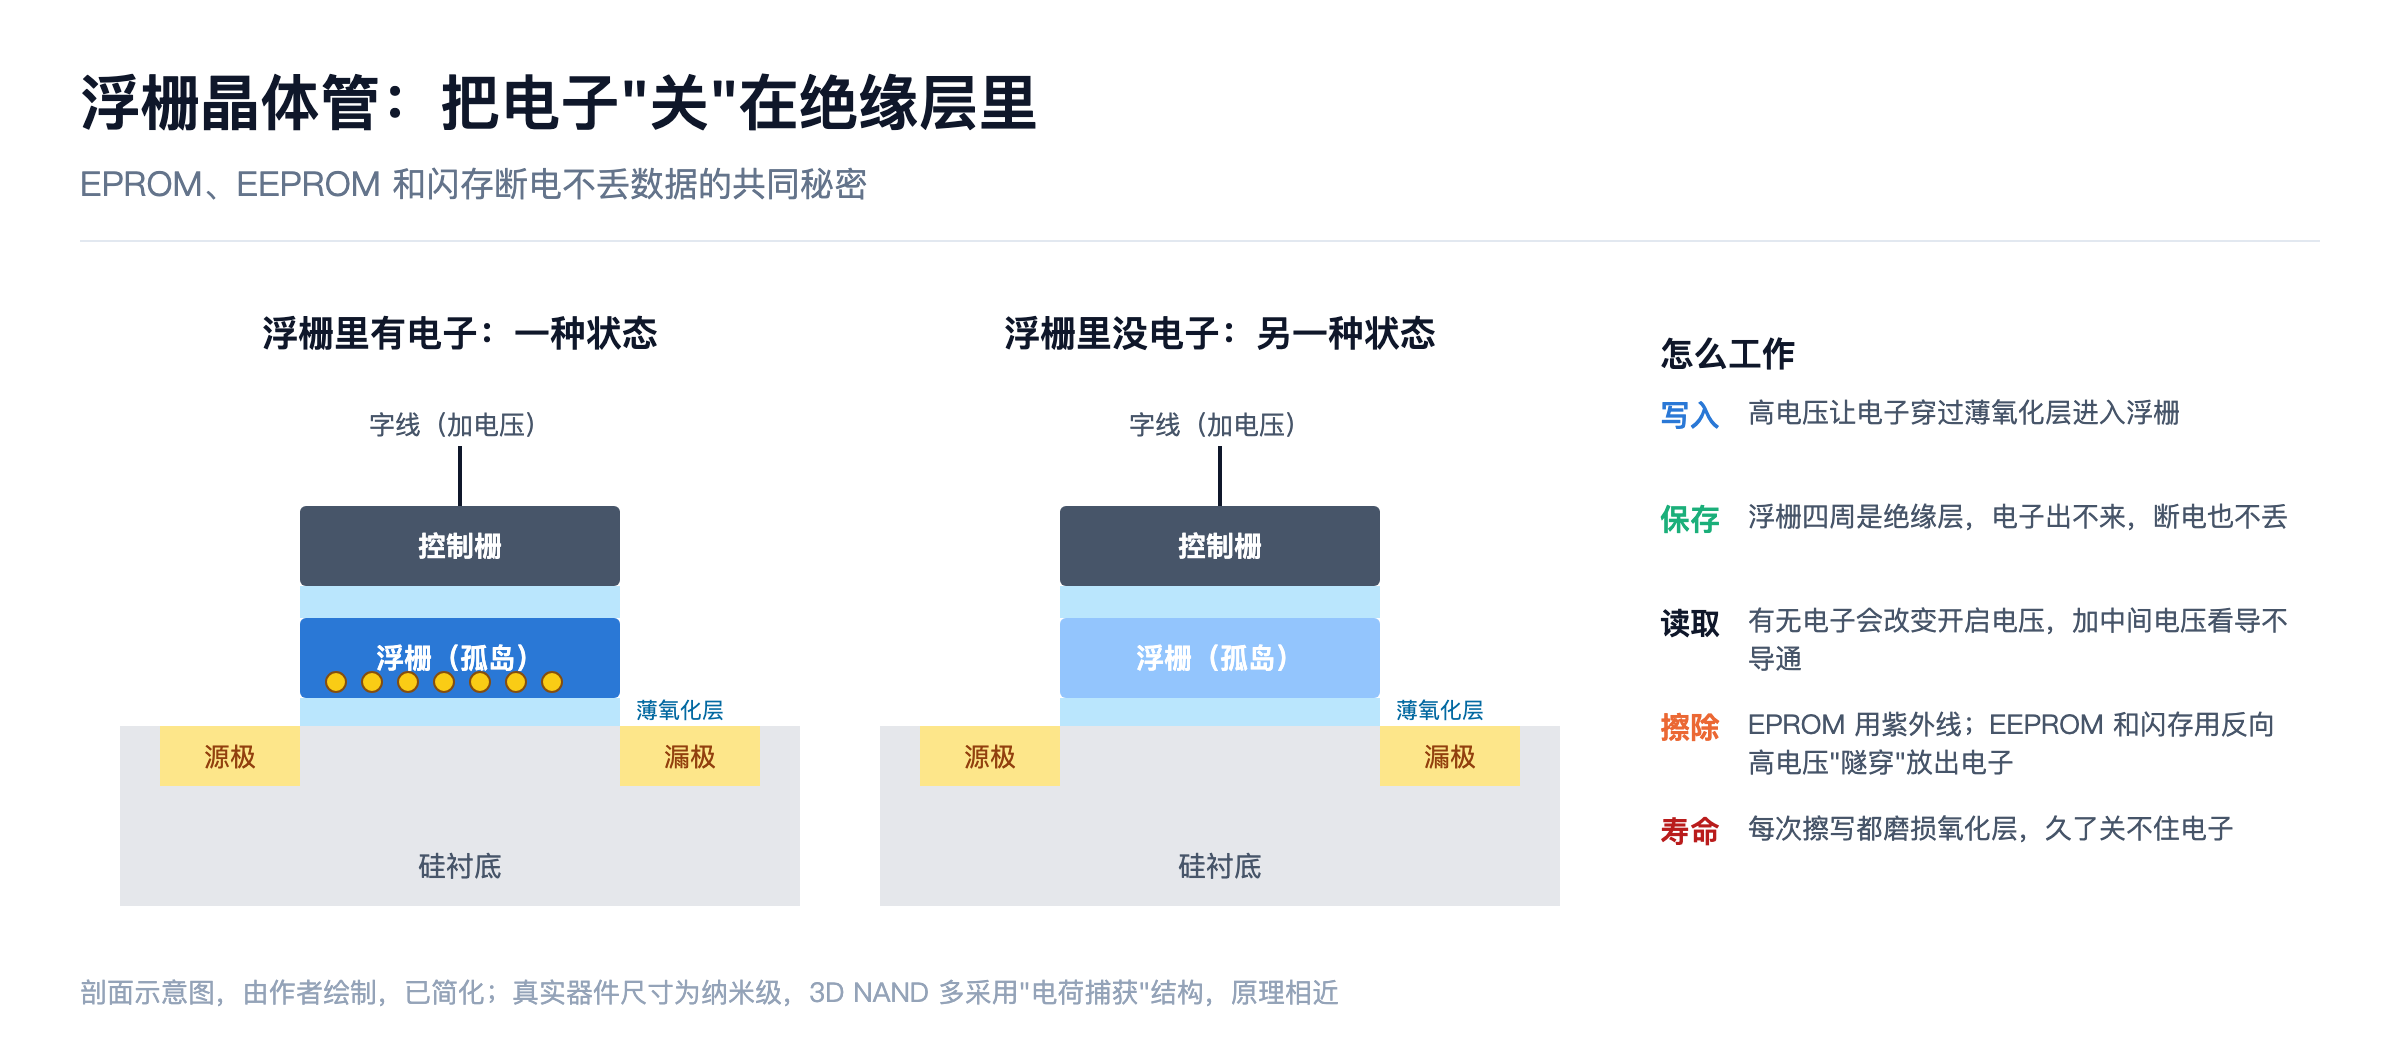
EPROM、EEPROM、闪存能"断电不丢",靠的是同一个结构:浮栅晶体管。
普通晶体管只有一个"栅极"用来控制开关。浮栅晶体管在控制栅下面,多加了一层四周被绝缘层(氧化层)完全包住的"浮栅"——它不接任何导线,是一座"孤岛"。
- 写入(编程):加高电压,让电子穿过很薄的绝缘层进入浮栅,然后被困在里面;
- 保存:电子被绝缘层包围,出不来,断电之后仍然留在里面,可以保存很多年;
- 读取:浮栅里有没有电子,会改变晶体管"开启"所需的电压。读的时候加一个中间电压,看晶体管导不导通,就知道存的是 0 还是 1;
- 擦除:EPROM 用紫外线给电子能量让它逃出来;EEPROM 和闪存则加反向高电压,让电子通过"隧穿效应"穿过绝缘层离开。
这个结构也带来了闪存的"寿命"问题:每次写入和擦除,电子都要穿过绝缘层,时间久了绝缘层会被"磨损",关不住电子,这个单元就坏了。这就是"擦写寿命"的来源。
一个小历史:闪存是日本东芝的工程师舛冈富士雄在 1980 年代发明的;名字里的"闪",是因为它可以像相机闪光灯一样,一下子把一大块数据擦掉。
五、闪存的两条路:NOR 和 NAND
先说清楚:"单元"到底是什么
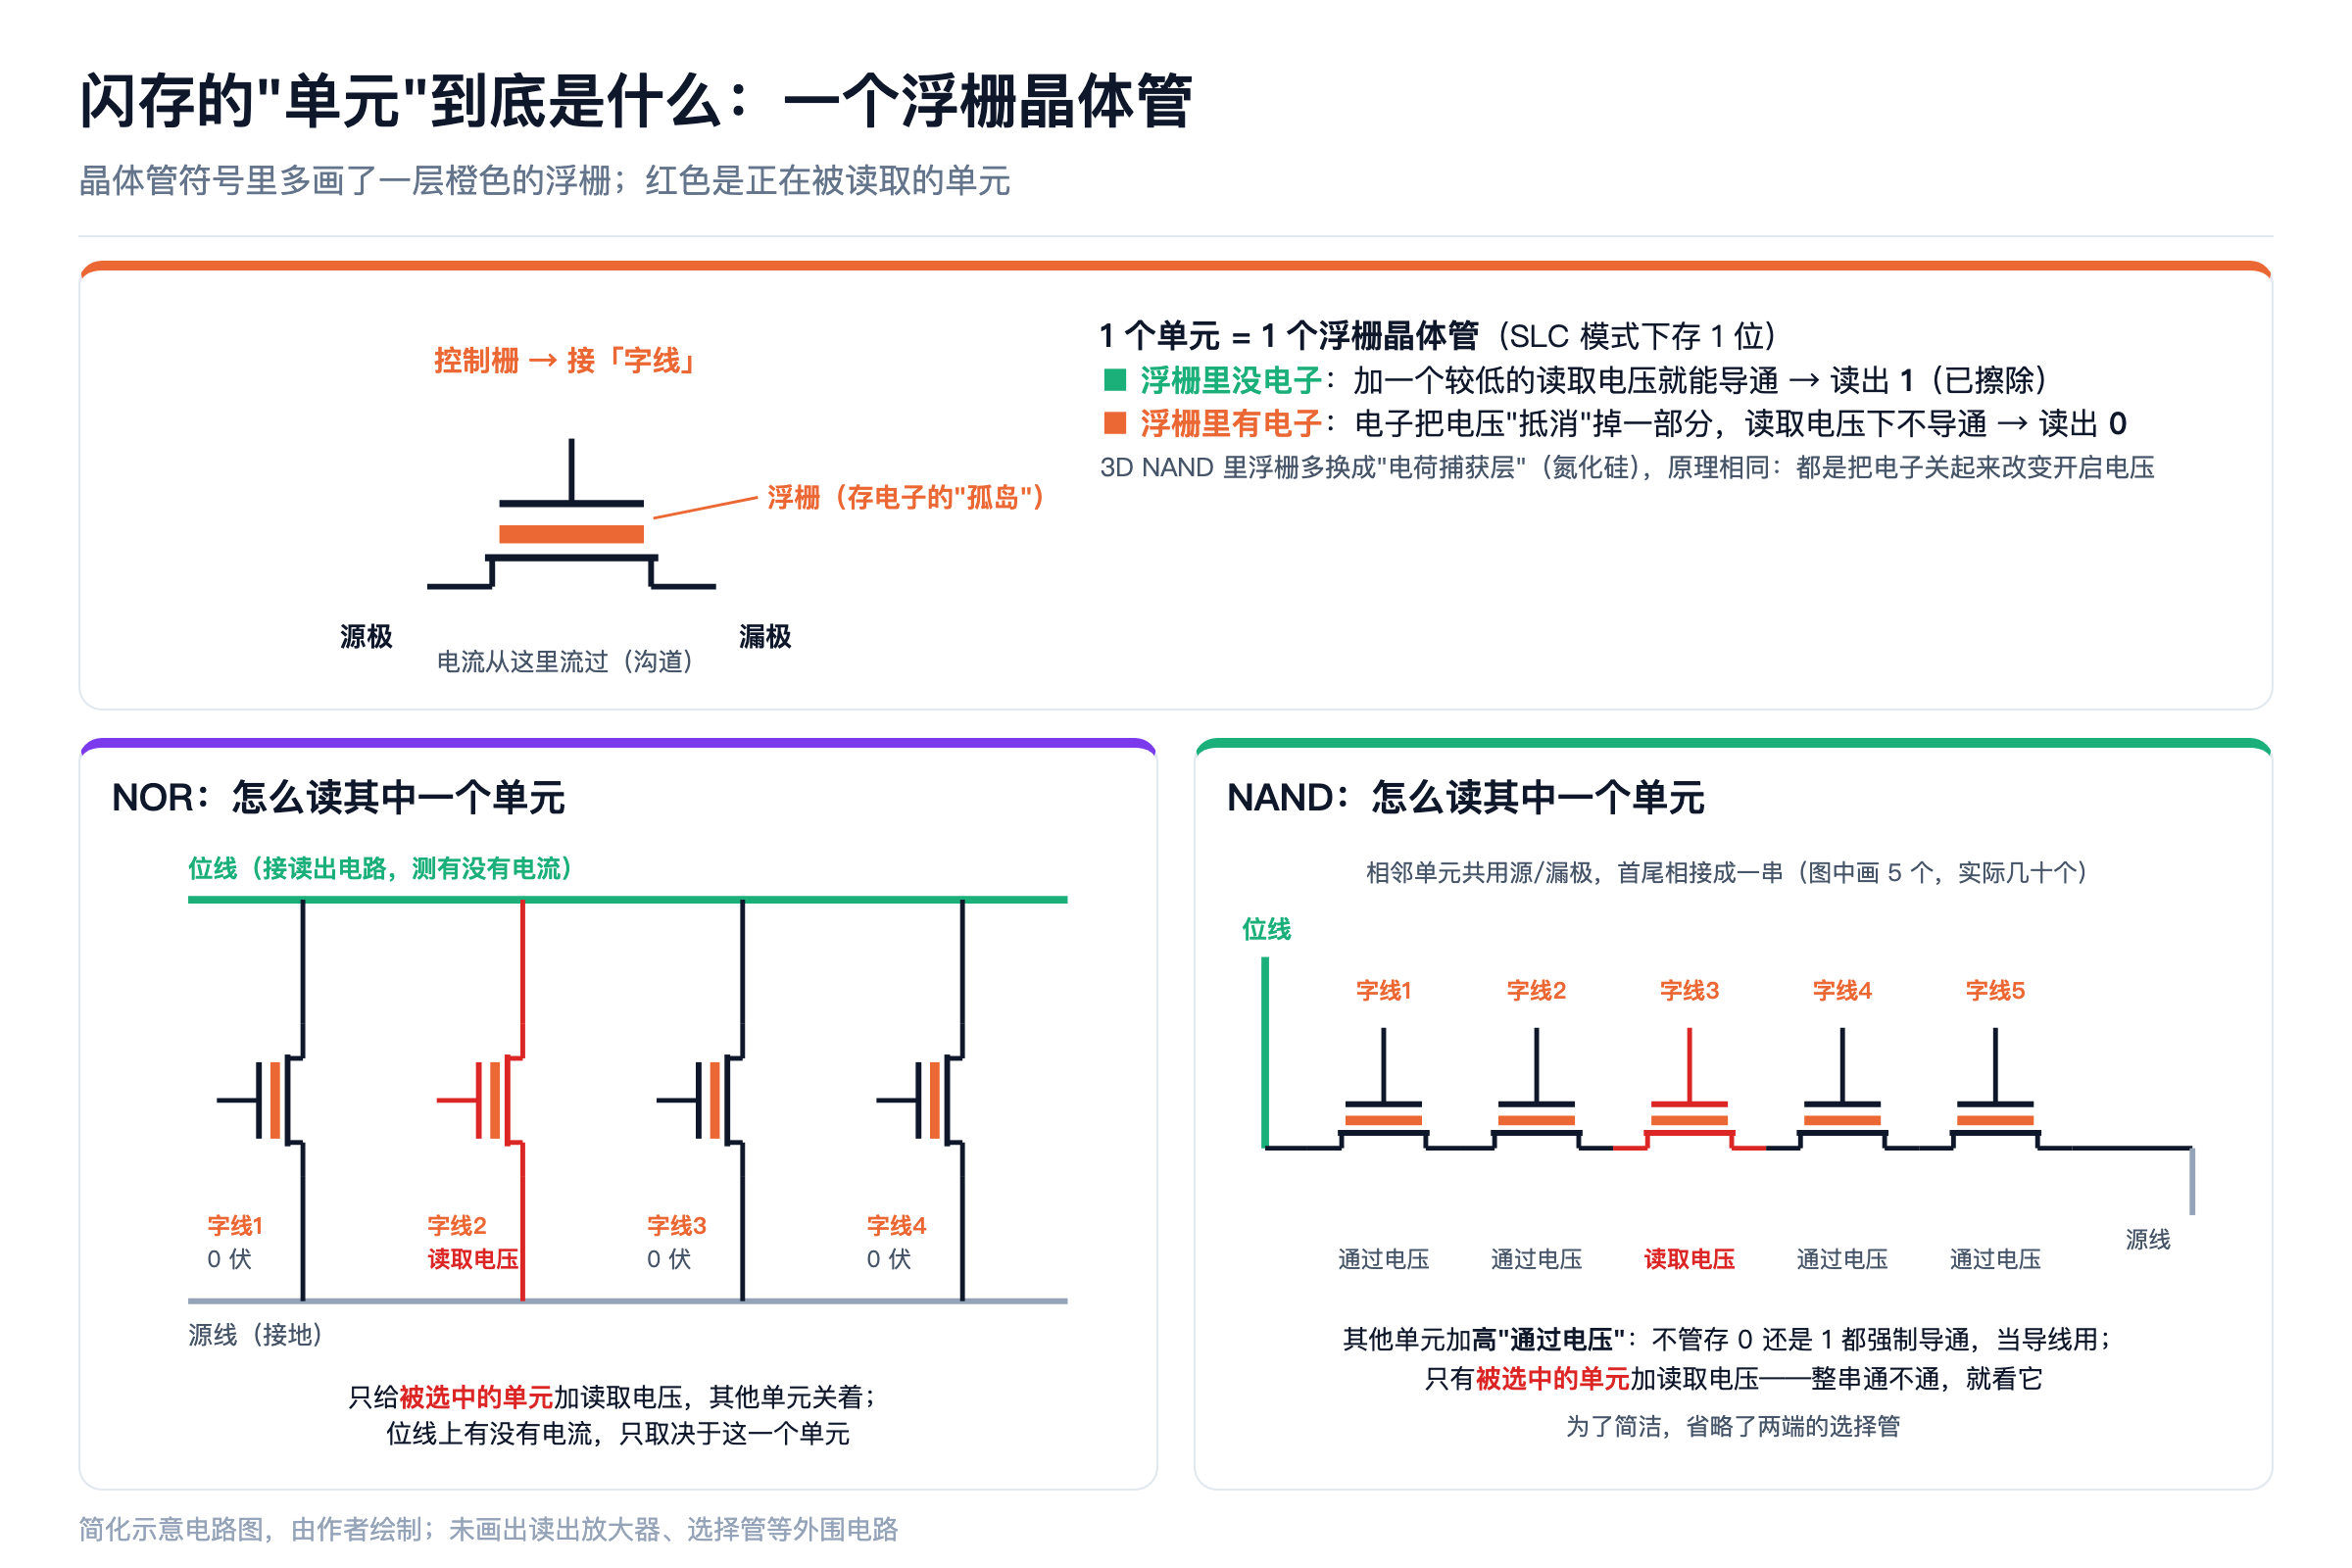
这一节反复说的"存储单元"(Memory Cell),在闪存里就是上一节讲的那个浮栅晶体管——一个单元就是一个晶体管。一块 1TB 的固态硬盘里,按每个单元存 3 位(TLC)算,大约有 3 万亿个这样的晶体管。
一个单元有三个"接头":
- 控制栅:晶体管顶上的"开关把手",接到一根横向的导线上,这根线叫字线(Word Line)。给字线加电压,就是在"拧"这个开关;
- 漏极和源极:晶体管两端的进出口。电流从一端流进、另一端流出,中间那段通道叫"沟道"。一端最终接到位线(Bit Line,负责把数据读出来的线),另一端接到源线(接地的回路);
- 浮栅:夹在控制栅和沟道之间、被绝缘层包住的"孤岛",这是存数据的地方。
一个单元怎么表示 0 和 1?
- 浮栅里没有电子:在字线上加一个不太高的"读取电压",晶体管就能导通,位线上有电流 → 读出 1(这是擦除后的状态);
- 浮栅里有电子:电子带负电,会把控制栅的电压"抵消"掉一部分,同样的读取电压下晶体管打不开,位线上没有电流 → 读出 0(这是写入后的状态)。
换句话说,读闪存就是在问每个晶体管一句话:加这个电压,你开不开?第六节讲的"一格多存",就是把浮栅里的电子数量分成 4 档、8 档、16 档,再用几个不同的读取电压去试,看它在哪一档打开。
补充一点:现在的 3D NAND 大多把浮栅换成了"电荷捕获层"(用氮化硅做的一层绝缘材料,电子被困在材料里而不是导体孤岛里),更适合竖着堆叠。原理完全一样:都是把电子关起来,改变晶体管的开启电压。
NOR 和 NAND:同样的单元,两种连法
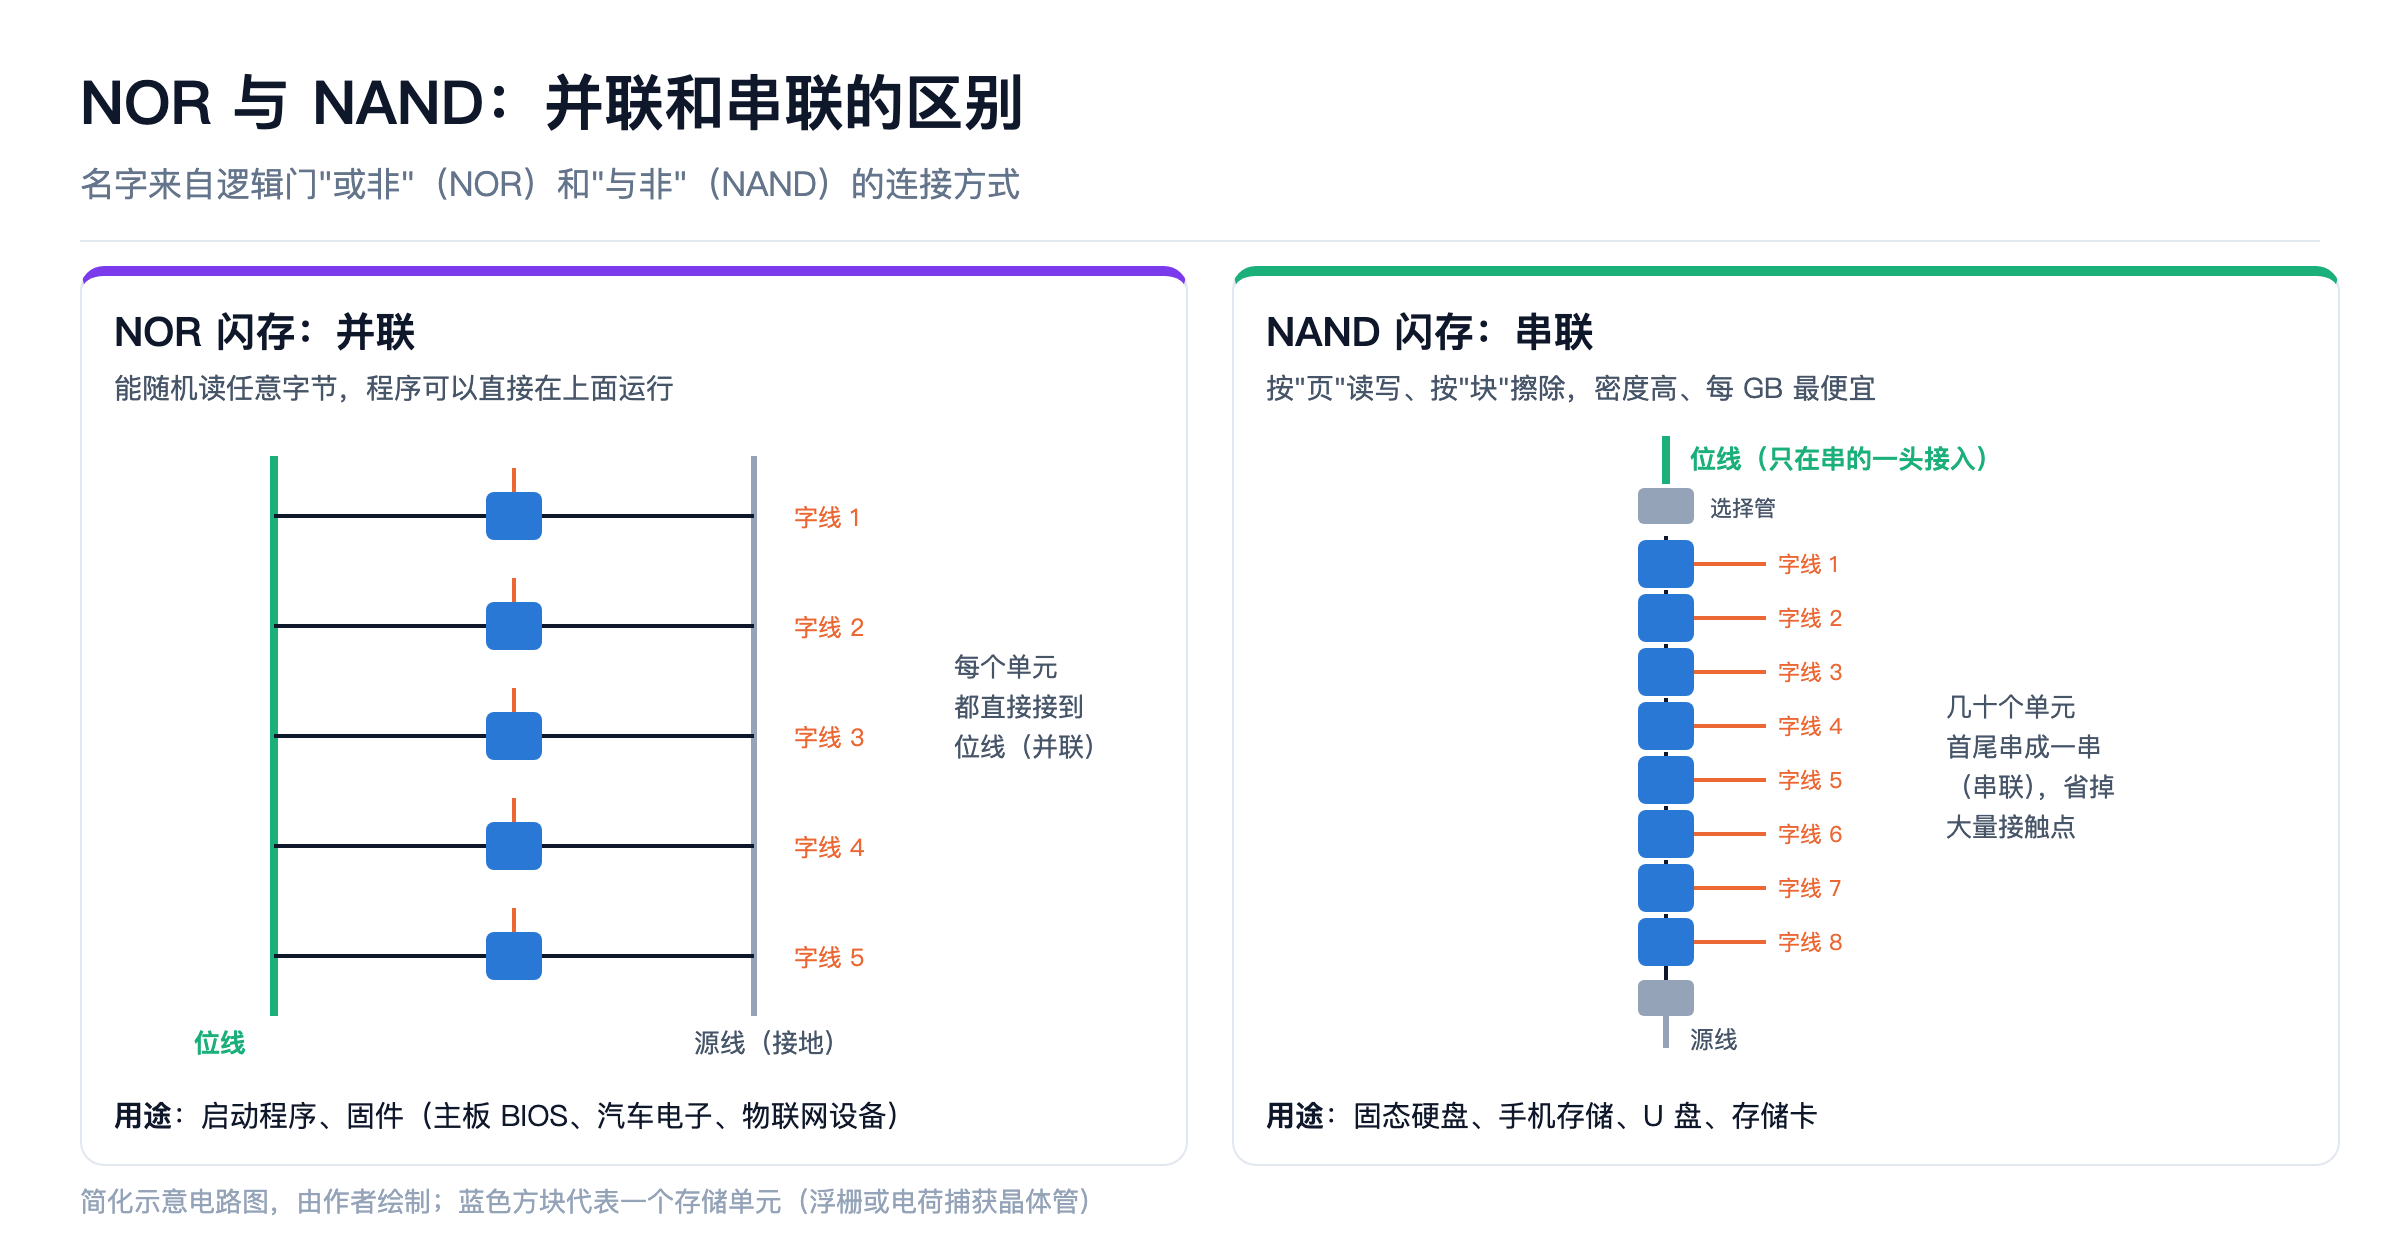
NOR 和 NAND 用的是同样的单元,区别只在单元之间怎么连,这直接决定了"怎么读其中一个单元":
- NOR(并联):每个单元一头接位线、一头接源线,彼此并排。读某个单元时,只给它的字线加读取电压,其他字线加 0 伏让它们全部关着。位线上有没有电流,只取决于这一个单元,所以可以随机读任意位置,又快又直接;
- NAND(串联):几十个单元首尾相接成一串,相邻两个单元共用源极和漏极,整串只有两头接到位线和源线。要读中间某一个,怎么办?给其他所有单元的字线加一个较高的"通过电压",不管它们存的是 0 还是 1,都强制打开、当导线用;只给被选中的单元加读取电压。整串导不导通,就只看这一个单元了。
NAND 的这个办法省掉了每个单元单独接位线的接触点,所以密度高、便宜;代价是每次都要"绕一整串"去读,只能成批按页读写。
闪存按电路排法分成两种,差别在于存储单元是"并联"还是"串联":
| NOR 闪存 | NAND 闪存 | |
|---|---|---|
| 单元连接方式 | 每个单元都直接连到位线上(并联) | 几十个单元串成一串,只有两头接到外面(串联) |
| 读取 | 可以随机读任意一个字节,速度快,程序可以直接在上面运行 | 按"页"读取,一页通常几千到十几千字节 |
| 写入和擦除 | 慢 | 按"页"写入、按"块"擦除,一块包含几百页 |
| 密度和成本 | 密度低、每 GB 贵 | 密度高、每 GB 便宜 |
| 典型用途 | 存放启动程序、固件(如主板 BIOS、汽车电子、物联网设备) | SSD、手机存储、U 盘、存储卡 |
为什么 NAND 更便宜?因为串联省掉了大量连线和接触点,同样面积能塞进多得多的单元。代价是不能随机改一个字节:想改一页里的一点数据,要先把整块擦掉再重写。所以 SSD 里都有一颗"主控芯片",负责把写入分散到不同位置("磨损均衡")、回收垃圾空间、纠错——这颗主控,决定了一块 SSD 的速度和寿命。
六、NAND 的两招:一格多存,和往上盖楼
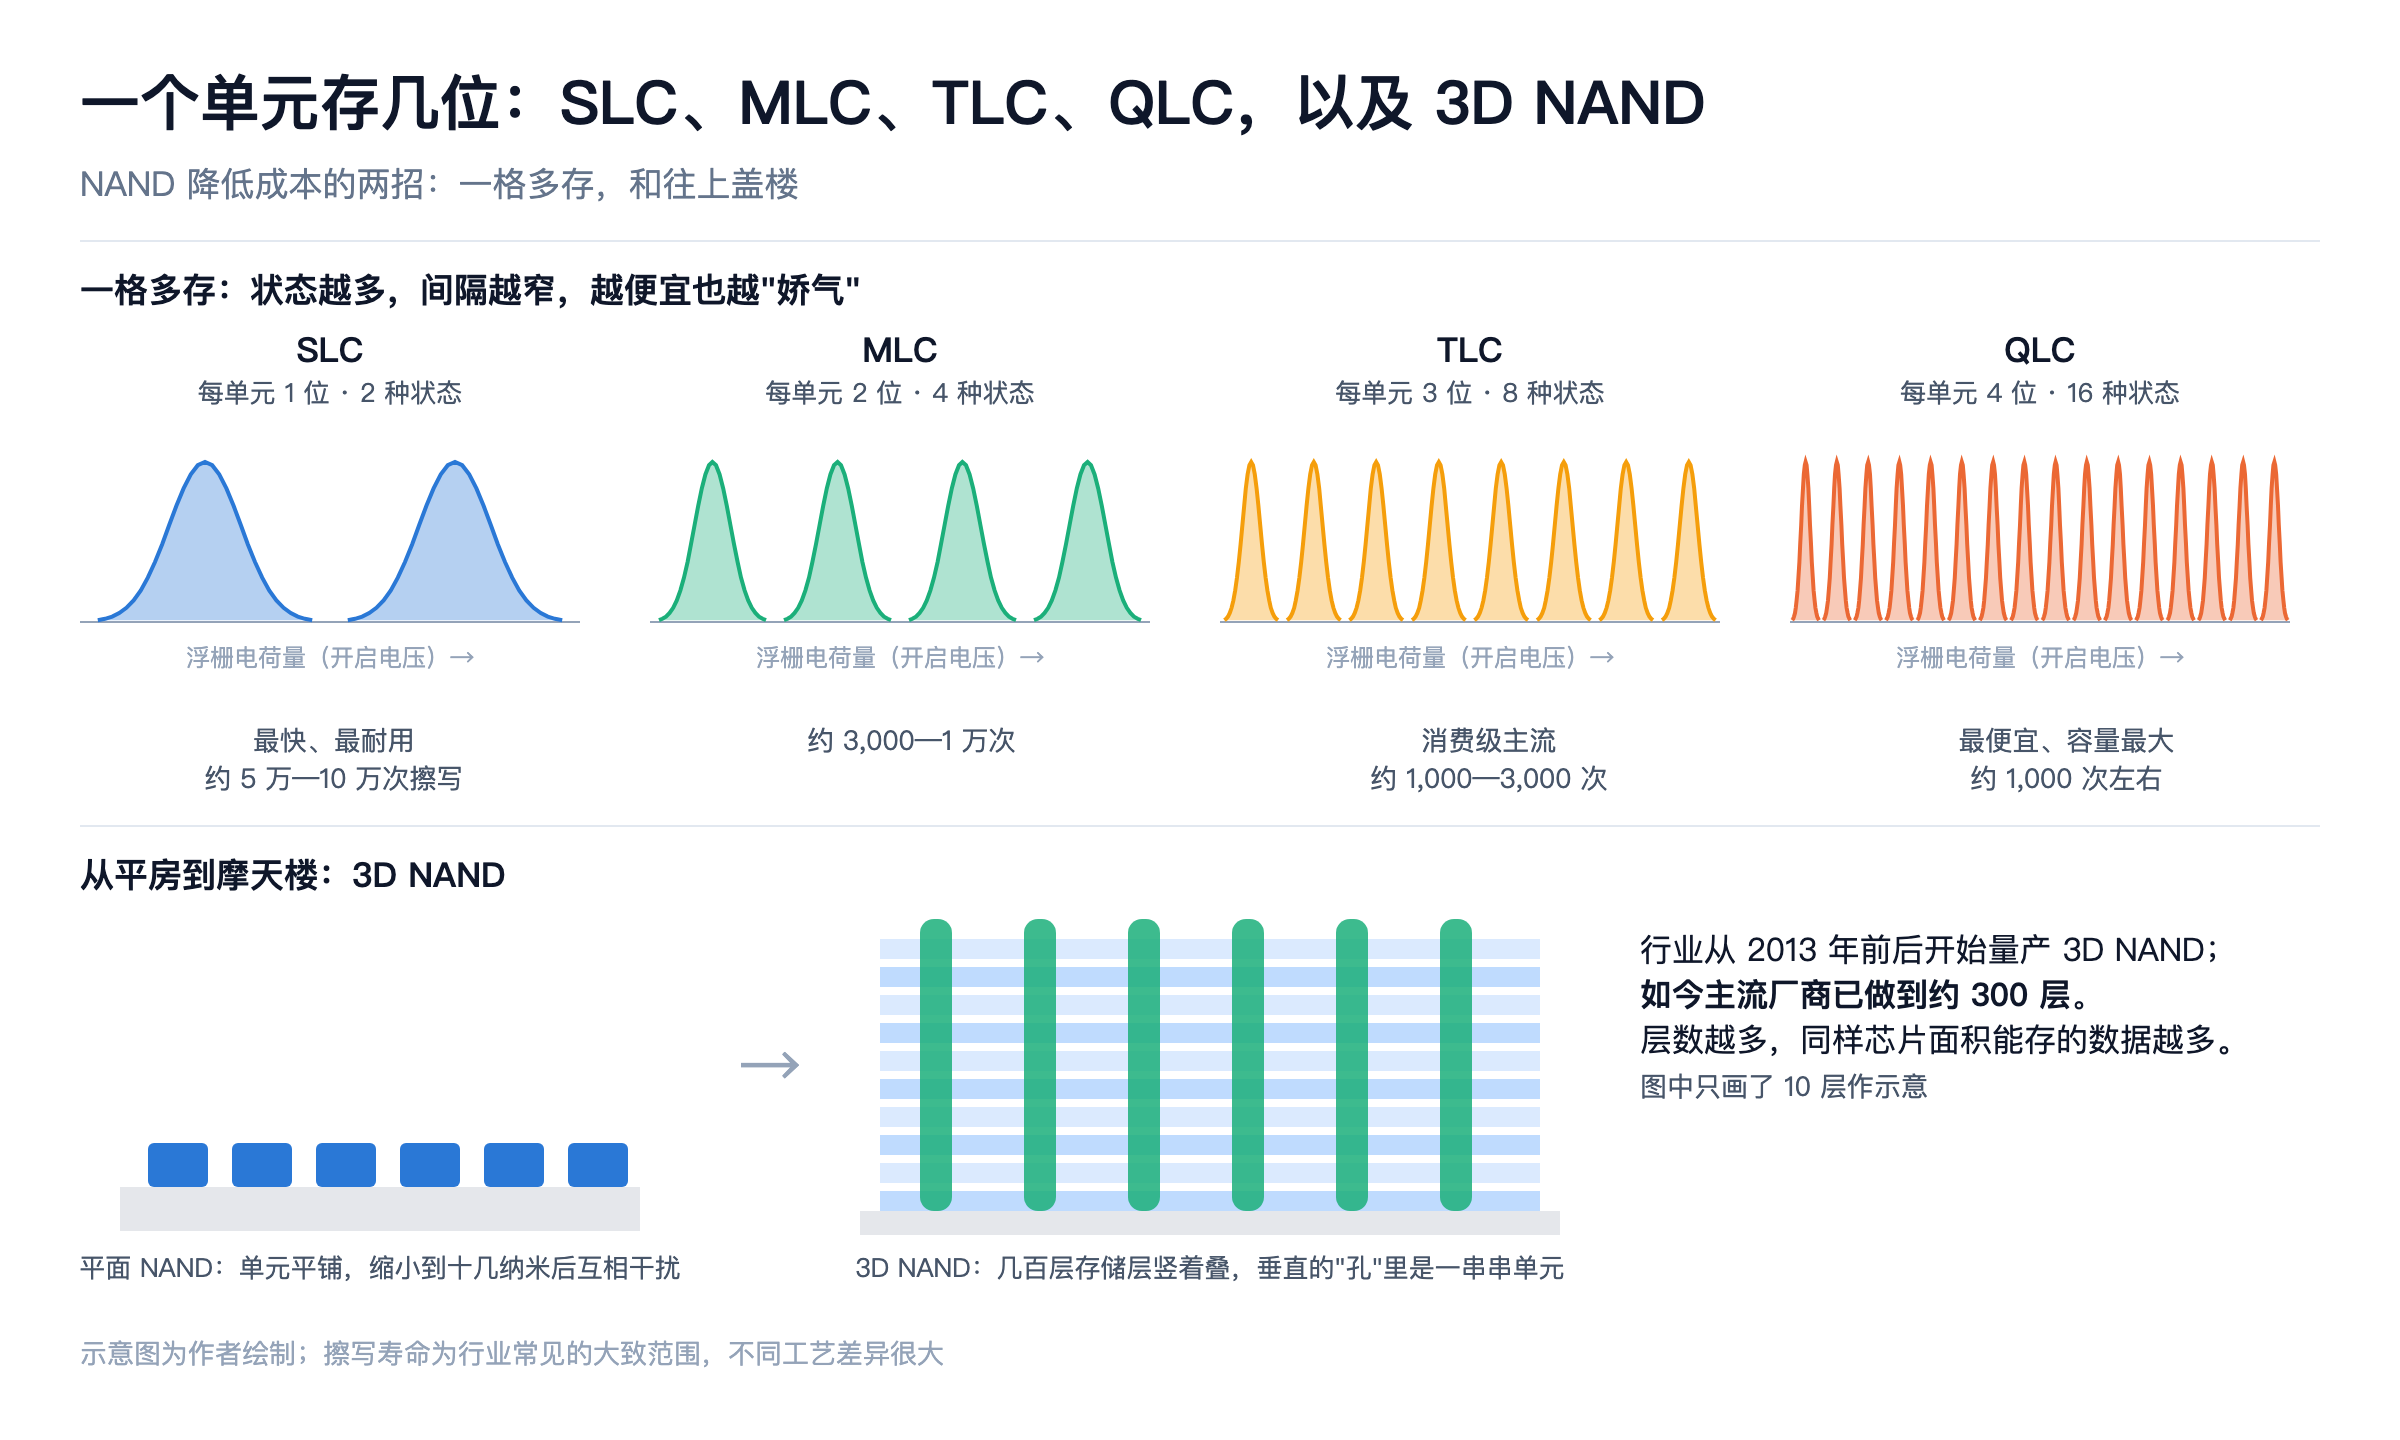
第一招:一个单元存更多位。
浮栅里的电子数量可以精细控制。如果只分"有电子 / 没电子"两种状态,一个单元存 1 位(SLC);如果分成 4 种电荷多少,就能存 2 位(MLC);8 种是 3 位(TLC),16 种是 4 位(QLC)。
| 类型 | 每单元位数 | 需要区分的状态数 | 大致擦写寿命 | 特点 |
|---|---|---|---|---|
| SLC | 1 | 2 | 约 5 万到 10 万次 | 最快最耐用,最贵 |
| MLC | 2 | 4 | 约 3,000 到 1 万次 | —— |
| TLC | 3 | 8 | 约 1,000 到 3,000 次 | 目前消费级 SSD 主流 |
| QLC | 4 | 16 | 约 1,000 次左右 | 最便宜、容量最大,写入最慢 |
(寿命为行业常见的大致范围,不同工艺和厂商差异很大。)
代价是:状态越多,每两个状态之间的"电压间隔"越窄,读写要更精细,速度更慢、寿命更短。这就是为什么 QLC 最便宜,但更适合"写一次、读很多次"的场景。
第二招:从平房到摩天楼——3D NAND。
平面的 NAND 做到十几纳米以后,单元之间靠得太近,会互相干扰。于是行业从 2013 年前后开始,把存储单元竖着一层一层往上叠,就像把平房改成了摩天大楼。如今主流厂商的 3D NAND 已经做到 300 层左右,层数越多,同样一块芯片面积能存的数据越多。
全球 NAND 主要供应商有三星、SK 海力士(含旗下 Solidigm)、日本铠侠、闪迪(SNDK)、美光(MU),以及中国的长江存储。
七、内存条上的 DDR 到底是什么
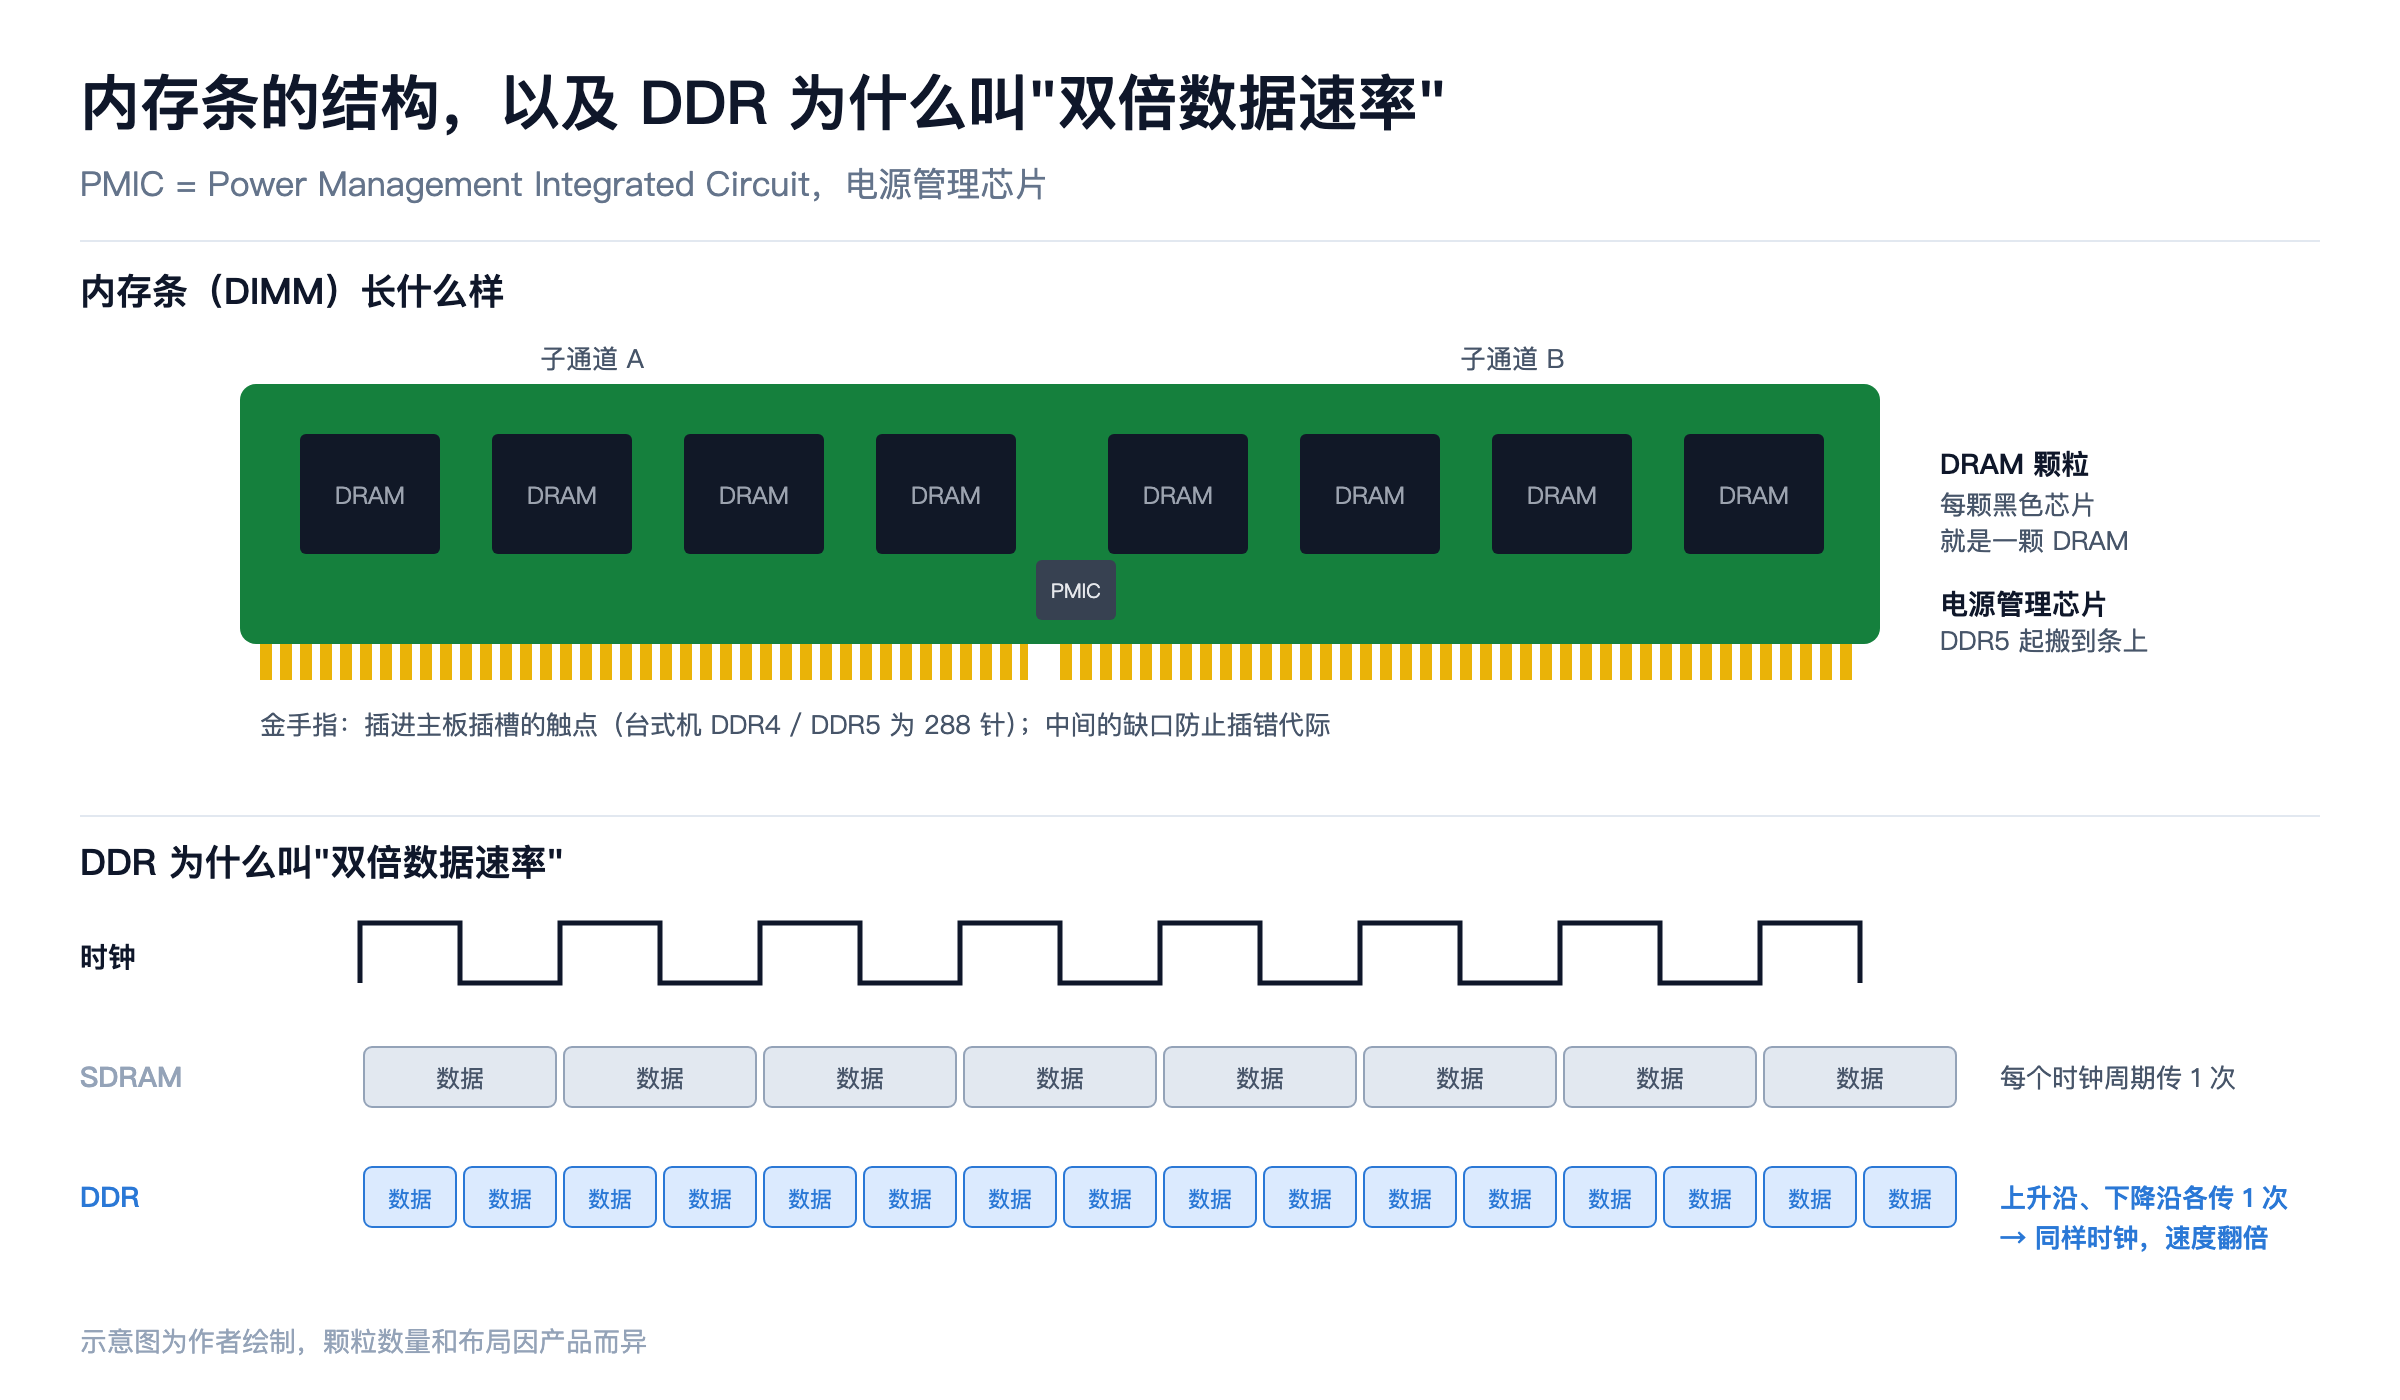
我们平时说的"内存条",就是插在主板上的一块小电路板(DIMM),上面焊着好几颗 DRAM 芯片。
"DDR"的意思是"双倍数据速率"。内存按时钟的节拍工作。早期的同步内存(SDRAM)每个时钟周期只传一次数据;DDR 在时钟的上升沿和下降沿各传一次,同样的时钟频率,速度翻了一倍。后面的 DDR2、DDR3、DDR4、DDR5,都是在这个基础上继续提高速度、降低电压。
| 代际 | 大致上市时间 | 常见速率(MT/s,每秒百万次传输) | 工作电压 |
|---|---|---|---|
| DDR3 | 2007 年前后 | 800—2133 | 1.5 伏 |
| DDR4 | 2014 年前后 | 1600—3200 | 1.2 伏 |
| DDR5 | 2020 年前后 | 4800—8800 左右 | 1.1 伏 |
DDR5 有几个值得知道的变化:
- 一条内存分成两个独立的"子通道",可以同时处理两个请求,效率更高;
- 电源管理芯片从主板搬到了内存条上,供电更稳定;
- 芯片内部自带纠错(ECC),因为单元越来越小,更容易出错。
内存条上常见的几个名词:
- 颗粒:内存条上一颗颗黑色的芯片,就是 DRAM 芯片本身;
- 通道:CPU 和内存之间的"车道",主流台式机是双通道,服务器可以有 8 到 12 个通道;
- 时序(如 CL36,CL = CAS Latency,列地址选通延迟):数据延迟的节拍数,数字越小越快;
- 服务器内存条通常带完整的纠错功能,还有一颗"寄存器"芯片帮忙转发信号,所以更稳定、也更贵。
八、DRAM 的四种"包装":DDR、LPDDR、GDDR、HBM
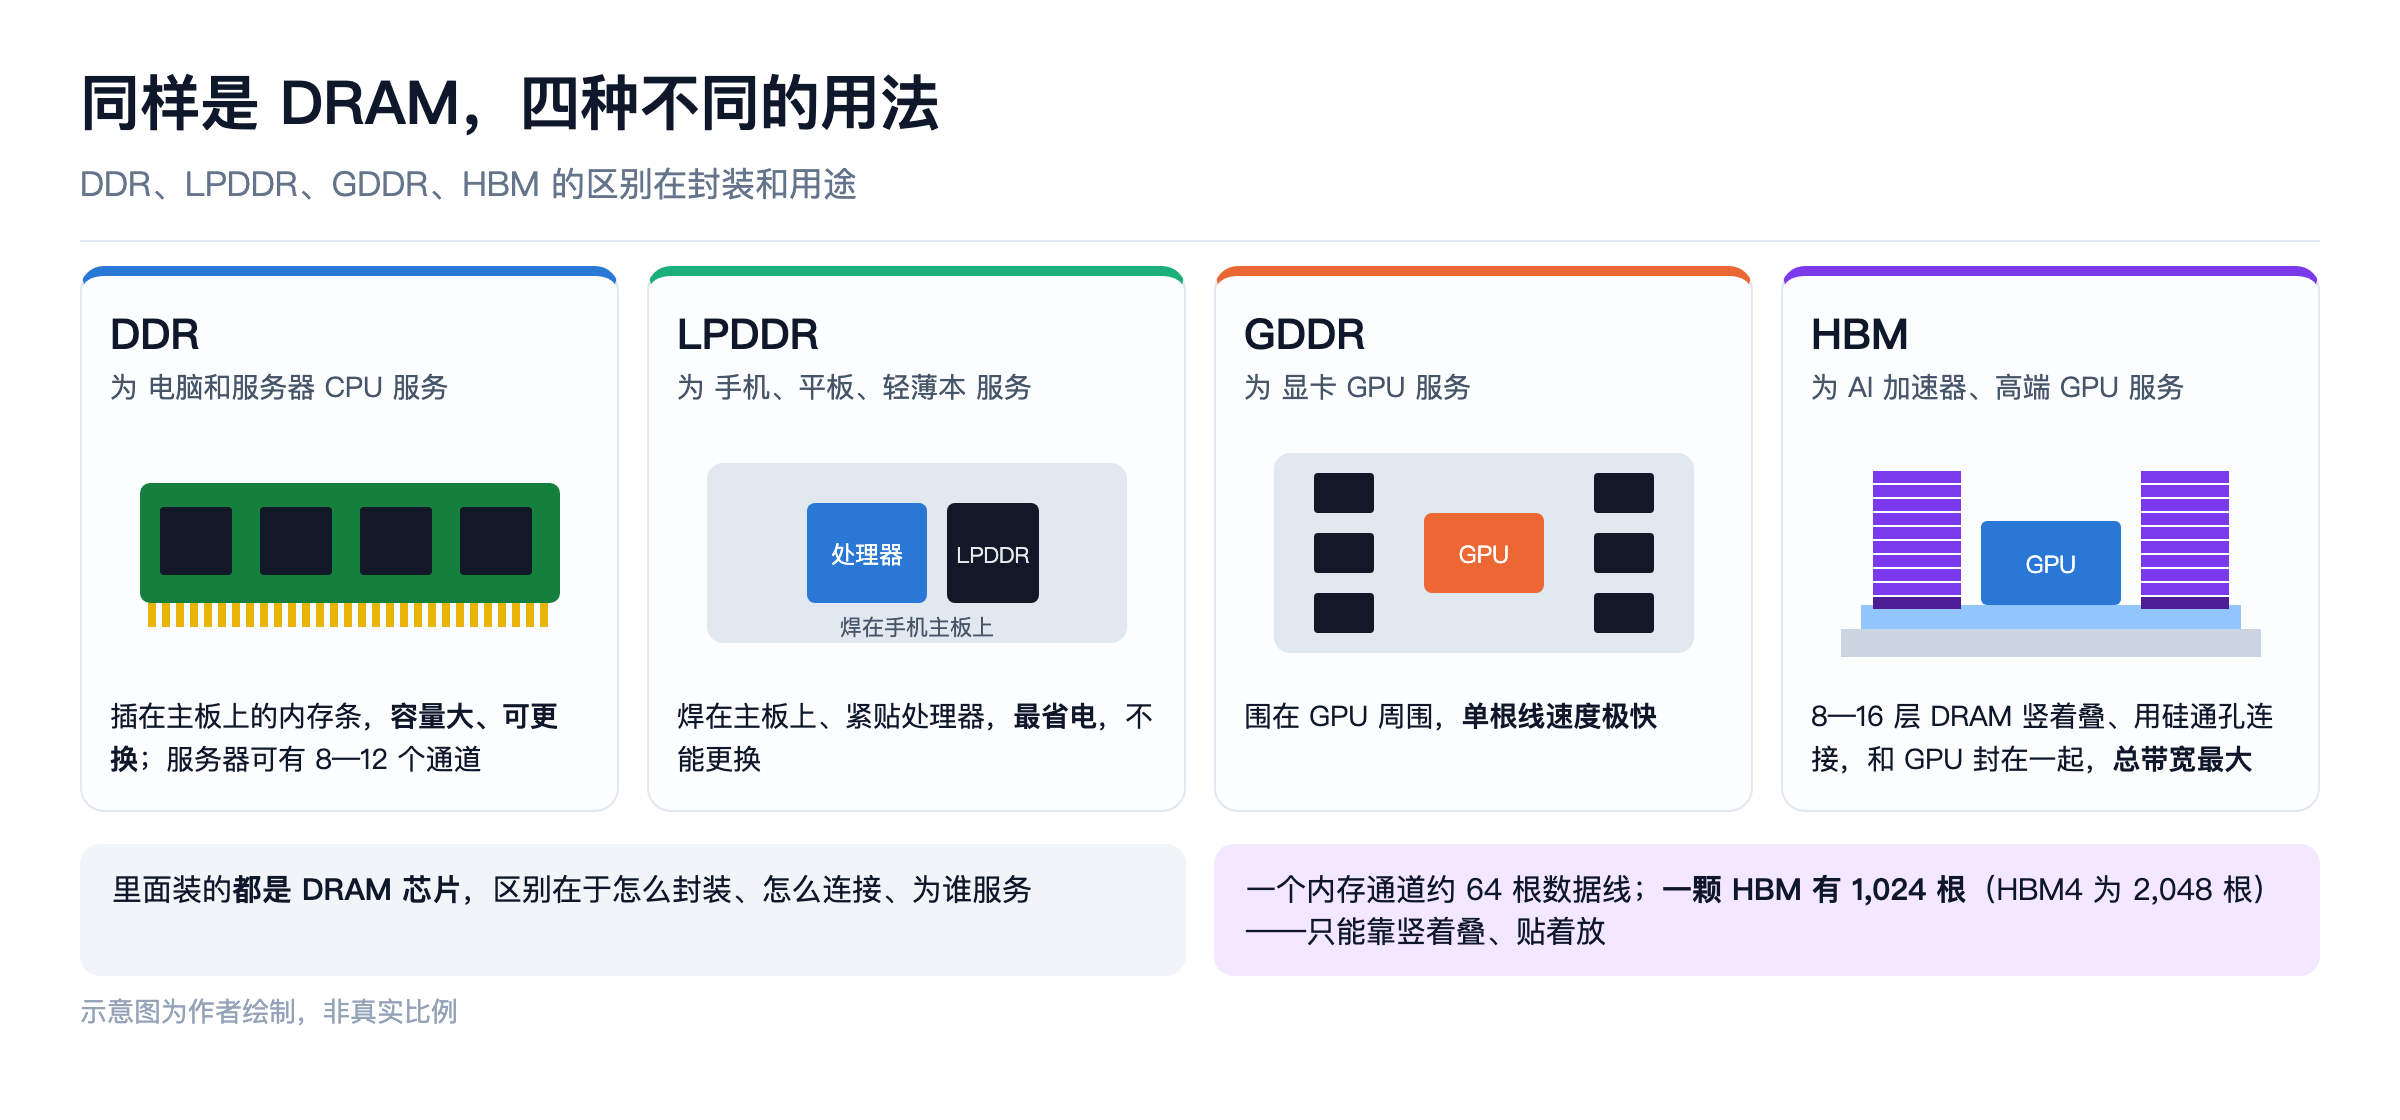
DDR、LPDDR、GDDR、HBM 里面装的都是 DRAM 芯片,区别在于怎么封装、怎么连接、为谁服务:
| 类型 | 为谁服务 | 形态 | 追求什么 |
|---|---|---|---|
| DDR | 电脑和服务器的 CPU | 插在主板上的内存条 | 容量大、可以更换、成本适中 |
| LPDDR | 手机、平板、轻薄笔记本 | 焊在主板上、紧贴处理器 | 省电 |
| GDDR | 显卡 GPU | 焊在显卡上,围在 GPU 周围 | 单根线的速度极快 |
| HBM | AI 加速器、高端 GPU | 8 到 16 层 DRAM 竖着叠起来,和 GPU 封装在一起 | 总带宽最大 |
HBM 为什么要竖着叠?普通内存条和 CPU 之间的数据线只有 64 根左右(每个通道),而一颗 HBM 有 1,024 根数据线(最新的 HBM4 翻倍到 2,048 根)。这么多根线,只能靠极近的距离和极密的连接来实现:把多层 DRAM 叠起来,层与层之间用硅通孔(TSV)连接,再和 GPU 一起装在一块硅中介层上,距离只有几毫米。
所以 HBM 不是"更快的内存条",而是一种"先进封装"。它的难点在于堆叠、打孔和散热,这部分我在先进封装那篇里画过剖面图。据公开规格,英伟达(NVDA)的 B200 芯片配了 8 颗 HBM3E,总带宽约每秒 8 太字节。
HBM 断电后数据也会丢吗?
会。HBM 本质上还是 DRAM,只是把 8 到 16 层 DRAM 芯片竖着叠起来、和 GPU 封装在一起。每个存储单元仍然是"1 个晶体管 + 1 个电容",靠电容里的电荷记住 0 和 1,所以:
- 断电就丢:没电以后电荷很快漏光,数据就没了;
- 通电也要刷新:电容本来就会漏电,就算不断电,也要每隔几十毫秒把数据重写一遍,和普通内存条一样。
所以 AI 服务器里是这样分工的:
- 长期保存:模型权重和训练数据放在 SSD(固态硬盘,NAND 闪存做的,断电不丢)或网络存储里;
- 开机后使用:加载模型时,先把权重从 SSD 读进 HBM,GPU 再从 HBM 里高速读取来计算。
这也是为什么训练大模型要定期存"检查点"(checkpoint)——把当前训练进度写回硬盘。万一断电或者机器故障,HBM 里的东西全丢,只能从最近一次检查点接着训练。
九、AI 为什么让存储变成了瓶颈
AI 训练和推理,本质上是在不停地搬数据:
- 模型的参数要从内存搬进计算单元;
- 推理时的"上下文记忆"(行业里叫 KV 缓存,KV 即 Key-Value,键值)会随着对话变长而不断膨胀;
- 训练用的数据集动辄数百 TB,要从 SSD 读进内存。
计算单元的速度提升得很快,但数据搬运的速度跟不上,这就是"内存墙"。所以每一层存储都在被 AI 重新定价:
| 层级 | AI 带来的变化 |
|---|---|
| SRAM | 推理芯片把更多 SRAM 放到计算单元旁边 |
| HBM | AI 加速器的"标配",长期供不应求,是 DRAM 厂商利润最高的产品 |
| DDR5 | AI 服务器的 CPU 需要更大容量的内存 |
| NAND / SSD | 大容量 QLC 固态硬盘用来存训练数据和检索库,逐渐替代部分机械硬盘 |
一个重要的连锁反应:DRAM 厂商把更多产能转去做利润更高的 HBM,普通 DDR 和手机内存的供给就会变紧,价格随之上涨。这也是为什么 AI 热潮会让整个存储行业进入"超级周期"——DRAM 那篇和 NAND 系列第三篇讲过这个供需逻辑。
十、Groq 的 LPU:把整个模型塞进 SRAM
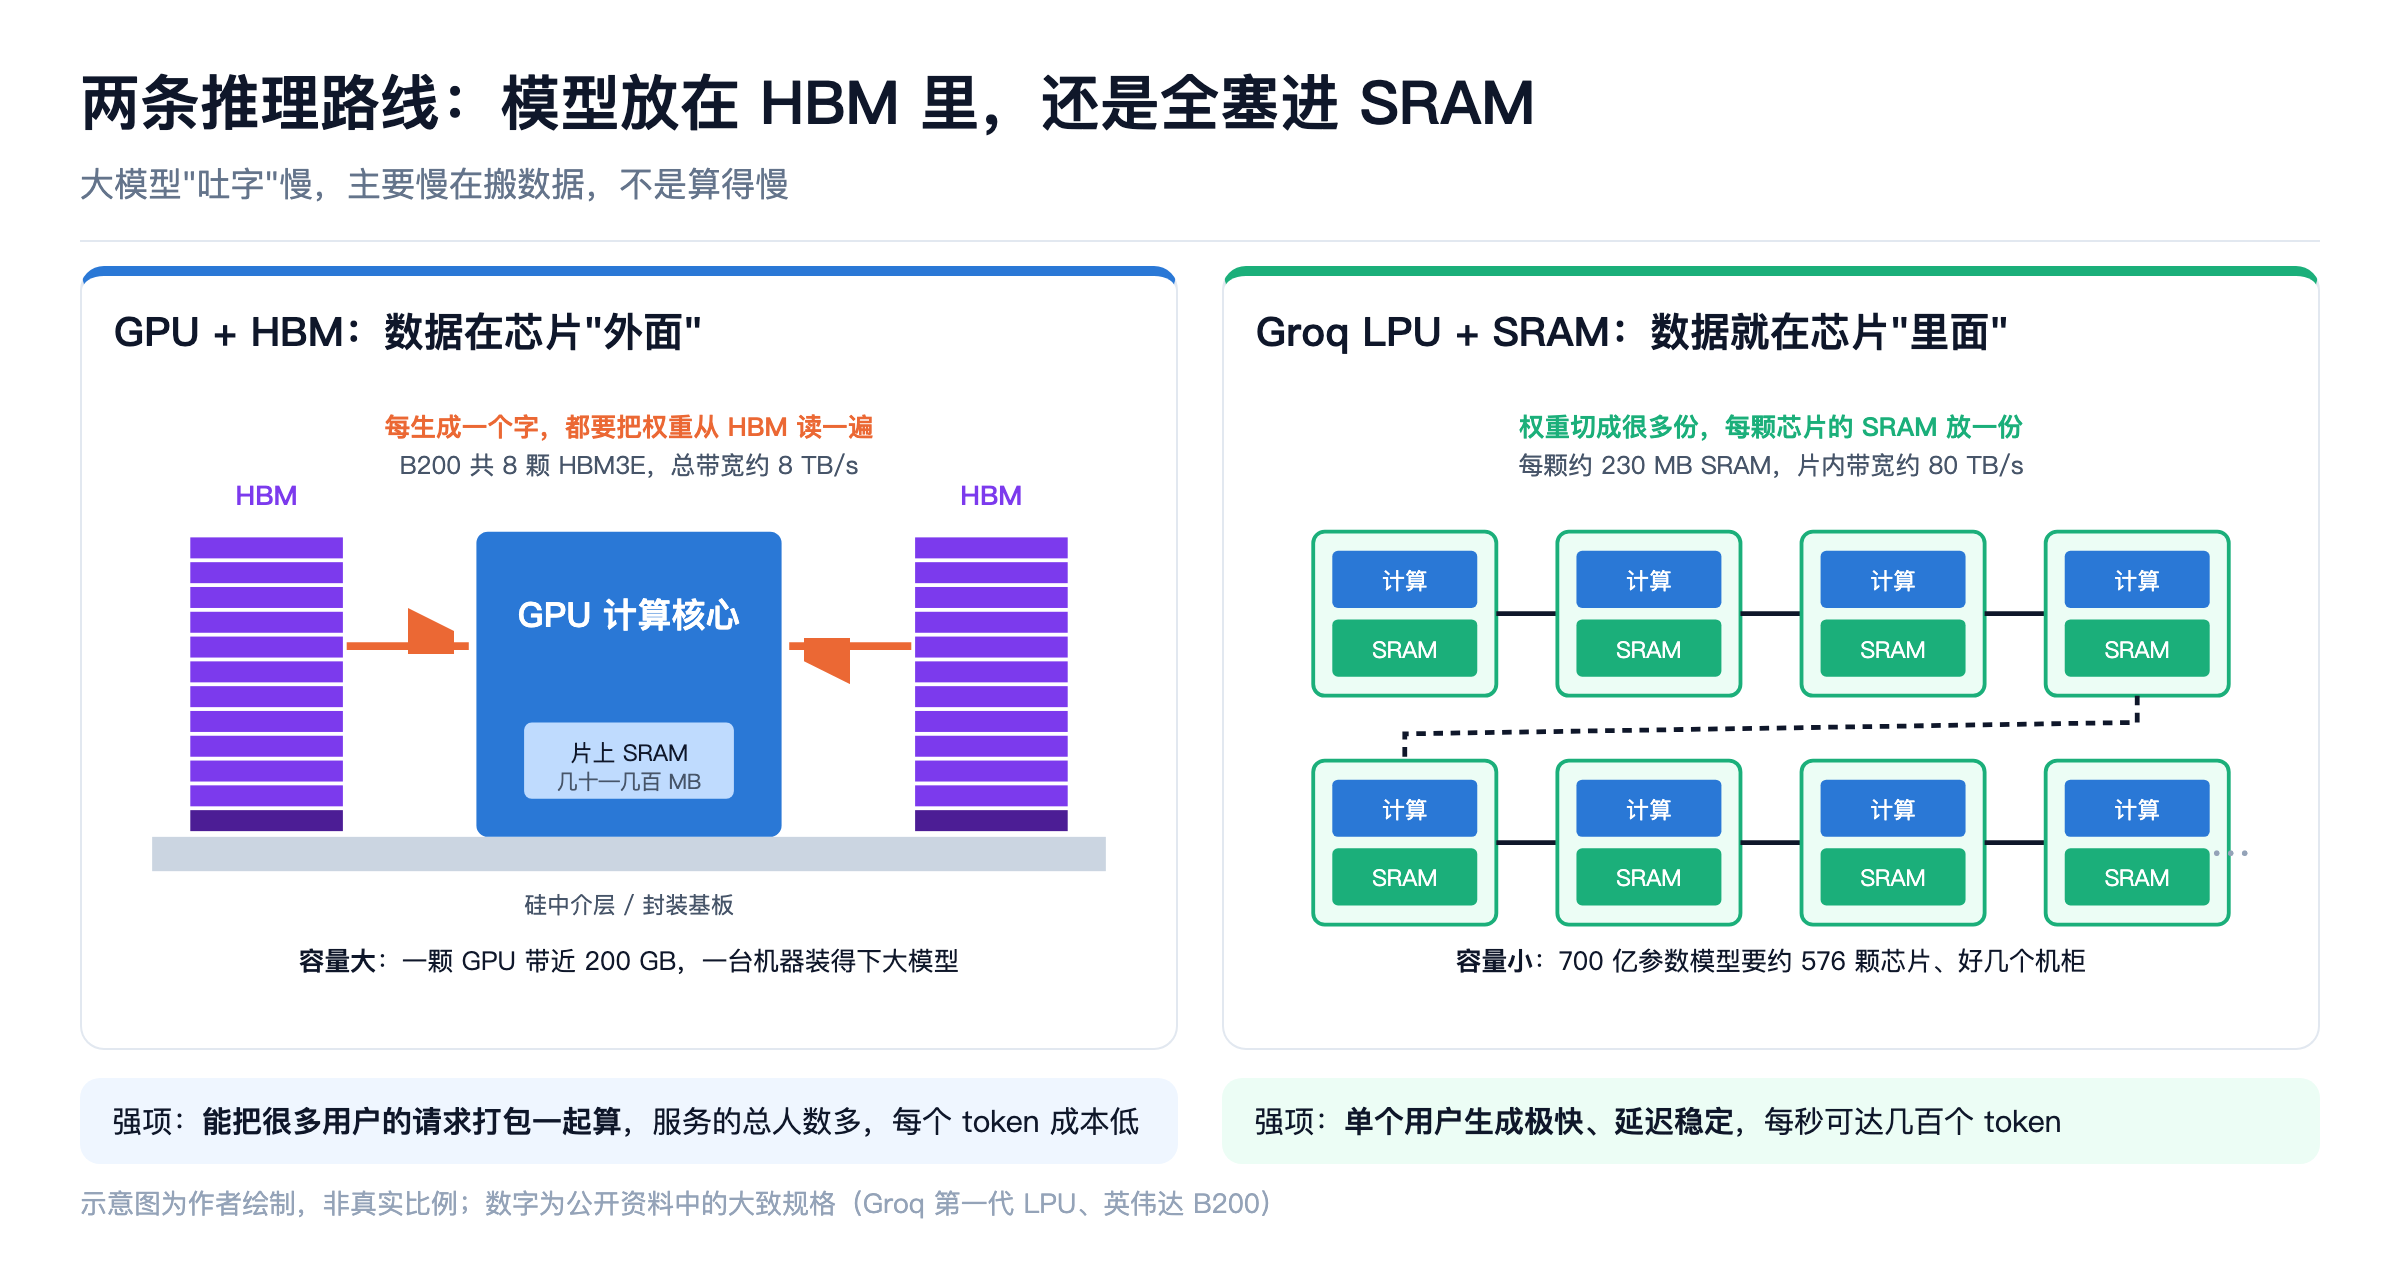
第二节说到 SRAM 越来越难扩容,Groq 却反其道而行:干脆不用 HBM,把模型全放进 SRAM。它的芯片叫 LPU(Language Processing Unit,语言处理单元),是理解"存储决定 AI 速度"最好的例子。
先分清两个名字:Groq(带 q)是芯片公司;Grok(带 k)是马斯克旗下 xAI 的聊天机器人,两者没有关系。
公司背景
- 2016 年成立。创始人 Jonathan Ross 在谷歌参与发起了 TPU(Tensor Processing Unit,张量处理单元,谷歌自研的 AI 芯片)项目,出来后创办了 Groq;
- 芯片早期叫 TSP(Tensor Streaming Processor,张量流处理器),大模型火起来后改名 LPU,主打"说话快";
- 主要通过 GroqCloud 云服务赚钱:按 token(词元)收费,让开发者调用跑在 LPU 上的开源模型(如 Llama、Qwen),同时也卖芯片和整机;
- 是私有公司,没有上市。2025 年 9 月融资 7.5 亿美元,估值约 69 亿美元;还和沙特合作在当地建推理数据中心;
- 2025 年 12 月有报道称,英伟达以约 200 亿美元与 Groq 签了非独家技术授权协议,创始人 Ross 等核心高管加入英伟达,Groq 公司和 GroqCloud 继续独立运营。
为什么快:大模型"吐字"慢,慢在搬数据
1. 瓶颈在内存,不在计算。模型每生成一个 token(大约一个字或半个词),都要把全部权重从内存里读一遍。一个 700 亿参数的模型,每生成一个字就要读约 70GB 数据。GPU 的计算能力其实很强,大部分时间是在等 HBM 把数据送过来——这就是第九节说的"内存墙"。
2. Groq 把权重直接放在芯片内部的 SRAM 里。第一代 LPU 每颗芯片有约 230MB SRAM,片内带宽约 80TB/s(每秒 80 太字节)。作为对比,一颗英伟达 B200 配 8 颗 HBM3E,总带宽约 8TB/s。单看每颗芯片的内存带宽,LPU 高出约一个数量级。
3. "确定性"设计:编译器事先排好每一步。GPU 靠硬件在运行时动态调度,数据在缓存里"碰运气",同一个任务每次的延迟会有波动。LPU 芯片里没有缓存、没有复杂的调度硬件,由编译器(把模型翻译成芯片指令的软件)事先算好每个时钟周期、每个数据走哪条路;多颗芯片之间的通信也事先排好,像火车时刻表一样准点,所以几百颗芯片能像一颗大芯片那样协同工作。
效果:单个用户看到的生成速度非常快。同样跑一个 700 亿参数的模型,GPU 上常见的是每秒几十个 token,Groq 能做到每秒几百个,而且第一个字出来的延迟很低。
代价:容量太小
230MB 听起来不少,放到大模型面前远远不够:
- 一个模型要几百颗芯片:700 亿参数的模型,就算压缩到每个参数 1 字节也要约 70GB。早期公开的案例里,跑 Llama 2 70B 用了约 576 颗芯片,占好几个机柜;
- 前沿模型更难装:现在的前沿模型动辄几千亿到上万亿参数,芯片数量和机房面积成倍增加;
- 长上下文更吃亏:对话越长,KV 缓存越大,而 SRAM 本来就装不下多少;
- 总吞吐量和成本不一定占优:GPU 可以把很多用户的请求打包一起算(批处理),摊薄成本;LPU 的强项是"单个用户快",同样花钱,未必"服务的总人数多";
- 工艺较老:第一代芯片用的是 14 纳米工艺,下一代转向三星 4 纳米。
在推理芯片里的位置
| 路线 | 代表 | 内存方案 | 强项 |
|---|---|---|---|
| GPU + HBM | 英伟达、AMD | 大容量 HBM | 通用,训练和推理都能做,大批量处理时成本低 |
| 片上大 SRAM | Groq LPU | 每颗约 230MB SRAM,很多颗串联 | 单个用户延迟极低、生成极快 |
| 整张晶圆做一颗芯片 | Cerebras | 一颗芯片约 44GB SRAM | 同样主打速度,单颗芯片容量大得多 |
| 自研 ASIC(Application-Specific Integrated Circuit,专用集成电路) | 谷歌 TPU 等 | HBM | 为自家模型定制,成本最优 |
我的判断:Groq 证明了"推理速度"本身有价值——尤其是 AI 智能体(AI Agent)要连续思考几十步的场景,每一步都快,总体体验差别很大。但它不会取代 GPU,更可能成为推理里"超低延迟"这一细分的方案。英伟达花大价钱拿它的技术授权,本身就说明这条路线有价值,而且英伟达更可能把这套思路吸收进自己的产品线。从存储的角度看,这恰好印证了本文的主线:AI 芯片的竞争,很大程度上是"数据放在哪一层存储里"的竞争。
十一、正在路上的新型存储
行业一直在找一种"像 DRAM 一样快、像闪存一样断电不丢"的理想存储。几个候选者:
| 名称 | 原理 | 现状 |
|---|---|---|
| MRAM(Magnetoresistive RAM,磁阻存储器) | 用电子的"自旋"方向(磁化方向)存数据 | 已用于部分嵌入式芯片和汽车电子 |
| ReRAM(Resistive RAM,阻变存储器) | 用材料电阻的高低存数据 | 小规模应用 |
| PCM(Phase-Change Memory,相变存储器) | 让材料在晶态和非晶态之间切换 | 英特尔的傲腾(Optane)曾经商用,2022 年宣布停止 |
| CXL 内存扩展(Compute Express Link,计算快速链接) | 不是新材料,而是一种新连接标准,让服务器可以挂接更多外部内存 | 数据中心正在推广 |
到目前为止,还没有一种新型存储能在成本上全面取代 DRAM 和 NAND。所以未来几年,存储金字塔的基本形状不会变,变的是每一层的规模和连接方式。
一张表记住所有概念
| 名称 | 一句话 | 断电 | 速度 | 成本 |
|---|---|---|---|---|
| SRAM | 6 个晶体管互锁,做缓存;单元已很难再缩小 | 丢 | 最快 | 最贵 |
| DRAM | 1 个晶体管 + 1 个电容,要刷新,做内存 | 丢 | 快 | 中 |
| DDR / LPDDR / GDDR / HBM | 都是 DRAM,分别服务电脑、手机、显卡、AI 加速器(HBM 同样断电即丢) | 丢 | 快到很快 | 中到很贵 |
| ROM | 出厂写死 | 不丢 | —— | 低 |
| PROM | 只能写一次 | 不丢 | —— | 低 |
| EPROM | 紫外线擦除 | 不丢 | 慢 | —— |
| EEPROM | 电擦除,按字节改 | 不丢 | 慢 | 较贵 |
| NOR 闪存 | 并联,能随机读,放固件 | 不丢 | 读快写慢 | 较贵 |
| NAND 闪存 | 串联,按块擦除,做 SSD | 不丢 | 较慢 | 最便宜 |
金豆划重点
- 所有存储都在平衡"快、多、久、便宜",没有一种能全占,所以要分层:寄存器 → SRAM 缓存 → DRAM 内存 → NAND 固态硬盘 → 机械硬盘,越往下越慢、越便宜、容量越大;
- "内存"一般指 DRAM,"存储"一般指 SSD 和硬盘,一个是工作台,一个是仓库;
- SRAM:6 个晶体管组成互锁开关,最快、最贵,做 CPU 和 GPU 的缓存;总量在变大,但单元几乎缩不动了,只能靠叠层(如 3D V-Cache)和把芯片做大;
- DRAM:1 个晶体管加 1 个电容,电容会漏电,大约每 64 毫秒要刷新一遍,读取还会破坏数据;便宜量大,做内存;
- ROM 家族:掩膜 ROM 出厂写死 → PROM 写一次 → EPROM 紫外线擦除 → EEPROM 电擦除 → 闪存按块擦除,越来越好改;
- 浮栅晶体管是断电不丢的秘密:电子被困在绝缘层包围的浮栅里;每次擦写都在磨损绝缘层,所以闪存有寿命;
- NOR 与 NAND:NOR 并联、能随机读,放固件;NAND 串联、按块擦除、最便宜,做 SSD 和手机存储;
- NAND 两招:一格多存(SLC→QLC,越便宜越短命)、往上盖楼(3D NAND 已到约 300 层);
- DDR:时钟上下沿各传一次,所以"双倍";DDR5 分两个子通道、电源管理上条、内置纠错;
- DDR、LPDDR、GDDR、HBM 都是 DRAM,区别在封装和用途;HBM 靠竖着叠和硅通孔换来 1,024 根以上的数据线,本质是一种先进封装;HBM 也是 DRAM,断电同样会丢数据,模型权重平时存在 SSD 里,用时再加载进 HBM;
- AI 让存储变成瓶颈:内存墙、KV 缓存、训练数据,HBM 供不应求并挤占普通内存产能,推动存储超级周期;
- Groq 的 LPU 反其道而行:把模型全放进片上 SRAM,单用户生成极快,代价是一个模型要几百颗芯片——AI 芯片之争,很大程度上是"数据放在哪一层存储"之争。
资料来源:各类存储器的基本原理综合自半导体教材与行业公开资料;DDR 代际参数参考 JEDEC(固态技术协会,Joint Electron Device Engineering Council)公开标准的大致范围;闪存擦写寿命、3D NAND 层数、HBM 与 B200 规格、SRAM 单元面积、Groq LPU 规格与融资及授权交易信息来自厂商公开资料与行业报道,均为大致数字。电路图和结构图为作者绘制的示意图,已做简化。本文只讨论技术原理,不构成任何投资建议。
— 金豆