先放结论:
- 利空有轻重。最重的是 OpenAI 的极速档可能改用了英伟达,因为 OpenAI 是它未来几年收入的大头;高管卖股和解禁是供给压力,不改变生意本身;
- 木头姐押的是“快速推理会成为大市场”。ARK 没有公开解释过,文中的原因是我归纳的;
- 英伟达说 Groq 3 LPX 快 4 倍,站不住:比的是 Cerebras 的旧系统。但 Cerebras 也拿不出同条件的独立数据;
- 两家的技术很像:都把模型放进芯片自带的内存,片上内存 132GB 对 128GB,天花板也一样;
- Cerebras 不受先进封装和 HBM 缺货的影响,但它有自己更难的专用组装工艺,而且英伟达的 LPX 同样绕开了这两样;
- 机房成本两家打平。区别是 Cerebras 要自己租机房、自己运营,英伟达不用;
- 它的命运握在三四家巨头手里:OpenAI 是客户、债主加股东,亚马逊那条线 2027 年年中才有收入;
- 智能体是它最大的顺风,但有三道坎;
- 我的看法:技术没有输,生意处在最难的一段。11 月解禁和三季度财报之前,不急。
这是站内第二篇 Cerebras 文章。公司的背景、晶圆级芯片的原理、收入结构,见 9 月的《Cerebras:技术是真突破,但这不是一个确定性的机会》。这篇只讲之后发生的事。
先把几个词讲清楚
英文缩写
| 缩写 | 英文全称 | 中文意思 | 通俗解释 |
|---|---|---|---|
| WSE | Wafer-Scale Engine | 晶圆级引擎 | Cerebras 的芯片:把一整片晶圆做成一颗芯片,不切开 |
| CS | Cerebras System | Cerebras 系统 | 装着 WSE 芯片的整机。CS-3 装一片 WSE-3,CS-4 装三片 WSE-3 Turbo |
| LPU | Language Processing Unit | 语言处理器 | Groq 设计的推理芯片,专门用来快速生成文字 |
| LPX | 英伟达的产品名,没有公布全称 | LPU 机柜 | 英伟达用 Groq 技术做的整柜产品,一柜 256 颗 LPU |
| GPU | Graphics Processing Unit | 图形处理器 | 现在主要用来做 AI 计算的通用芯片 |
| SRAM | Static Random-Access Memory | 静态随机存取存储器 | 做在芯片内部的内存,极快,但容量小、很贵 |
| HBM | High Bandwidth Memory | 高带宽内存 | 挂在 GPU 旁边的高速内存,容量大,但比 SRAM 慢 |
| AWS | Amazon Web Services | 亚马逊云服务 | 亚马逊的云计算业务 |
| CoWoS | Chip on Wafer on Substrate | 晶圆上芯片再上基板 | 台积电的先进封装技术,把芯片和内存拼在一起,目前严重供不应求 |
| DRAM | Dynamic Random-Access Memory | 动态随机存取存储器 | 电脑里最常见的内存,密度比 SRAM 高得多,但要做成单独的芯片 |
| RPO | Remaining Performance Obligations | 剩余履约义务 | 已经签了合同、还没确认成收入的金额 |
| ARK | ARK Invest | 方舟投资 | 凯茜·伍德(木头姐)管理的基金公司 |
| PFLOPS | Peta Floating-point Operations Per Second | 每秒千万亿次浮点运算 | 衡量算力的单位 |
中文术语
| 术语 | 意思 |
|---|---|
| 推理 | 模型接到问题、给出回答的过程 |
| token | 模型处理文字的最小单位,约等于半个到一个汉字。“每秒多少个 token”就是生成速度 |
| 上下文 | 一次提问时喂给模型的全部内容。上下文越长,占的内存越多 |
| 并发 | 同时服务多少个请求 |
| 预填充和解码 | 推理的两个阶段:先一次性读完输入(预填充),再一个字一个字往外生成(解码)。解码最吃内存速度 |
| 解禁 | 上市前的股东被限制卖股票的期限到了,可以开始卖 |
| 液冷 | 用液体直接带走芯片热量的散热方式。功率很高的机柜只能用液冷,风吹不动 |
| 功率密度 | 一个机柜用多少电。越高,对机房的供电和散热要求越高 |
| 兆瓦 | 电功率单位,1 兆瓦等于 1,000 千瓦。数据中心的规模通常用兆瓦衡量 |
| 认股权 | 在约定条件下,按约定价格买入公司股票的权利 |
| 核心口径 | Cerebras 自己定义的业绩口径,剔除了部分会计项目,比正式财报口径好看 |
一、发生了什么
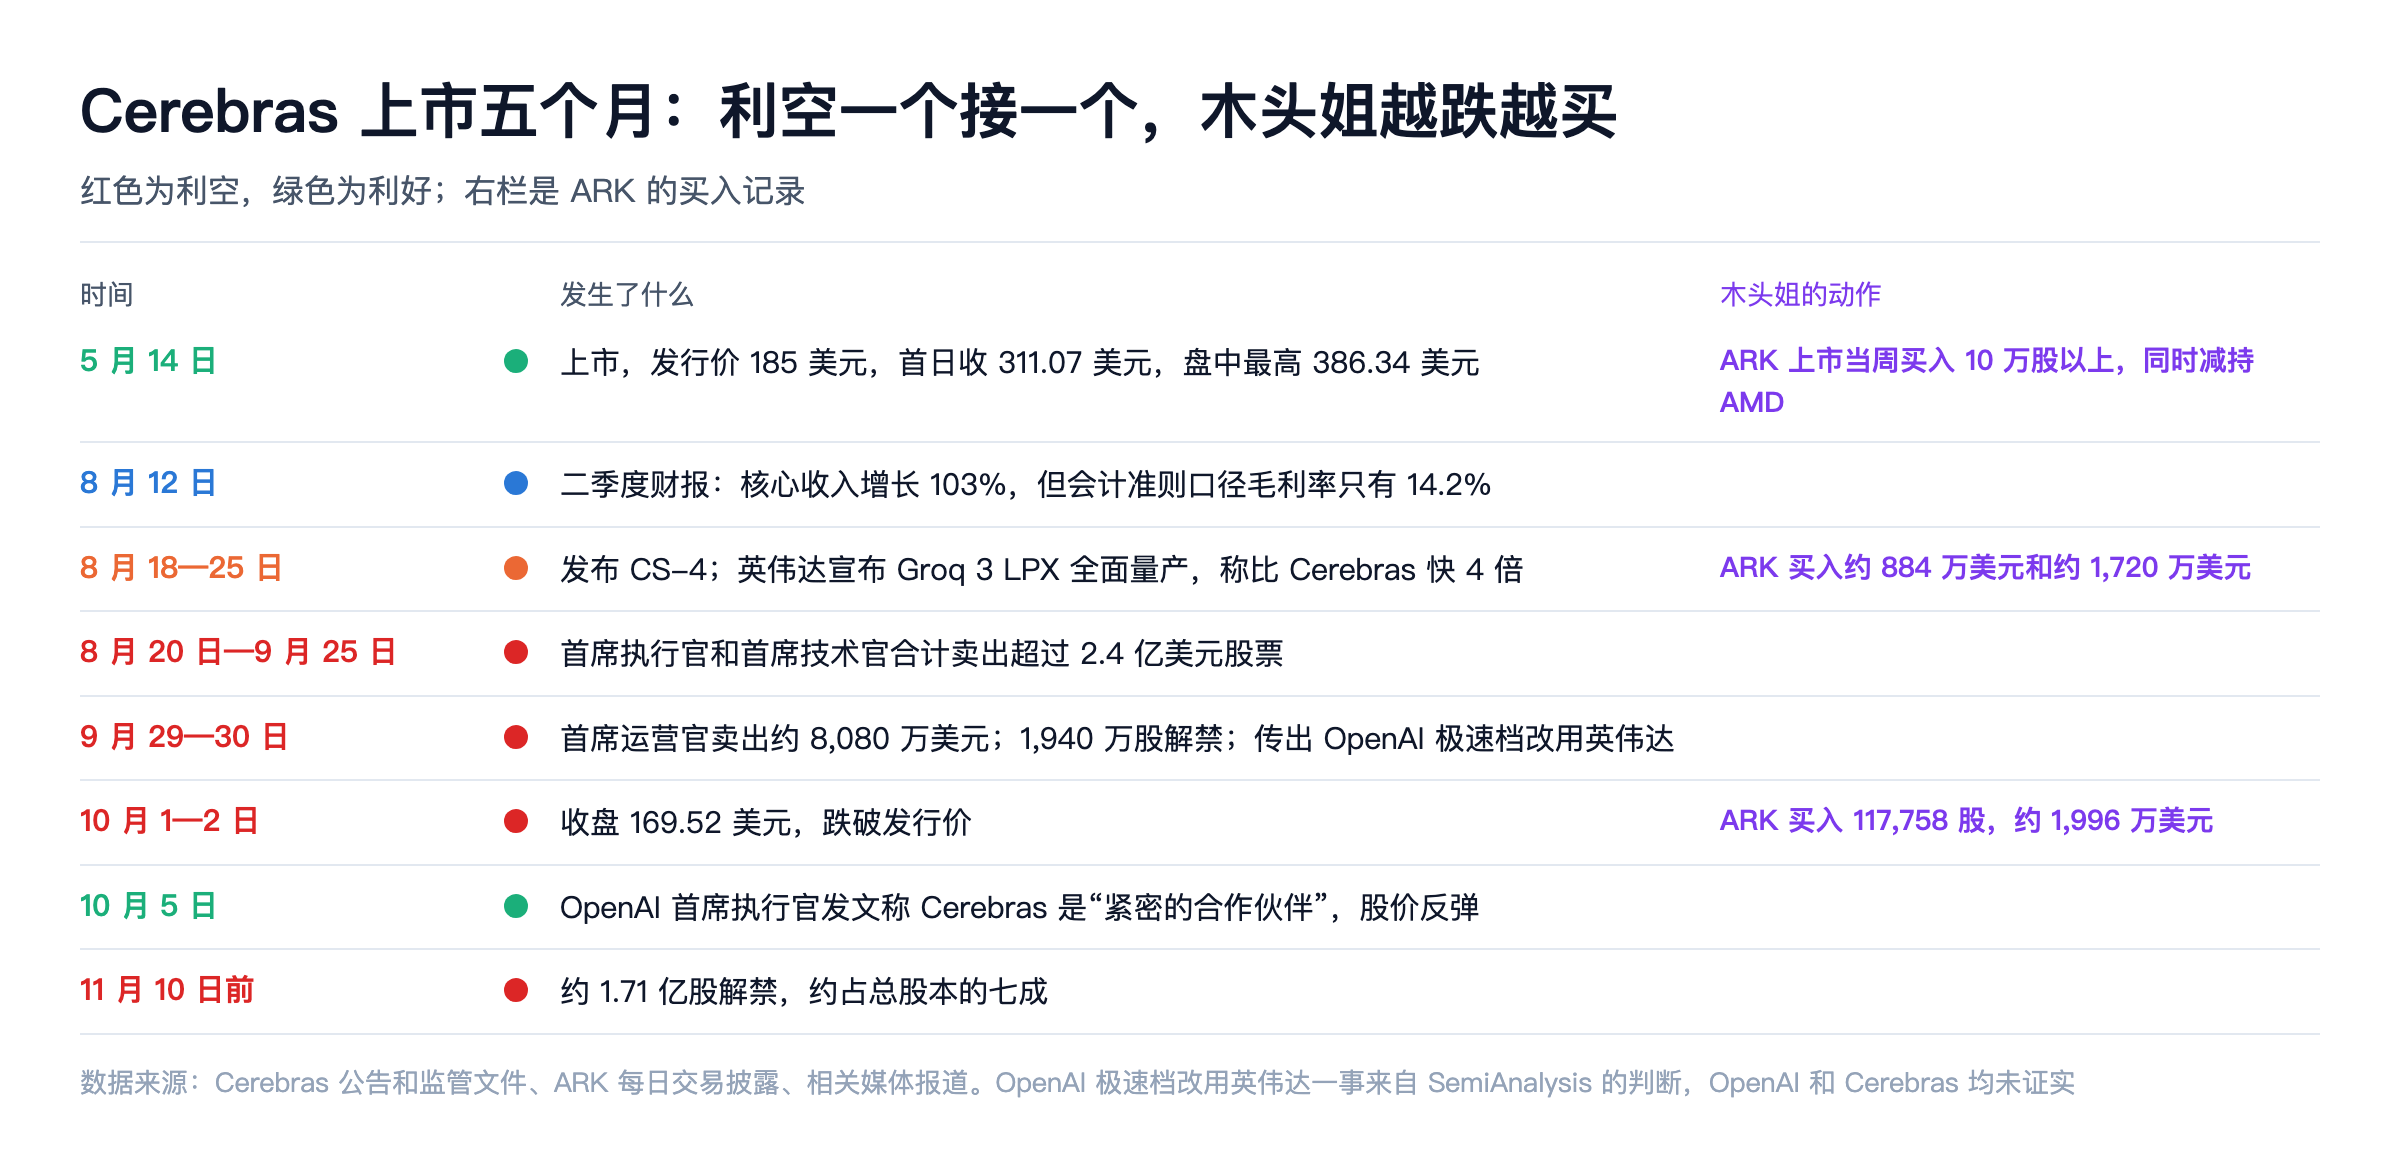
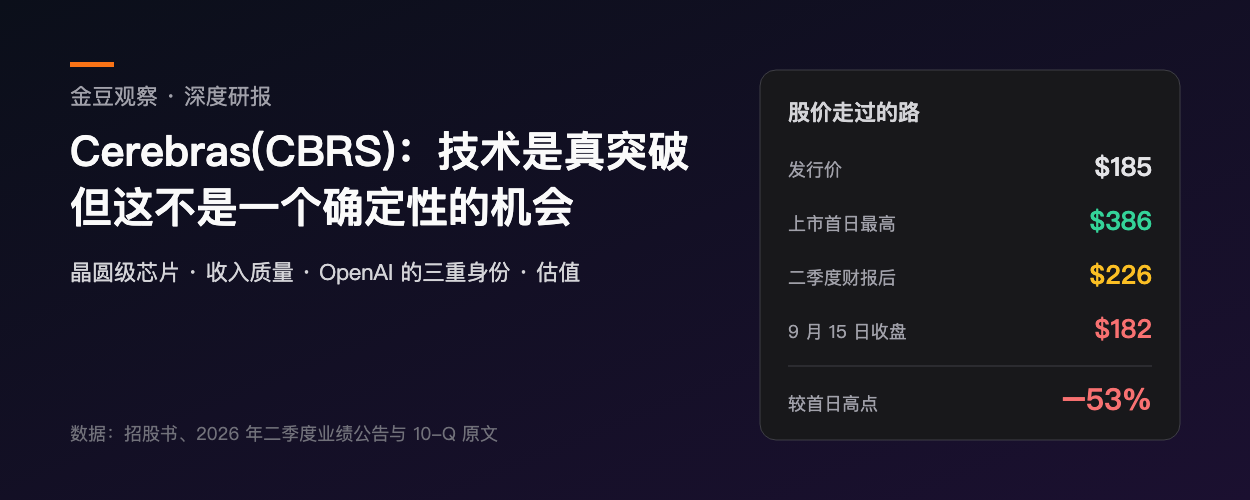
Cerebras 2026 年 5 月 14 日上市,发行价 185 美元,首日收在 311.07 美元,盘中最高 386.34 美元。10 月 1 日收在 169.52 美元,跌破发行价,比首日收盘价低了约 46%。媒体报道FinanceFeeds
9 月 25 日到 10 月 2 日这一周,它跌了 19.5%,同期英伟达(NVDA) 涨了 3.9%。第三方估算Trefis,2026-10-05
二、利空逐条拆:哪个重,哪个轻
1. OpenAI 的“极速档”可能没用它(最重)
9 月 30 日,研究机构 SemiAnalysis 发帖称:OpenAI 新模型 GPT-6.1 Sol 的极速档,每秒约 300 个 token,不是跑在 Cerebras 上,而是跑在英伟达的 GPU 上,用的办法是让每块 GPU 同时只服务很少的请求。媒体报道Briefs
为什么这条最重:
- OpenAI 是 Cerebras 未来几年收入的大头。双方 2025 年 12 月签了协议,承诺 750 兆瓦的推理算力,价值超过 200 亿美元;
- 二季度增长最快的是云服务收入,同比增长 287%,主要靠 OpenAI;
- 对手不需要比你快,只需要“够快”。每秒 300 个 token 远低于 Cerebras 的速度,但用户觉得够用的话,OpenAI 就不必为更快多付钱。
需要打的折扣:
- 这是 SemiAnalysis 的判断,OpenAI 和 Cerebras 都没有证实;
- 10 月 5 日,OpenAI 首席执行官萨姆·奥尔特曼发文说 Cerebras 是“紧密的合作伙伴”,双方在“深度合作,推进速度的极限”,股价当天反弹;客户确认Business Chief
- 奥尔特曼的话没有否认极速档用了英伟达。更合理的理解是:OpenAI 两边都用,上一代模型的极速档仍在 Cerebras 上。
2. 高管在卖股票(中等)
- 首席执行官安德鲁·费尔德曼和首席技术官肖恩·列,8 月 20 日到 9 月 25 日合计卖出超过 2.4 亿美元;媒体报道Briefs
- 首席运营官 9 月 29 日卖出 39.6 万股,约 8,080 万美元,按 6 月 30 日定好的预设计划执行。公司自报监管文件,FinanceFeeds 转述
怎么看:走的是预设计划,不是看到利空临时跑。但股价跌破发行价时,三位最高管理者合计卖出超过 3 亿美元,观感很差,也增加了卖压。
3. 解禁(中等,有明确日期)
- 9 月 30 日已解禁约 1,940 万股;媒体报道Benzinga
- 更大的一批在后面:约 1.71 亿股,在三季度财报发布后第二个交易日或 11 月 10 日解禁,以先到者为准。公司总股本约 2.38 亿股,这一批约占七成。媒体报道FinanceFeeds
怎么看:纯粹的供给问题,不改变公司价值。但 11 月 10 日之前,股价头上一直悬着这件事。
4. 财报里的两个口径(容易被忽略)
二季度公司强调的是“核心口径”,但正式财报的数字差很多:
| 项目 | 核心口径 | 会计准则口径 |
|---|---|---|
| 收入 | 2.099 亿美元,增长 103% | 1.801 亿美元,增长 74% |
| 毛利率 | 40.6% | 14.2%(一年前 31.1%) |
| 亏损 | 营业亏损 3,360 万美元 | 净亏损 4.505 亿美元 |
公司自报二季度电话会公司自报二季度财报,FinanceFeeds 转述
差距的一个来源是给 OpenAI 的认股权:按会计准则要冲减收入。这是我的理解,细节以财报为准。
管理层说核心毛利率环比下降,是因为“把卖出去的系统再租回来”的成本上升。也就是说,它自己的机房不够用。
5. 英伟达正面入场(长期最重要)
8 月 24 日,英伟达宣布 Groq 3 LPX 全面量产,并点名说比“最接近的对手”快 4 倍。公司自报英伟达公告,2026-08-24 这一条放到第四章细讲。
小结:
| 利空 | 性质 | 轻重 | 什么时候见分晓 |
|---|---|---|---|
| OpenAI 极速档 | 最大客户的依赖度 | 重 | 三季度财报,看 OpenAI 相关收入 |
| 英伟达 LPX | 长期竞争格局 | 重 | 2026 年底到 2027 年,看独立测试和客户选择 |
| 解禁 | 股票供给 | 中,日期确定 | 11 月 10 日前 |
| 高管卖股 | 股票供给和观感 | 中 | 看解禁后是否继续 |
| 毛利率 | 利润质量 | 中 | 每个季度 |
三、木头姐为什么越跌越买
她买了多少
| 时间 | 动作 | 背景 |
|---|---|---|
| 5 月上市当周 | 买入 10 万股以上,同时减持 AMD(AMD) | 首日大涨之后 |
| 8 月 18 日 | 买入约 884 万美元 | 发布会后股价回落 |
| 8 月 25 日 | 买入 93,290 股,约 1,720 万美元 | 英伟达宣布 LPX 量产的第二天 |
| 10 月 2 日 | 买入 117,758 股,约 1,996 万美元 | 跌破发行价的第二天 |
媒体报道Barchart媒体报道Dealroom媒体报道Yahoo Finance媒体报道Investing.com,2026-10-02
8 月底时,Cerebras 约占 ARK 旗舰基金 ARKK 的 2.68%、ARKW 的 2.73%,是中等偏上的仓位。每次买入都在利空之后。
她可能看好什么
ARK 没有就 Cerebras 发过专门的投资说明。下面五条里,第 2 条有她公开言论的报道,其余是我的归纳。
1. 推理会比训练大得多,而“快”会变成刚需
智能体一项任务要连续调用模型几十上百次,每次慢一点,整个任务就慢很多。第七章展开讲。
2. 她在押“不需要 HBM 的芯片”
据报道,木头姐认为 Cerebras 和 Groq 这类芯片在做推理时可以减少甚至不用外挂的 HBM(High Bandwidth Memory,高带宽内存),并据此看淡内存涨价这条线。媒体报道Yahoo Finance 4.7 节展开讲。
3. 英伟达花 200 亿美元买 Groq 的授权,本身就是背书
2025 年 12 月,英伟达以约 200 亿美元拿下 Groq 技术的非独家授权,并把创始人和团队招了过去。媒体报道TechTimes,2026-08-25 行业老大肯花这个钱,说明需求是真的。而上市公司里纯做这件事的只有 Cerebras 一家。
4. 合同是签了的
254 亿美元的 RPO(Remaining Performance Obligations,剩余履约义务),其中约 22% 预计在 24 个月内确认。账上还有约 79 亿美元现金。管理层说 2027 年核心收入会是 2026 年的三倍以上。
5. ARK 的老打法
在高波动的成长股下跌时加仓,持有期按五年算。这个打法在特斯拉上赚过大钱,也在不少公司上亏过。
这个逻辑的漏洞
她的理由都成立,但有三处没有回答:
- “快速推理是大市场”和“Cerebras 能赢”是两回事。英伟达入场后,前一句更可信了,后一句更难了;
- 254 亿美元的合同高度集中在 OpenAI 一家。OpenAI 自己还在亏损,而且手里同时握着英伟达、AMD、博通的方案;
- ARK 的买入本身不是信号。它的规模不大,8 月以来金额已知的三笔加起来约 4,600 万美元,对一家市值约 400 亿美元的公司没有定价权。
四、Cerebras 和英伟达 Groq 3 LPX:客观比较
WSE-3 是芯片,不是整机。装一片 WSE-3 的整机叫 CS-3;2026 年 8 月发布的 CS-4 装三片改进版的 WSE-3 Turbo。下面比的是整机对整机。
4.1 先认识 CS-4:芯片没换代,性能却翻倍
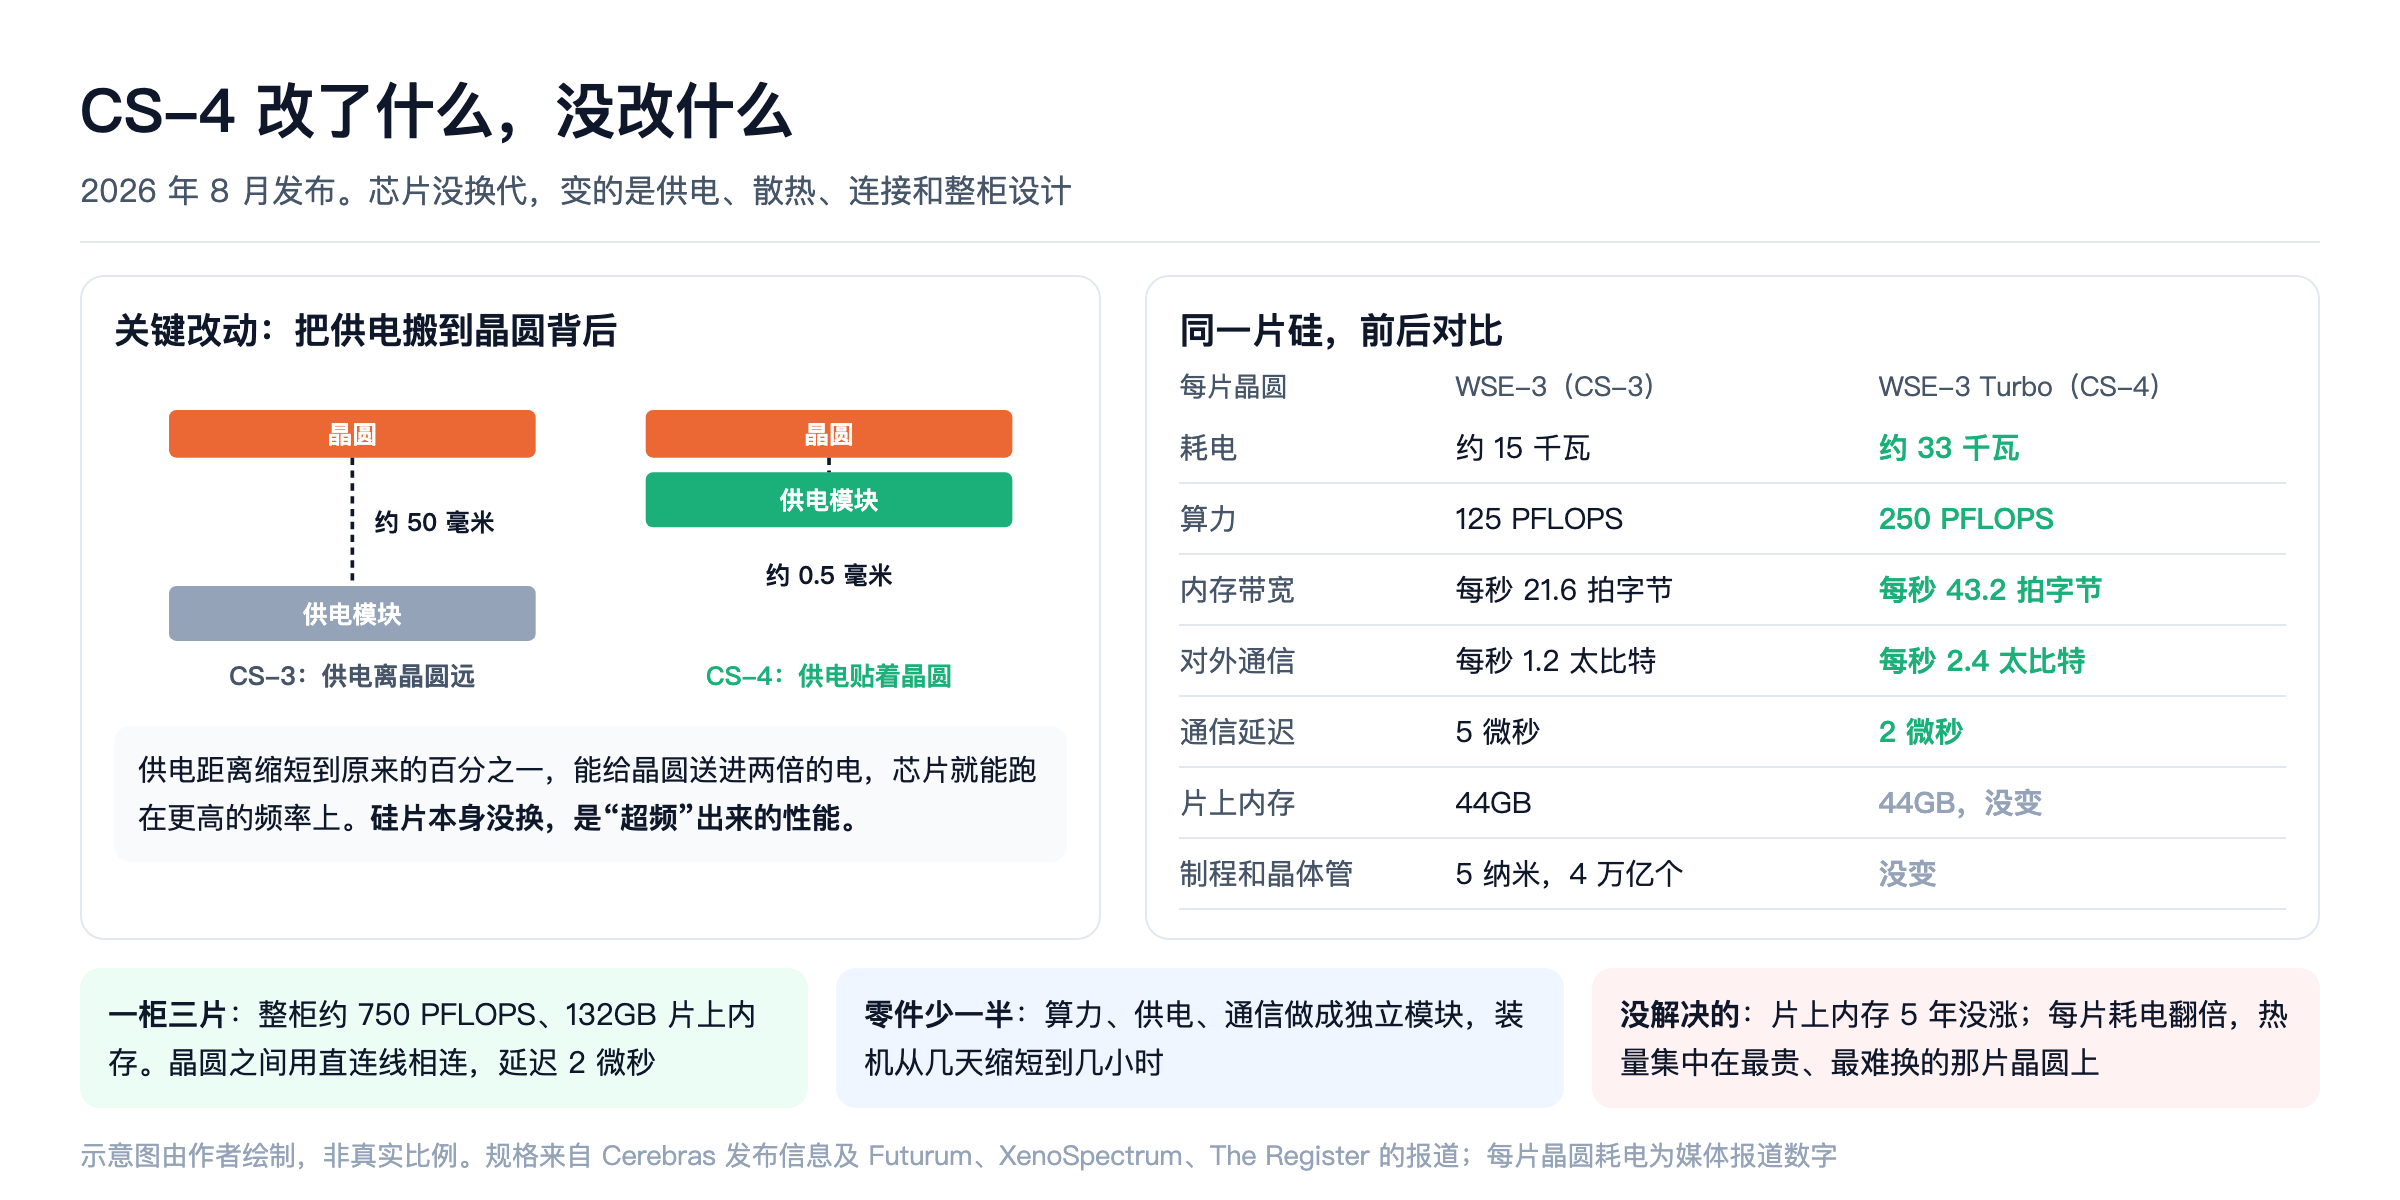
CS-4 是它未来两年业绩的全部指望。它有一个不寻常的地方:里面的芯片没有换代。
它是怎么做到性能翻倍的
CS-4 用的芯片叫 WSE-3 Turbo,和 2024 年的 WSE-3 是同一片硅:同样的台积电 5 纳米,同样的 4 万亿个晶体管、90 万个核心。媒体报道XenoSpectrum
变的是芯片周围的东西:供电和液冷做成一个贴在晶圆背后的模块,供电距离从约 50 毫米缩短到约 0.5 毫米,能送进两倍的电,让芯片跑在更高的频率上。等于给同一颗芯片“超频”。
| 每片晶圆 | WSE-3(CS-3) | WSE-3 Turbo(CS-4) |
|---|---|---|
| 耗电 | 约 15 千瓦 | 约 33 千瓦 |
| 算力 | 125 PFLOPS | 250 PFLOPS |
| 内存带宽 | 每秒 21.6 拍字节 | 每秒 43.2 拍字节 |
| 对外通信 | 每秒 1.2 太比特 | 每秒 2.4 太比特 |
| 通信延迟 | 5 微秒 | 2 微秒 |
| 片上内存 | 44GB | 44GB,没变 |
媒体报道XenoSpectrum媒体报道The Register,2026-08-19
其他三个变化:
- 一柜三片。整柜约 750 PFLOPS、132GB 片上内存;
- 晶圆之间直连,延迟约 2 微秒;更大规模再用标准以太网扩展;
- 模块化。零件比上一代少一半,装机从几天缩短到几小时,为量产做准备。
媒体报道XenoSpectrum
公司自己报的速度:在一个 1,200 亿参数的模型上,每个用户每秒 4,400 个 token 以上,称比 GPU 方案最高快 30 倍;在 10 万亿参数以上的模型上每秒超过 1,000 个 token,这个数是根据内部测量推算的。有独立测试在它的公开接口上测到约每秒 1,715 个 token,条件不同。
三个问题:第三方估算Futurum
- 片上内存没涨。每片还是 44GB,五年没变,原因和出路见 4.5 节;
- 热量集中在最贵的零件上。每片耗电翻倍,而晶圆坏了没法单独换;
- 速度数字不透明。公司没说测试用了几片晶圆、上下文多长、同时服务多少人。
Futurum 的评价是:这是一次“系统发布”,顶替了本该有的“芯片发布”。我的理解是,下一代芯片还没准备好。
4.2 两家其实是同一个思路
GPU 生成文字慢,主要原因是模型放在芯片外面的 HBM 里,每生成一个字都要来回搬数据。
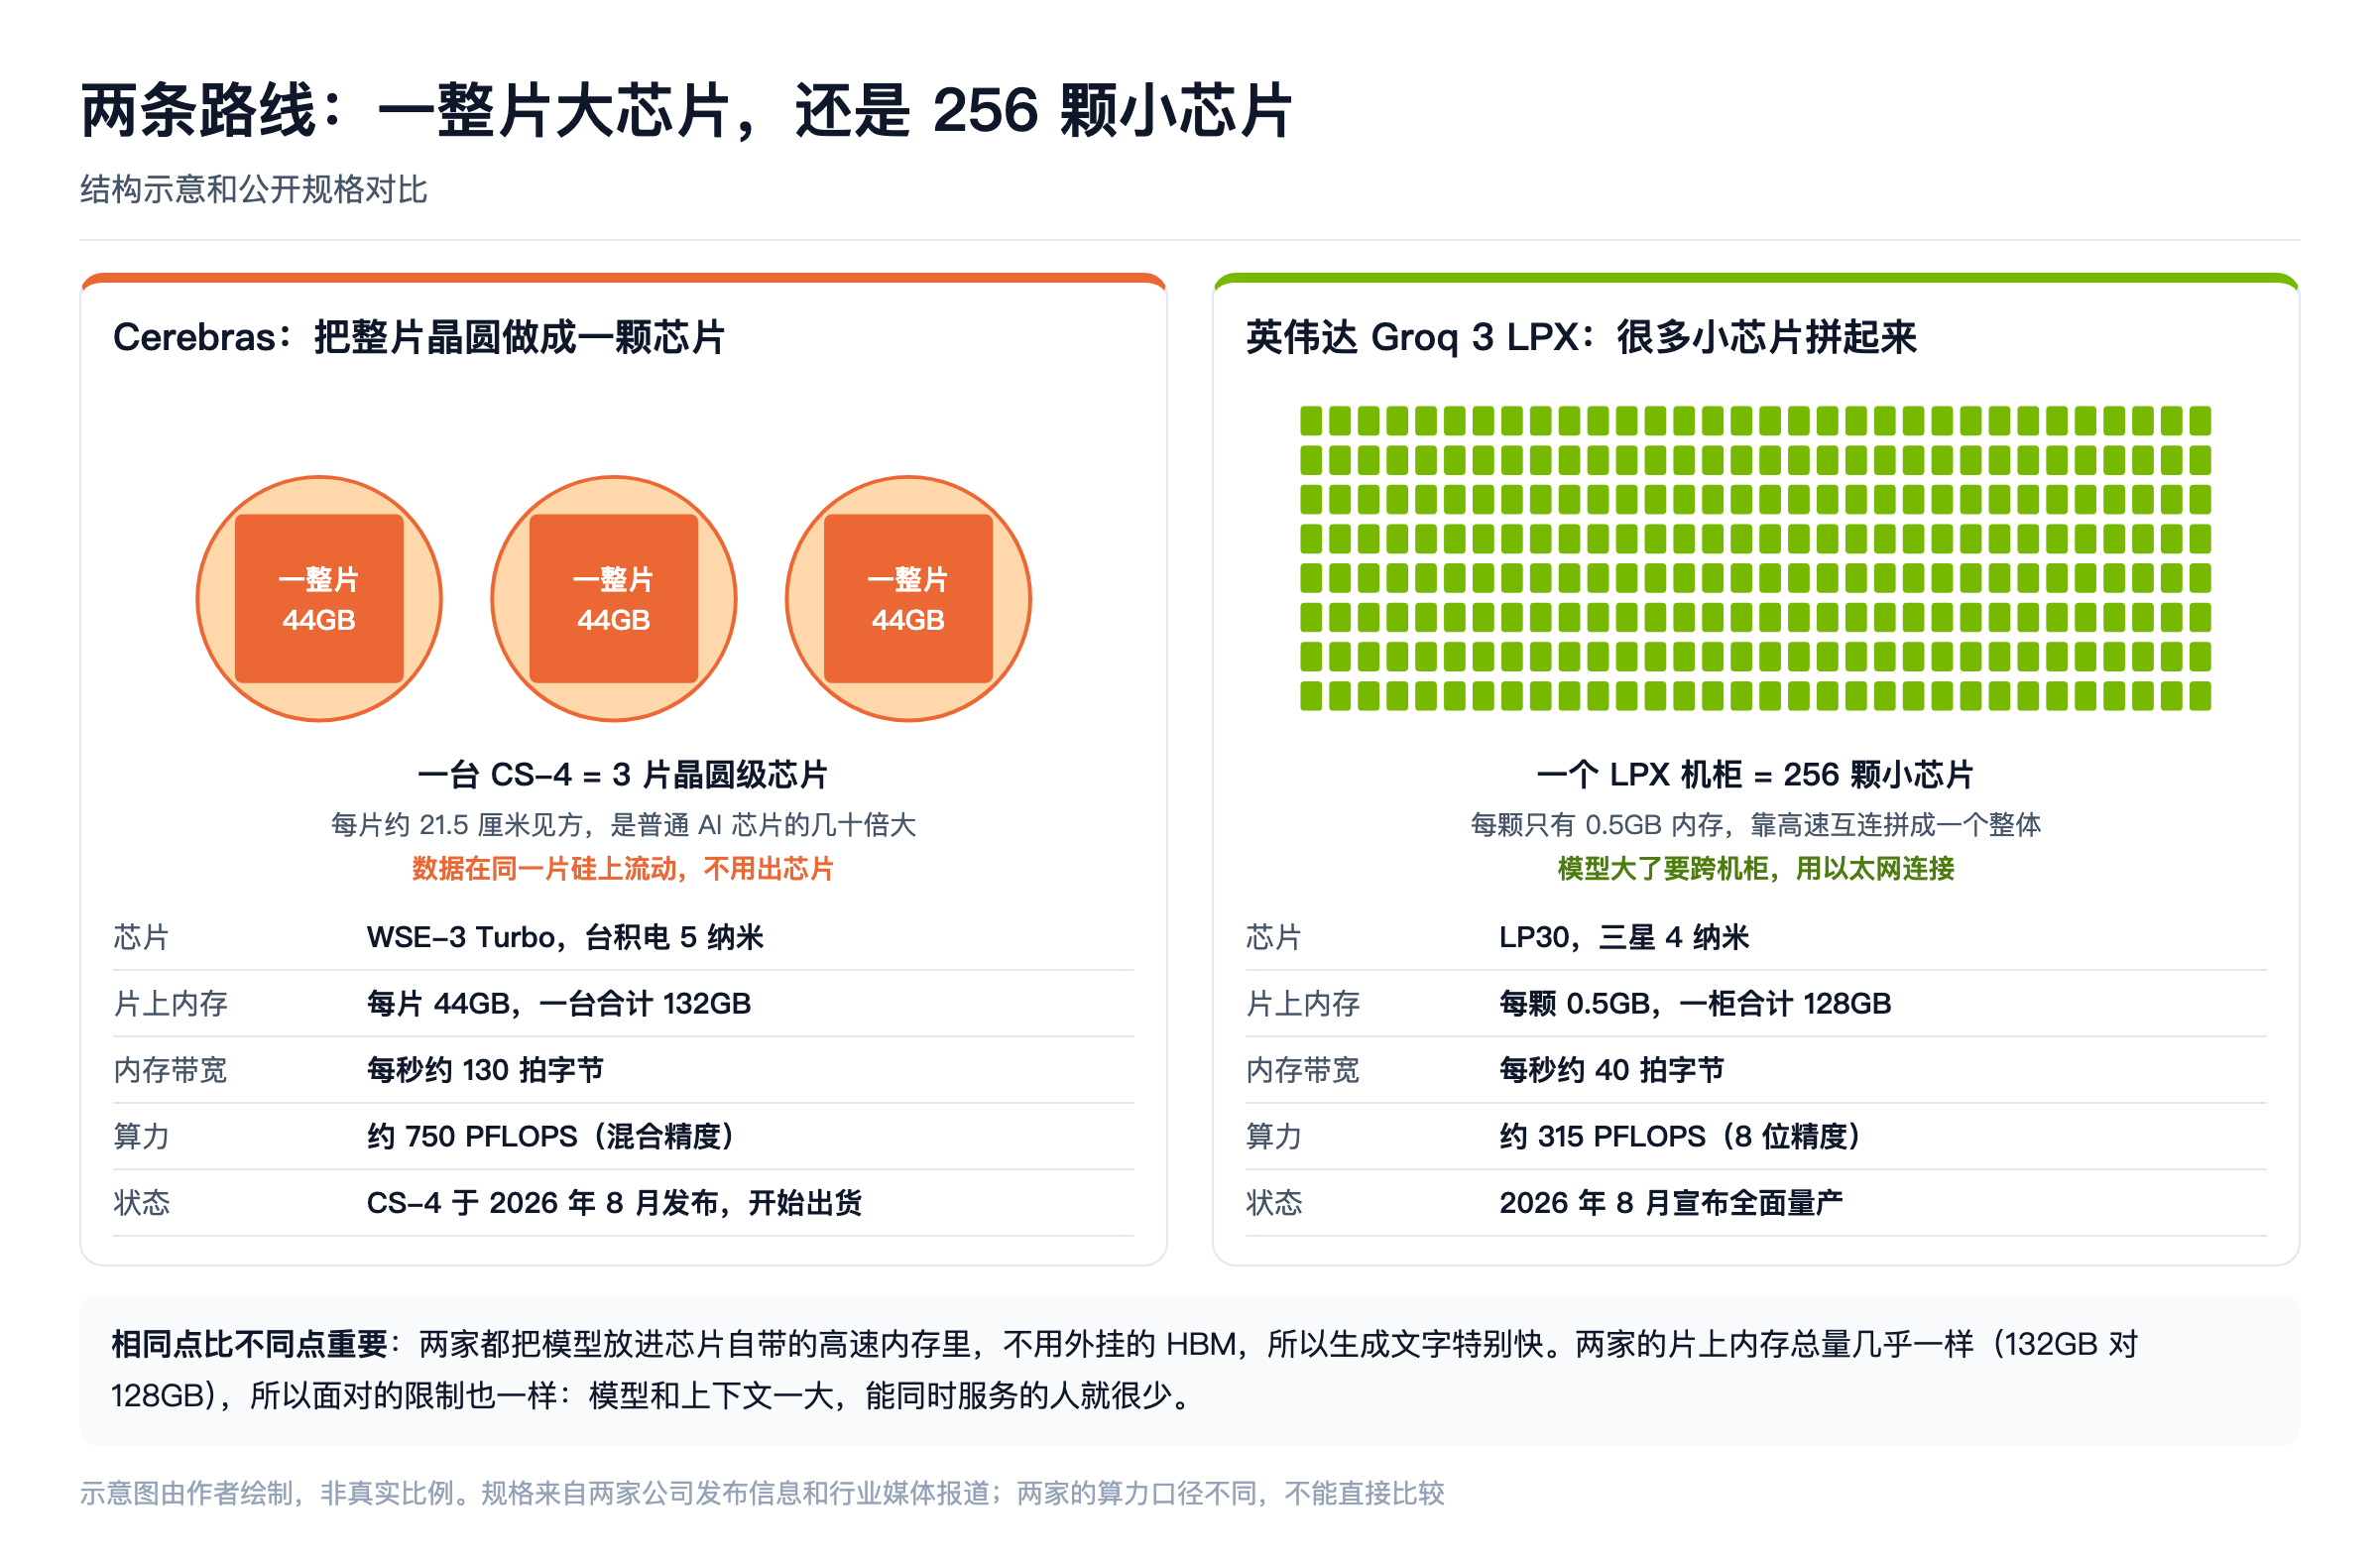
Cerebras 和 Groq 的办法一样:把模型直接放进芯片内部的 SRAM(Static Random-Access Memory,静态随机存取存储器)里。SRAM 比 HBM 快得多,所以生成速度能高出一个数量级。
代价也一样:SRAM 很占地方,容量做不大。
4.3 不一样的地方:一整片,还是很多小片
| 项目 | Cerebras CS-4 | 英伟达 Groq 3 LPX |
|---|---|---|
| 芯片 | 3 片 WSE-3 Turbo,每片是一整片晶圆 | 256 颗 LP30 小芯片 |
| 制造 | 台积电 5 纳米 | 三星 4 纳米 |
| 片上内存 | 每片 44GB,合计 132GB | 每颗 0.5GB,合计 128GB |
| 内存带宽 | 每秒约 130 拍字节 | 每秒约 40 拍字节 |
| 算力 | 约 750 PFLOPS(混合精度) | 约 315 PFLOPS(8 位精度) |
| 芯片之间怎么连 | 同一片硅上,不用出芯片 | 柜内高速互连;跨柜用以太网 |
| 状态 | 8 月发布,开始出货 | 8 月宣布全面量产 |
第三方估算Shattered媒体报道TechTimes,2026-08-25
两家的算力和带宽口径不同,表里的数字不能直接相除得出“谁是谁的几倍”。
一整片的好处:数据不用离开芯片。一个 310 亿参数的模型,Cerebras 用一到两片晶圆就能装下,LPX 至少要 64 颗芯片。媒体报道The Decoder 模型更大时差距更明显:有分析估算,跑一个大型模型,LPX 需要约 1,300 颗芯片,也就是五个机柜,柜与柜之间要走以太网,会拖慢速度。
很多小片的好处:好造、良率高、坏一颗换一颗。
4.4 那句“快 4 倍”是怎么来的
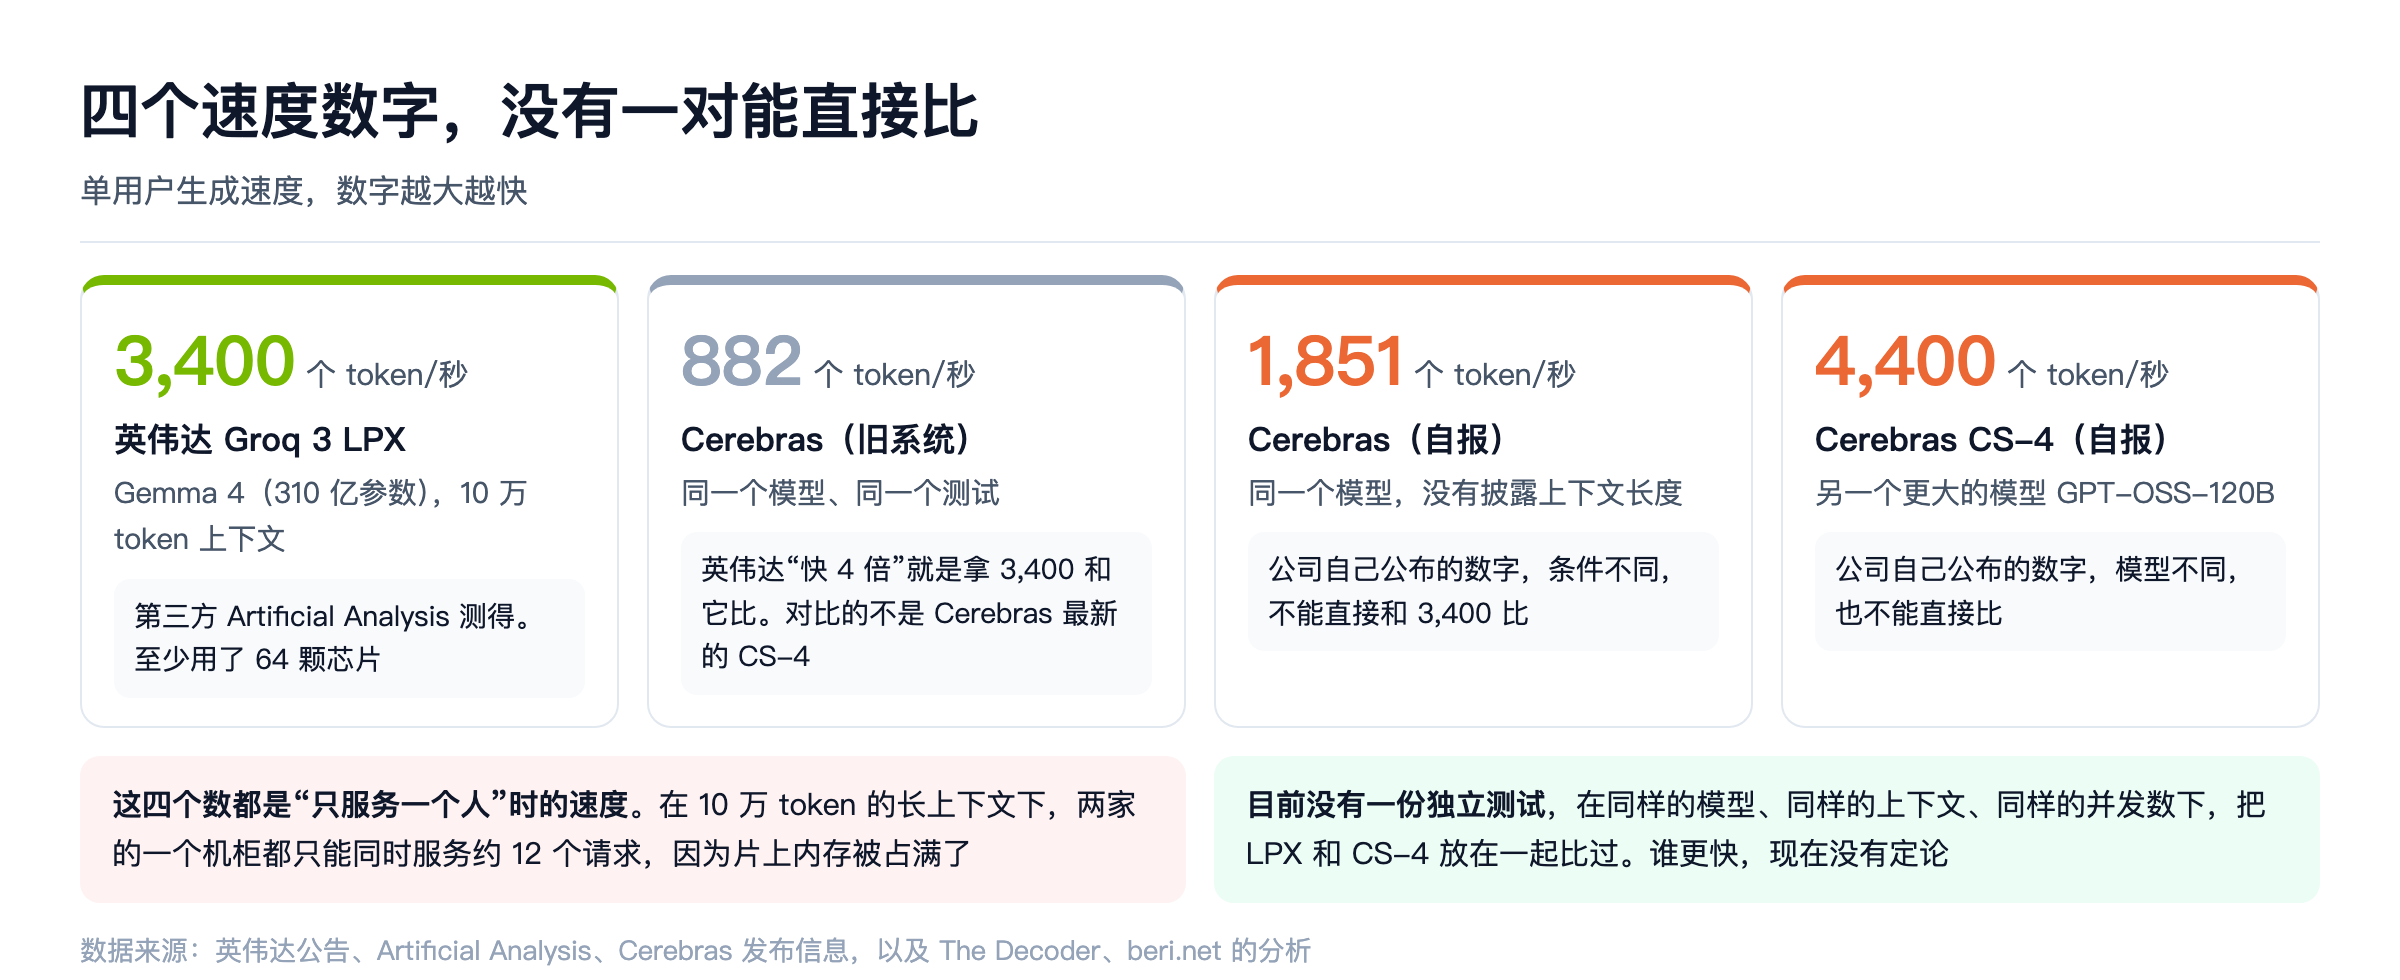
英伟达的数字:LPX 在 Gemma 4(310 亿参数)、10 万 token 上下文的测试里,每秒生成 3,400 个 token,由第三方机构 Artificial Analysis 测得。同一个测试里 Cerebras 是每秒 882 个,所以是“快 4 倍”。
问题在于:媒体报道The Decoder
- 对比的不是 CS-4。这个测试没有包含 Cerebras 最新一代产品;
- 芯片数量差很多。LPX 用了至少 64 颗芯片,Cerebras 只用一到两片;
- 选的是对 LPX 最有利的模型。这个模型刚好能完整放进一个机柜。
Cerebras 自己公布的数字是:同一个模型每秒 1,851 个 token(没说上下文多长),CS-4 在另一个更大的模型上每秒 4,400 个以上。这两个数也是公司自己说的,条件和英伟达的测试不一样。
谁更快,现在没有定论。 没有一份独立测试在同样的模型、上下文和并发条件下把两者放在一起比过。
4.5 两家共同的天花板
有分析算过:10 万 token 的上下文下,每个请求要占约 8GB 片上内存。扣掉模型本身占的约 31GB,两家的一个机柜都只能同时服务约 12 个请求。第三方估算beri.net
上面那些每秒几千个 token 的数字,都是“只服务一个人”时的速度。上下文短的时候情况好很多:8,000 token 的上下文,一个机柜能同时服务约 150 个请求。
这类芯片适合“少数人要极快”,不适合“很多人要便宜”。它是一个高端细分市场,不会取代 GPU。
片上内存能不能加大?能,但要等两代。
常规办法已经走不通:
- 第一代 18GB,第二代 40GB,第三代只到 44GB。晶体管多了约一半,内存只多了 10%;第三方估算SemiAnalysis
- 换先进制程帮不上忙。片上内存的基本单元从 5 纳米到 3 纳米没有缩小,到 2 纳米整体密度也只提高约 10%;媒体报道Tom's Hardware
- 芯片已经是一整片晶圆,没法再做大。剩下的办法只有把计算的面积让给内存。
所以 CS-4 是靠“一柜放三片”把总内存做到 132GB,加的是数量,不是密度。
Cerebras 在 2026 年的 Hot Chips 会议上公布了后两代的路线:公司自报Cerebras 技术文章
| 代次 | 时间 | 要点 |
|---|---|---|
| CS-5 | 目标 2027 年 | 换新一代芯片,沿用 CS-4 的机柜平台。目标是开源模型上每个用户每秒 10,000 个 token,每兆瓦每秒 300 万个 token。制程和内存大小没有公布 |
| CS-6 | 没有公布 | 第一次在晶圆上叠一层 DRAM,用极密的垂直连接接起来。2024 年已开始研发 |
CS-6 的思路比“再加一层”更激进:据报道,它反而会减少每片晶圆上的片上内存,腾出面积放更多计算单元,容量交给叠上去的 DRAM 来补。媒体报道ServeTheHome
怎么看:
- 短板有解,它没有被物理规律锁死;
- 但解在 CS-6,公司没给时间。按一年一代推算最早是 2028 年,这是我的推算;
- 技术风险不小:整片晶圆叠整片晶圆,散热和良率都是难题。而且一旦用上 DRAM,它“完全不碰内存厂”的供应优势会打折;
- 未来两年,它仍要带着这个天花板和英伟达竞争。英伟达把上下文放在旁边 GPU 的 HBM 里,现在就能用。
4.6 真正的差别在芯片之外
| 维度 | Cerebras | 英伟达 |
|---|---|---|
| 解决天花板的办法 | 和 AMD 合作:AMD 的系统做预填充,Cerebras 做解码,预计四季度部署 | 自己打包:GPU 做预填充、存上下文,LPX 只做解码 |
| 软件 | 自己的一套,开发者要适配 | 沿用现有生态,开发者基本不用改 |
| 销售 | 自建云服务;2027 年一季度上亚马逊(AMZN) 的云平台 | 现成的客户关系,直接加进现有订单 |
| 客户集中度 | 二季度前三大客户占 76% | 极分散 |
| 产能 | 自己爬坡,称 2026 年产能提升 10 倍以上 | 三星代工,现有产线 |
英伟达最大的优势是“打包”:客户本来就在买它的 GPU 机柜,加一个 LPX 是顺手的事,而且把上下文存在 GPU 的 HBM 里,正好绕开片上内存的天花板。Cerebras 的应对是找盟友,见第六章。
4.7 供应链:它绕开了最堵的三个环节
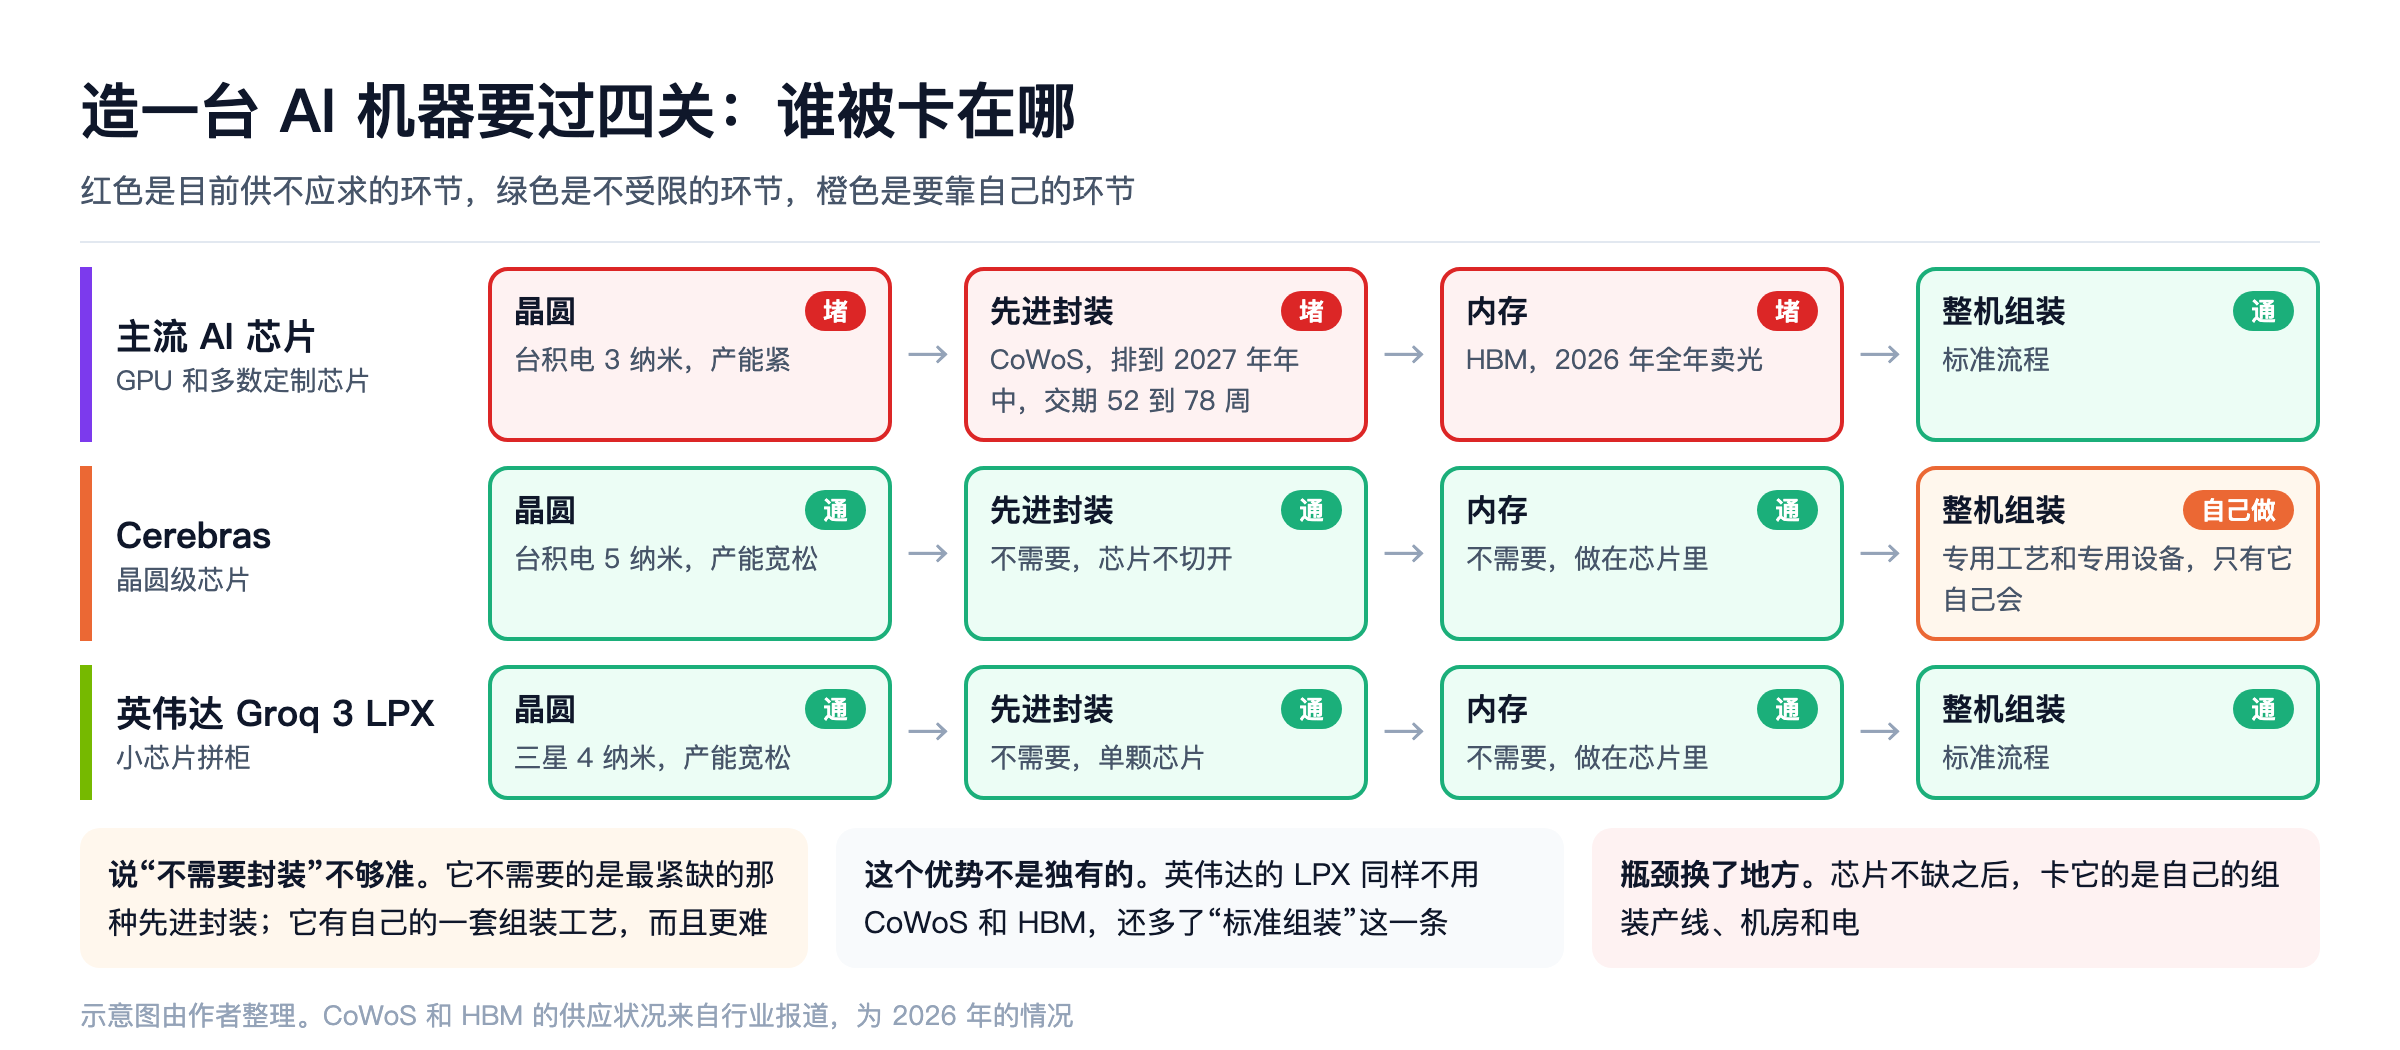
主流 AI 芯片被卡在哪。造一颗主流 AI 芯片要同时拿到三样东西,2026 年三样都缺:
- 先进封装(CoWoS):排到至少 2027 年年中,交期 52 到 78 周,英伟达一家占约六成;第三方估算Silicon Analysts
- HBM:最大的供应商 2026 年全年的产量已经分完;
- 台积电 3 纳米:产能紧。
即使台积电把封装产能扩到每月 12 万到 14 万片,2027 年预计仍有 10% 到 20% 的缺口。第三方估算SupplyICs
Cerebras 三样都绕开了:公司自报Crypto Briefing 转述
- 不用 CoWoS。先进封装是把切好的芯片和内存拼在一起,它的芯片根本不切开;
- 不用 HBM。内存做在芯片里;
- 不抢 3 纳米。用的是不紧张、也更便宜的 5 纳米。
首席执行官说台积电给的晶圆够 2026 年的计划并有余。粗算一下:OpenAI 那 750 兆瓦约需 17,000 片晶圆,分三年,平均每月不到 500 片,对台积电是很小的数。本文推算750 兆瓦 ÷ 每柜 130 千瓦 × 3 片 晶圆不是它的瓶颈。
但有三点要说准
第一,“不需要封装”不准确。 它不需要的是最紧缺的那种先进封装,但有自己的一套组装工艺,而且更难。
它的芯片有 21.5 厘米见方。硅受热膨胀少,电路板膨胀多,温度变化 65 度时边角位移约 122 微米,是常规焊接能承受的 5 到 7 倍。第三方估算Peak FLOPS 所以要用冷却板、晶圆、一层自己发明的连接材料、电路板四层叠起来,供电从背后垂直送入,电流超过 2 万安培。组装设备是它自己造的。
也就是说,它不用排别人的队,但自己就是那条队。公司说 2026 年产能要提升 10 倍以上,在三家代工厂新增了产线,目前没有大批量出货的记录可以验证。
第二,这个优势不是它独有的。 英伟达的 LPX 同样不用 CoWoS 和 HBM:单颗芯片,内存做在芯片里,三星 4 纳米代工,产线也不紧张,而且用的是标准封装和标准组装。媒体报道Tom's Hardware 报道称三星已把相关晶圆产量从约 9,000 片提高到约 15,000 片。媒体报道SamMobile 相对 GPU 这是优势,相对 LPX 不是。
第三,同一个设计选择,也是它短板的来源。 不用 HBM,所以不受缺货影响;也正因为不用 HBM,内存只有每片 44GB。另外,它和 AMD、亚马逊搭配的方案里,对方那部分芯片照样要用 CoWoS 和 HBM。
这个优势值多少:现在很值钱,别人交期一年以上时,能更快交货本身就是卖点。但它有保质期,台积电和内存厂都在扩产。而且它解决的是“能不能造出来”,Cerebras 现在更大的问题是机房、电和订单。
4.8 我的评分
| 项目 | 谁占优 | 把握程度 |
|---|---|---|
| 单芯片技术难度和独特性 | Cerebras | 高 |
| 大模型的速度 | Cerebras | 中。逻辑上占优,缺独立数据 |
| 小模型的速度 | 说不清 | 低。没有同条件测试 |
| 是否受先进封装和 HBM 缺货影响 | 两家都不受 | 高。相对 GPU 是共同优势 |
| 量产难度和规模 | 英伟达 | 高。LPX 是标准组装,Cerebras 要自建专用产线 |
| 软件和易用性 | 英伟达 | 高 |
| 销售和客户关系 | 英伟达 | 高 |
| 每瓦、每美元的产出 | 说不清 | 低。两家都没给可比数字 |
| 机房建设和改造成本 | 打平 | 高。详见第五章 |
这张表是我的判断,不是测试结果。Cerebras 在芯片本身没有输,输的可能性在芯片以外。
五、放进机房:改造和建设成本
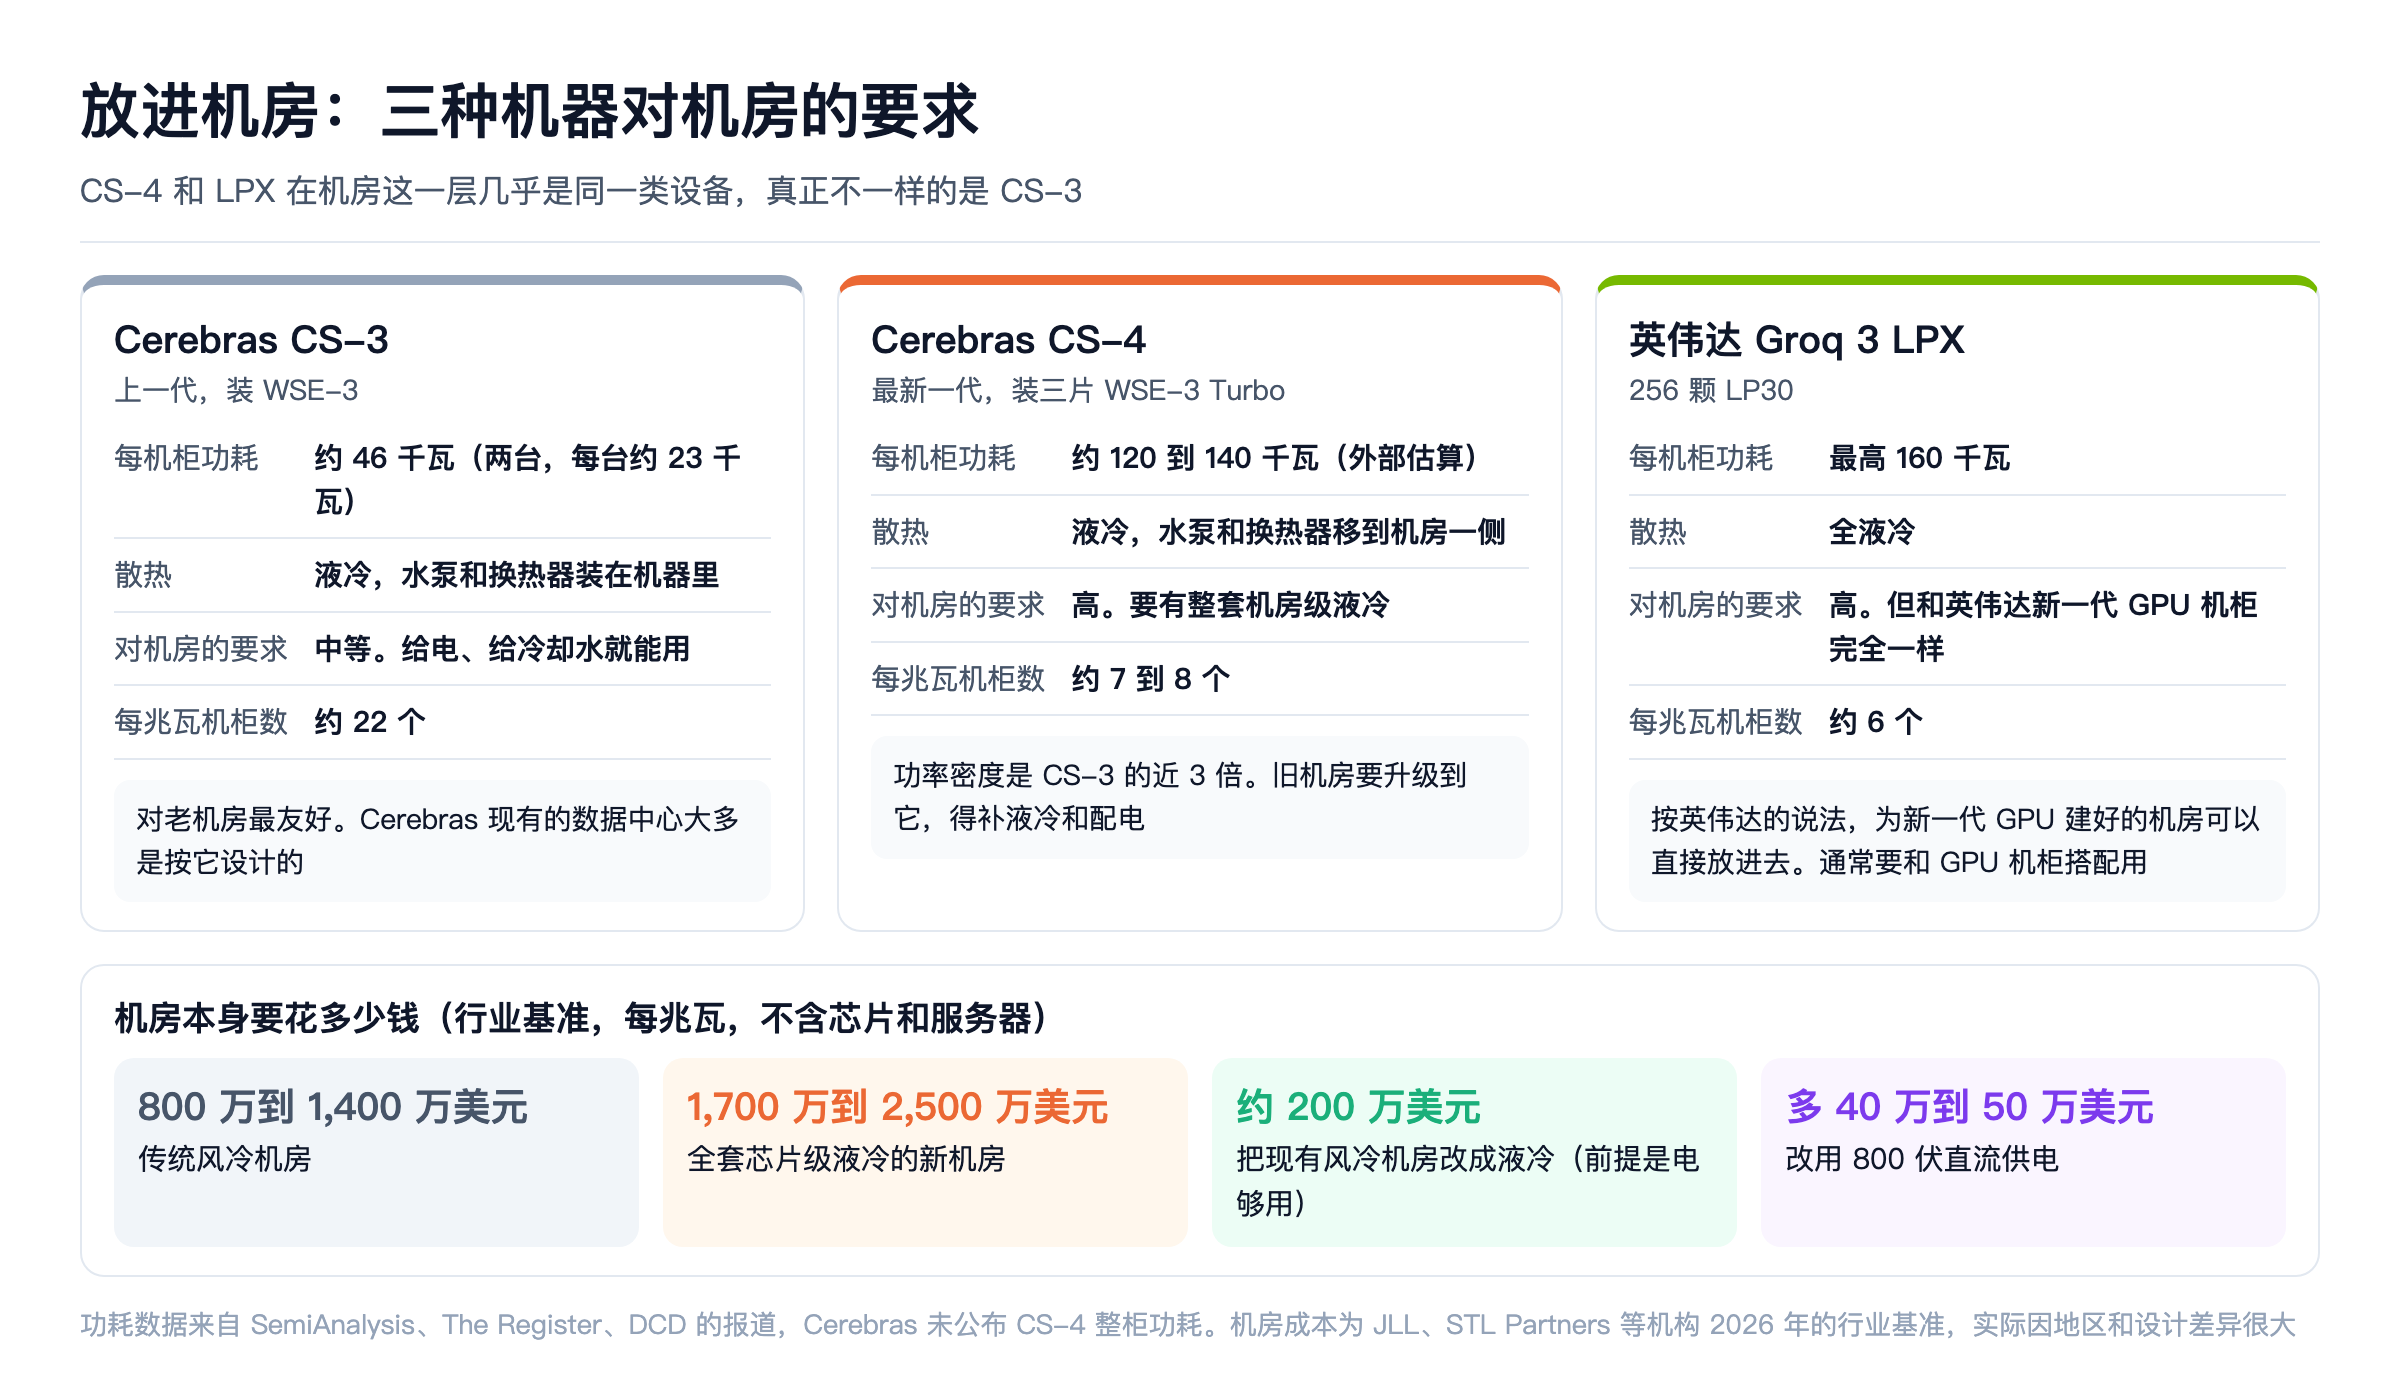
最新一代的 CS-4 和 LPX 对机房的要求几乎一样,机房本身的成本拉不开差距。差距在三个地方:手里是什么机房、要不要搭配别的机柜、谁出钱。
5.1 三种机器的机房要求
| 项目 | Cerebras CS-3 | Cerebras CS-4 | 英伟达 Groq 3 LPX |
|---|---|---|---|
| 每机柜功耗 | 约 46 千瓦(两台,每台约 23 千瓦) | 约 120 到 140 千瓦 | 最高 160 千瓦 |
| 散热 | 液冷,水泵和换热器在机器里 | 液冷,水泵和换热器移到机房一侧 | 全液冷 |
| 机柜规格 | 自有规格 | 自有规格 | 英伟达通用机柜规格,和新一代 GPU 机柜相同 |
| 每兆瓦机柜数 | 约 22 个 | 约 7 到 8 个 | 约 6 个 |
第三方估算SemiAnalysis媒体报道The Register,2026-08-19媒体报道DCD
CS-4 的整柜功耗是外部估算;每兆瓦机柜数是我用 1,000 千瓦除以每柜功耗算的。
变化最大的是 Cerebras 自己。CS-3 自带散热,每柜不到 50 千瓦,不挑机房。CS-4 把散热交给机房,功率密度涨到近 3 倍,变得和英伟达一样要高密度液冷机房。
5.2 机房本身的价格
下面是 2026 年的行业基准,都是每兆瓦、不含芯片和服务器:
| 情形 | 每兆瓦成本 | 说明 |
|---|---|---|
| 传统风冷机房 | 800 万到 1,400 万美元 | 放不了 CS-4 和 LPX |
| 全套芯片级液冷的新机房 | 1,700 万到 2,500 万美元 | CS-4 和 LPX 都需要这一档 |
| 把现有风冷机房改成液冷 | 约 200 万美元 | 前提是电力够用;工期通常超过 6 个月 |
| 改用 800 伏直流供电 | 多 40 万到 50 万美元 | 英伟达下一代更高功率机柜的方向 |
第三方估算Axis Intelligence 汇总第三方估算STL Partners
改造那 200 万美元只是工程费,还没算停机损失、配电扩容和楼板承重。第三方估算DataCenterScope 最硬的约束是电。 CS-4 和 LPX 属于同一个功率档次,建一兆瓦的新机房,放哪一种成本基本一样。
5.3 三种情形下谁更省
- 已经有为英伟达新一代 GPU 建好的机房:LPX 占优。英伟达特意把 LPX 的功耗做成和 GPU 机柜一样,机柜规格、供电、液冷接口都通用。公司自报英伟达,DCD 转述 CS-4 也放得进去,但它是另一套机柜、备件和维护流程;
- 老的风冷机房:两家都要先改造,成本一样。这时 CS-3 反而最合适,但它的速度只有 CS-4 的一半;
- Cerebras 自己的旧机房:2025 年建的那批是按 CS-3 设计的,比如俄克拉何马城那座 10 兆瓦的机房。媒体报道DCD 换成 CS-4,每柜功耗从约 46 千瓦涨到约 130 千瓦,按改造基准 10 兆瓦约需 2,000 万美元,外加半年以上工期。本文推算基于行业改造基准
而且换完之后,同样的电未必多产出多少 token:SemiAnalysis 认为 CS-4 的每瓦性能比 CS-3“最多略有改善”,Cerebras 自己说提升 10 倍,目前没有独立数据裁决。第三方估算SemiAnalysis 更合理的做法是老机房继续跑 CS-3,新机房直接上 CS-4。
5.4 容易漏掉的一笔账:LPX 不是单独用的
每兆瓦造价一样,不等于每个 token 的机房成本一样。
- LPX 按英伟达的定位要和 GPU 机柜搭配。技术上可以单独跑模型,但英伟达不这么卖;媒体报道The Register,2026-03-19
- 模型越大,LPX 机柜越多。跑万亿参数级的模型要 4 到 8 个机柜,也就是 640 到 1,280 千瓦,再加搭配的 GPU 机柜;
- Cerebras 可以单独完成整个推理,但它也在推和 AMD 搭配的方案,同样要加机柜。
一个“极速推理单元”实际占多少兆瓦,两家都没有公布可比的数字。 这是比较成本时最大的空白。
5.5 Cerebras 自己怎么建:只租不买,多点开花
对英伟达,机房是客户的事。Cerebras 六成收入来自云服务,机房要自己背。
它的路线:不自己盖楼,和很多家中小开发商签长期租约,机器是自己的。
已知的机房
| 地点 | 规模 | 合作方 | 状态和条款 |
|---|---|---|---|
| 美国俄克拉何马城 | 10 兆瓦 | Scale Datacenters | 2025 年 9 月启用 |
| 美国亚拉巴马州哥伦比亚纳 | 40 兆瓦 | Digi Power X | 10 年约 11 亿美元;2026 年 12 月先交 15 兆瓦,2027 年一季度交齐,后半段取决于对方融资 |
| 美国明尼苏达州 | 40 兆瓦 | CleanCore Solutions | 10 年托管协议 |
| 加拿大魁北克圣热罗姆 | 未披露 | Bit Digital | 在建,建成后租给 Cerebras |
| 加拿大里贾纳、曼尼托巴 | 未披露 | 贝尔加拿大等 | 租用或规划中 |
| 美国加州、达拉斯、明尼阿波利斯 | 未披露 | 部分与阿联酋 G42 合作 | 已运行 |
| 芬兰米凯利 | 165 兆瓦 | Compute Nordic Finland | 2026 年 8 月宣布,首期 50 兆瓦已开工 |
| 圭亚那 | 最多 100 兆瓦 | 圭亚那政府 | 谅解备忘录,烧天然气,计划 2027 年初运行 |
第三方估算Baxtel 汇总媒体报道TradingView,Digi Power X 公告媒体报道DCD公司自报Cerebras,2026-08-31媒体报道DCD
公司的说法是:已运行加已签约、2027 年底前交付的容量超过 600 兆瓦,另有“以吉瓦计”的储备项目。公司自报二季度财报新闻稿
从这张表能看出四件事
1. 单个机房都不大。几十兆瓦一个,最大的芬兰项目 165 兆瓦。好处是批得快、接电容易;坏处是分散,运维成本高。
2. 房东多是中小开发商,有几家是比特币矿企转型的,手里有现成的电。风险是它们融资能力有限:亚拉巴马项目的后半段,公告里就写明“取决于第二期融资”。
3. 往电便宜、好批的地方走:加拿大、芬兰、圭亚那。
4. 在做“主权 AI”:帮一个国家建自己的算力中心,是差异化市场,但规模有限。
租金要多少
亚拉巴马的合同给了一个参照:40 兆瓦、10 年、约 11 亿美元,摊下来每兆瓦每年约 275 万美元。这个数里含一次性的建设费用,实际月租会低一些。本文推算合同总额 ÷ 兆瓦 ÷ 年数
750 兆瓦都按这个价租,一年约 20 亿美元;OpenAI 的合同按 200 亿美元、4 年粗算,每年约 50 亿美元。租金大约吃掉四成收入,还没算电费和芯片折旧。 两头的实际数字都没有公开。
有一个缓冲:按财报的描述,OpenAI 协议里把机房租金、装修、电费等列为可以转给 OpenAI 承担的成本。公司自报二季度 10-Q 具体怎么转、转多少,文件没有细说。
钱从哪来
| 项目 | 金额 | 说明 |
|---|---|---|
| 经营租赁负债 | 5.69 亿美元 | 6 月底已经起租的租约,折成现值 |
| 上半年新增租约 | 3.18 亿美元 | 半年里新签并起租的 |
| 上半年资本开支 | 5.49 亿美元 | 主要是自己的机器和机房装修 |
| 在建工程 | 6.04 亿美元 | 年初是 1.64 亿美元,半年翻了近四倍 |
| OpenAI 借款 | 约 10 亿美元 | 合同规定只能用于建设相关的基础设施 |
| 循环信贷额度 | 8.5 亿美元 | 用途之一是给房东和开发商开信用证,尚未动用 |
公司自报二季度 10-Q
已签但 6 月底还没起租的租约没有计入负债,所以账面数字低估了真实的租金承诺。
进度够不够
OpenAI 的交付时间表是:2026 年底前 250 兆瓦,2027 年底前累计 500 兆瓦,2028 年底前累计 750 兆瓦。媒体报道DCD
Cerebras 说 2027 年底前有 600 兆瓦以上。600 减 500,留给其他所有客户的只有约 100 兆瓦。本文推算公司容量 − OpenAI 交付量 所以它还在不停地签新机房,给亚马逊的方案也是把机器放进对方的数据中心。
我的看法
- 这条路线是对的,也是唯一走得通的。它没有云厂商的资产负债表,只能用速度换规模;
- 最大的风险是交付。2026 年底要交 250 兆瓦,而行业今年有三到五成的项目延期(见《建一座 AI 算力中心》),它的房东又多是小公司;
- 第二个风险是租约比合同长。租约 10 年,OpenAI 的合同 3 到 5 年。
5.6 这一章的结论
| 问题 | 结论 | 把握程度 |
|---|---|---|
| 新建机房,放 CS-4 还是 LPX 更贵 | 基本一样,都是高密度液冷 | 高 |
| 已有英伟达新机房,加哪个更省事 | LPX | 高 |
| 老风冷机房,哪个更省 | 都要改造,成本一样 | 高 |
| 每个 token 摊到的机房成本谁低 | 说不清,缺同条件的每兆瓦产出数据 | 低 |
| 机房这件事对谁的财务压力大 | Cerebras,因为它要自己运营 | 高 |
| Cerebras 的建设路线 | 只租不买,多个中小机房;2027 年底前 600 兆瓦,其中约 500 兆瓦要交给 OpenAI | 中。条款多数未公开 |
六、和巨头的合作:OpenAI、亚马逊、AMD 和中东
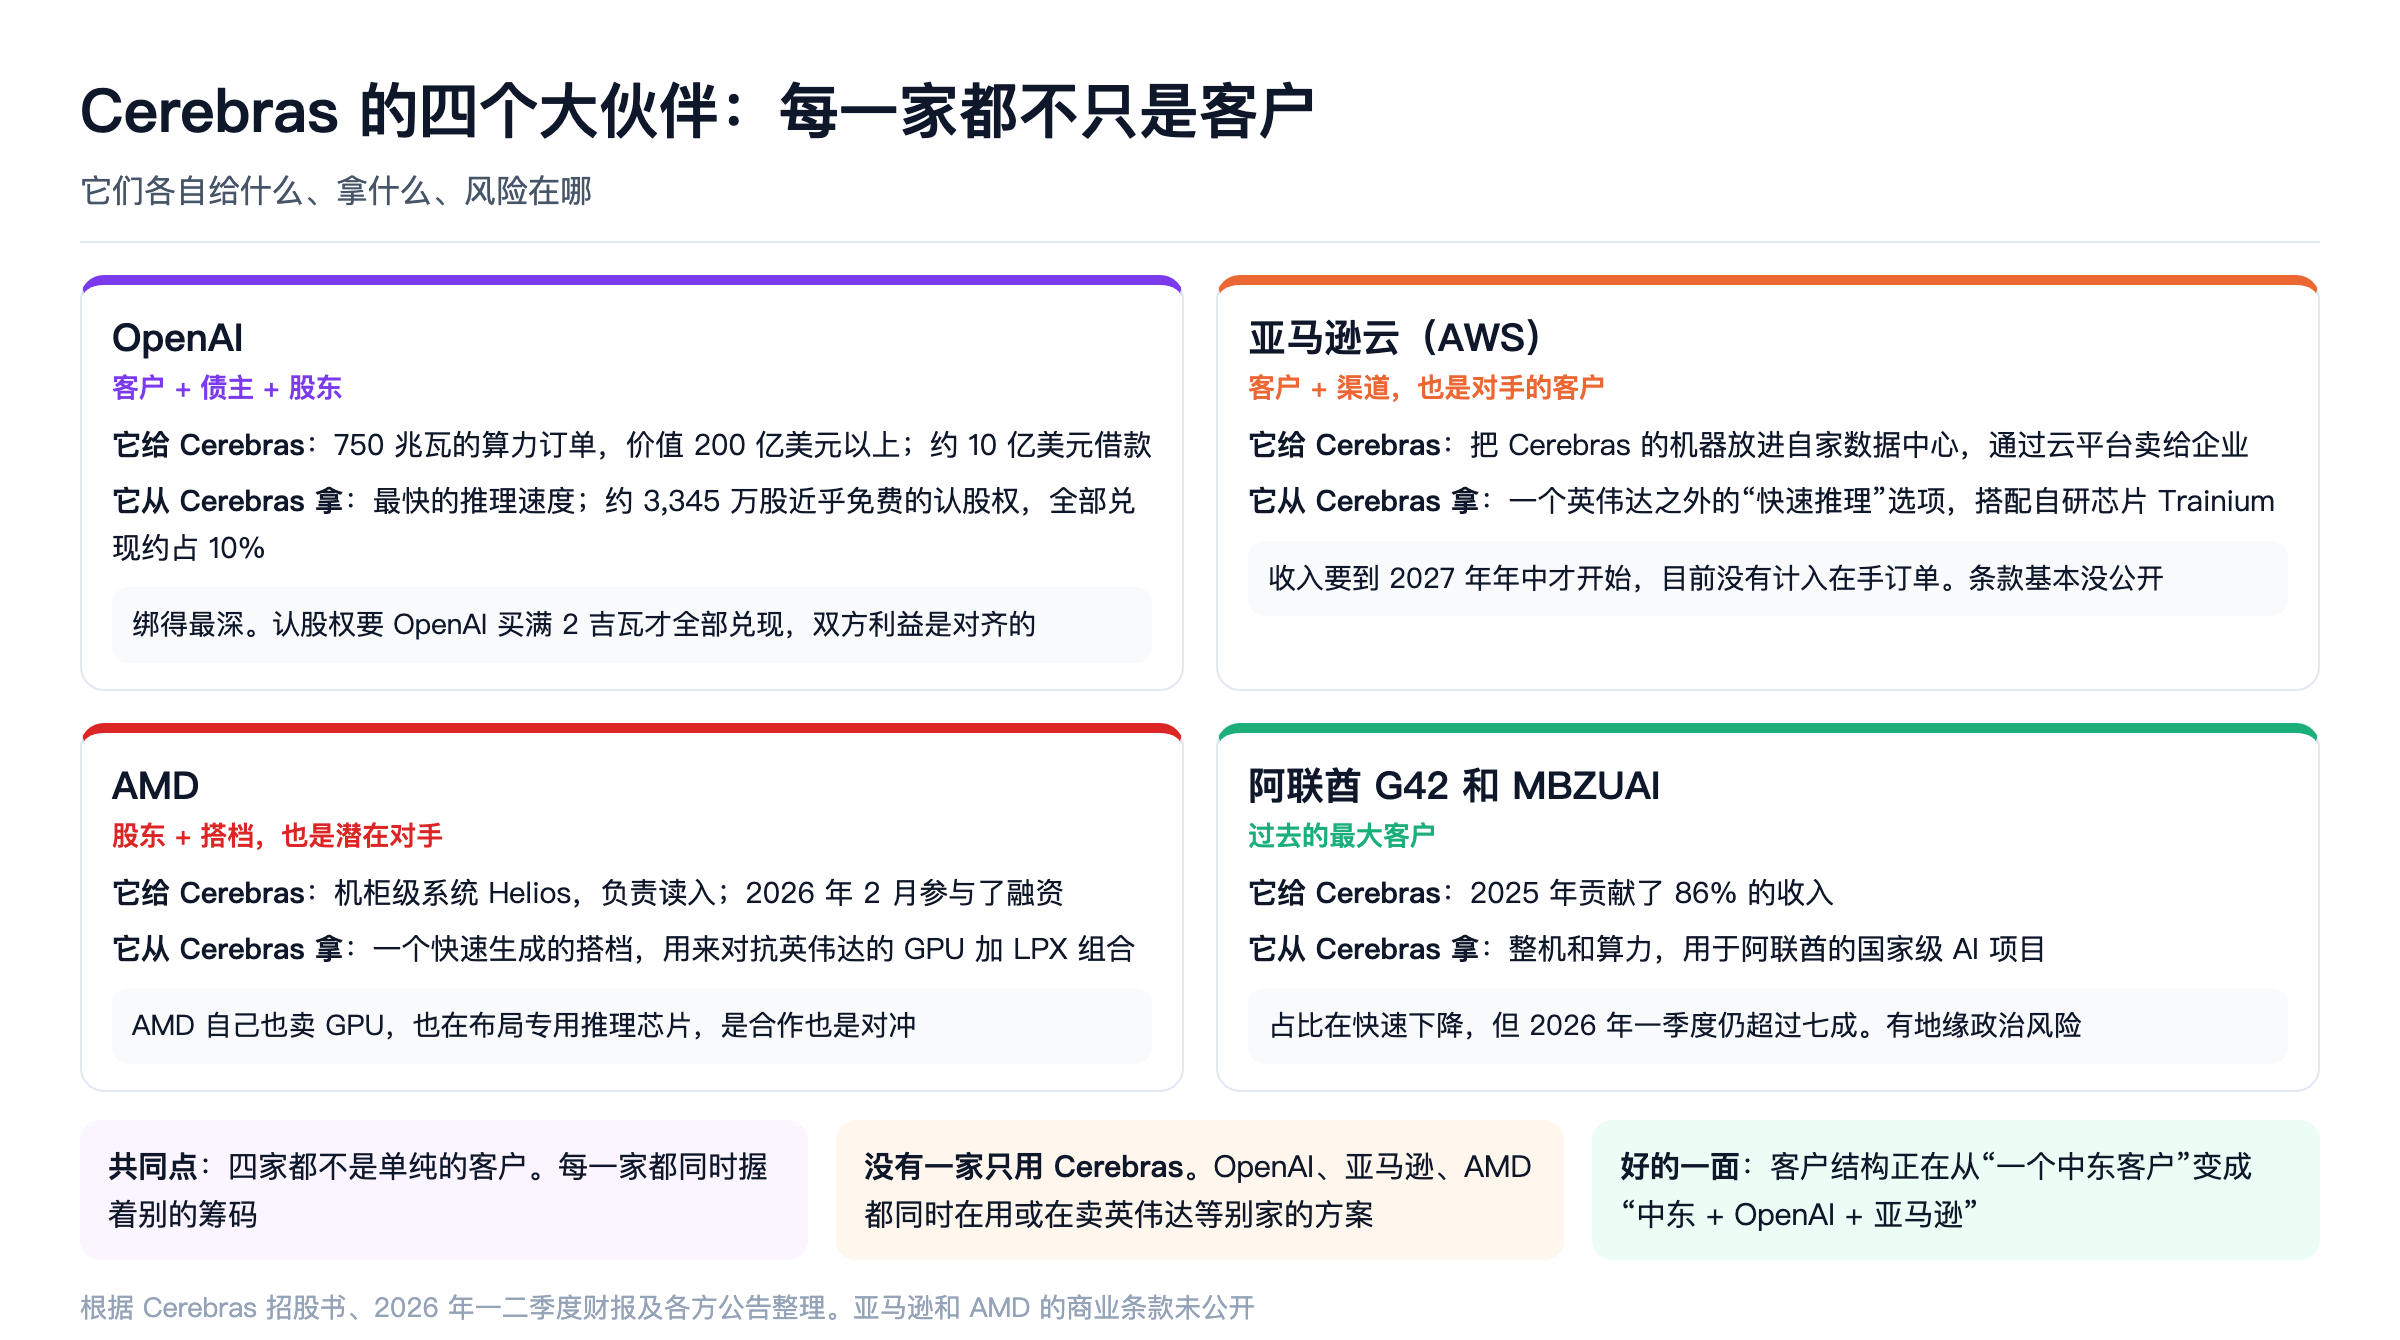
Cerebras 的生意由四段关系撑着,没有一家只是单纯的客户。
6.1 OpenAI:客户、债主、股东三合一
协议内容。2025 年 12 月签的主协议:公司自报二季度 10-Q第三方估算Futurum 招股书解读
| 条款 | 内容 |
|---|---|
| 承诺采购 | 750 兆瓦推理算力,价值 200 亿美元以上 |
| 交付节奏 | 2026、2027、2028 年底前各交 250 兆瓦 |
| 追加选择权 | 2030 年底前可再买 1.25 吉瓦,合计最多 2 吉瓦 |
| 期限 | 3 到 4 年,OpenAI 可延长到最多 5 年 |
| 借款 | 约 10 亿美元,年利率 6%;用交付算力来还的话,利息免掉 |
| 认股权 | 最多约 3,345 万股无投票权股票,行权价几乎为零,全部兑现约占 10% |
| 认股权怎么兑现 | 和商业里程碑、市值里程碑挂钩;要全部兑现,OpenAI 必须把 2 吉瓦买满 |
| 成本转嫁 | 机房租金、装修、电费等可以转给 OpenAI 承担 |
已经发生的:
- 二季度来自 OpenAI 的收入是 5,680 万美元,约占当季收入的 32%;本文推算5,680 万 ÷ 1.801 亿
- 借款已经用算力抵掉了 8,630 万美元,6 月底还剩 9.18 亿美元;
- OpenAI 在 7 月行权了约 1,003 万股;
- 落地的产品是 OpenAI 的极速档,公司说比标准档最高快 14 倍。公司自报二季度财报新闻稿
怎么看这个结构
好的一面:认股权把两家的利益绑在了一起。OpenAI 买得越多,拿到的股份越多。这和 Marvell 给谷歌的认股权是同一种设计。
要警惕的三点:
- Cerebras 是在用股权换订单。约 10% 的股份几乎白送,代价由其他股东承担。按会计准则,这部分还要冲减收入;
- 约束是单向的。OpenAI 必须买的只有 750 兆瓦,后面的 1.25 吉瓦是“可以买”。而 Cerebras 必须按时交付:有分析指出,如果它交不出来或性能不达标,OpenAI 可以控制那笔借款资金;第三方估算Futurum 招股书解读
- OpenAI 自己的风险。它还在亏损,同时和英伟达、AMD、博通都签了大单。
9 月底“极速档改用英伟达”的传闻杀伤力大,打的正是“那 1.25 吉瓦会不会被用掉”这个预期。
6.2 亚马逊:把机器放进别人的机房
合作内容。2026 年 3 月 17 日宣布,是一份有约束力的多年协议:公司自报Cerebras 公告第三方估算Futurum
- Cerebras 的机器直接放进亚马逊云(AWS)自己的数据中心,由亚马逊运营;
- 两家的芯片分工:亚马逊自研的 Trainium 负责读入,Cerebras 负责快速生成;
- 通过亚马逊的模型平台 Bedrock 卖给企业客户,客户不用改接口;
- 亚马逊是第一家这样做的大型云厂商。
时间表:管理层在二季度电话会上说,机器已经部署进亚马逊的数据中心,2027 年一季度在 Bedrock 上线,2027 年年中开始有收入。这部分收入目前没有计入 254 亿美元的在手订单。公司自报二季度电话会
这笔合作为什么重要
- 不占自己的机房,用的是亚马逊的地和电;
- 借到了销售渠道。Bedrock 上有大量现成的企业客户,这是它自己建不起来的;
- 是在手订单之外的增量。
没公开的更多:金额、定价、谁出钱买机器、有没有排他、有没有给亚马逊认股权,都没有披露。招股书的解读里没有提到给亚马逊的股权安排。
亚马逊也可能是未来的对手。它有自研芯片的习惯,今天用 Cerebras 补这一块,不代表五年后不会自己做。
6.3 AMD:股东兼搭档
- 2026 年 2 月,AMD(AMD) 参与了 Cerebras 上市前的最后一轮融资;
- 7 月 24 日,两家宣布联合方案:AMD 的机柜级系统 Helios 负责读入和长上下文,Cerebras 负责生成;媒体报道Yahoo Finance
- 公司称这种组合每瓦产出的 token 最高是纯 Cerebras 方案的 5 倍,预计 2026 年四季度在 Cerebras 自己的云上部署。
英伟达卖的是“GPU 加 LPX”的组合。AMD 有 GPU 没有快速解码芯片,Cerebras 正好相反,两家拼起来才能对打。但 AMD 据报道也在布局专用的推理芯片。第三方估算Futurum
6.4 阿联酋:过去的全部,现在的包袱
只更新数字:
| 时期 | MBZUAI | G42 | 合计 |
|---|---|---|---|
| 2025 年全年 | 62% | 24% | 86% |
| 2026 年一季度 | 63% | 11% | 74% |
| 2026 年二季度 | 公司未点名;前三大客户分别占 34%、32%、10% |
公司自报招股书和季报,Futurum、FinanceFeeds 转述
MBZUAI 是阿布扎比的一所人工智能大学,G42 是阿联酋的科技集团,两者是关联方。二季度那个 32% 和 OpenAI 的收入对得上,34% 的那家很可能仍是 MBZUAI。这是我的推断。
方向是对的:一年前几乎全部收入来自阿联酋,现在 OpenAI 已经占到三成。但只是从依赖一个客户,变成依赖两个。
6.5 其他渠道和客户
- 分发渠道:亚马逊和微软(MSFT) 的云市场、IBM、Vercel、OpenRouter、Hugging Face 等平台上都能调用 Cerebras 的服务;
- 点名的企业客户:Cognition、Lovable、Block、Figma、AlphaSense、葛兰素史克、CrowdStrike;
- 二季度公司说签了 6 笔单笔 3,000 万美元以上的合同。
单个都不大,但说明大客户之外有了长尾。
6.6 把四段关系放在一起
| 伙伴 | 关系 | 钱的规模 | 确定性 | 谁更需要谁 |
|---|---|---|---|---|
| OpenAI | 客户、债主、股东 | 200 亿美元以上 | 750 兆瓦是合同;1.25 吉瓦是选择权 | Cerebras 更需要 OpenAI |
| 亚马逊 | 客户、渠道 | 未披露 | 有约束力的协议,但收入要到 2027 年年中 | Cerebras 更需要亚马逊 |
| AMD | 股东、搭档 | 未披露 | 四季度部署 | 互相需要 |
| 阿联酋 | 老客户 | 2025 年约占 86% | 占比下降中 | 在变弱 |
我的看法:
- Cerebras 在每一段关系里都是弱势的一方;
- 最有价值的是亚马逊这条线:不占机房、自带客户、还没被算进预期,但也最看不清;
- OpenAI 这条线决定生死。后面那 1.25 吉瓦买不买,取决于 OpenAI 觉得“更快”值不值得多付钱;
- 判断这家公司,其实是在判断这几家巨头的意图。英伟达的客户有几百家,Cerebras 的命运握在三四家手里。
七、它到底适合干什么:推理、智能体,和三道坎
7.1 是不是特别适合推理
是的,但只适合其中一段。 推理分两段:读入拼的是算力,GPU 擅长;生成拼的是内存读取速度,这是 Cerebras 的强项(原理见 4.2 节)。它主动找 AMD、亚马逊搭档,让对方负责读入,等于自己也承认强项就在生成这一段。
不适合它的推理有三种:很多人同时用、不赶时间的;模型特别大的;速度够用就行的。原因都是片上内存小(见 4.5 节)。
它最早是做训练的,但英伟达的软件生态太强,没有打进去。2024 年以后整体转向推理。
Cerebras 是一把锋利的专用刀,适合“少数人要极快”的推理。
7.2 智能体是它最大的顺风
1. 智能体对速度的需求和人不一样
人每秒读不了 50 个 token,智能体不用“读”,拿到结果马上进行下一步。一个任务调用模型几十上百次,每一步快 10 倍,整个任务就从半小时变成几分钟。速度第一次变成了直接能换钱的东西。
2. 智能体已经是用量的主力
OpenRouter 的数据显示,2026 年 2 月 6 日可能是历史上人类消耗的 token 多于智能体的最后一天;10 月初单日用量前十的应用里,至少九个是智能体,至少六个在写代码。公司自报OpenRouter 数据页 详见《OpenRouter 榜单月报》。
3. 有人愿意为快付高价
有分析提到,Anthropic 对快两倍的档位收六倍的价钱,而且供不应求。第三方估算Futurum 至少在写代码这个场景,“快”有很强的定价权。
4. 几家巨头都在押这件事
OpenAI 用 Cerebras 做编程智能体的极速档;亚马逊把它放进自己的云平台,对外讲的理由就是智能体;英伟达发布 Groq 3 LPX 时,新闻稿标题写的也是“为智能体而生”。公司自报英伟达公告,2026-08-24
7.3 三道坎
第一道:智能体的大部分活流向了便宜模型,不是快模型
OpenRouter 上用量前 19 名的模型里,74% 的 token 流向了便宜的中国模型。本文推算基于 OpenRouter 榜单,2026-10-07 愿意为极速付溢价的,目前主要是写代码这一个场景。 其他场景会不会跟上,还没有证据。
第二道:“够快”可能就够了
SemiAnalysis 说,OpenAI 用普通英伟达 GPU、每块同时只服务很少的请求,就做出了每秒约 300 个 token 的极速档。媒体报道Briefs 这个说法未经证实。但如果大多数智能体觉得够用,专用芯片的市场就比想象的小。“够快”比“更快”更危险。
第三道:智能体的上下文很长,正好撞上它的短板
智能体干活时要带着很长的历史记录,而长上下文下一个机柜只能同时服务约 12 个请求。第三方估算beri.net 智能体最需要的“长上下文加高并发”,恰恰是它最吃紧的地方。 和 AMD、亚马逊搭档就是为了把上下文交给对方的芯片去存,能不能大规模跑通要到 2027 年才知道。
7.4 市场起来了,钱归谁
英伟达已经入场,而且能把快芯片和 GPU 打包卖。所以更可能的结果是:市场做大了,Cerebras 拿到其中一块,而不是独占。
| 问题 | 我的看法 | 把握 |
|---|---|---|
| 智能体会不会让快速推理变成大市场 | 会,至少在写代码上已经发生 | 较高 |
| 这个市场会不会扩展到写代码以外 | 有可能,没有证据 | 低 |
| Cerebras 能不能分到一块 | 能,它是上市公司里唯一纯做这件事的 | 中 |
| 能不能成为赢家 | 说不准,英伟达的打包优势很强 | 低 |
这张表是我的判断。
智能体给了 Cerebras 一个真实的机会,这也是木头姐敢越跌越买的底层理由。但它赌的是有足够多的智能体愿意为快多付钱,并且这笔钱不被英伟达拿走。
最该盯的两个信号:
- 写代码以外,有没有第二个场景出现“极速档”并且卖得动;
- 2027 年亚马逊那条线上线后,企业客户用不用。
八、估值
10 月 8 日查询时的最新数据:第三方估算StockAnalysis
| 项目 | 数字 |
|---|---|
| 股价 | 168.75 美元 |
| 市值 | 约 401 亿美元 |
| 净现金 | 约 64 亿美元 |
| 过去 12 个月收入 | 6.81 亿美元(会计准则口径) |
| 过去 12 个月净亏损 | 4.87 亿美元 |
| 市销率 | 约 60 倍 |
| 分析师平均目标价 | 291.64 美元 |
换几个角度算:本文推算基于公司指引
- 按 2026 年核心收入指引约 8.85 亿美元:市值约是它的 45 倍;
- 按管理层说的“2027 年三倍以上”,约 27 亿美元:约 15 倍;
- 扣掉净现金后按 2027 年算:约 12.5 倍。
怎么读:按现在的收入看贵得离谱,按 2027 年的预期看不算出格。全部问题归结为:2027 年“三倍以上”能不能兑现,而这取决于 OpenAI 那份合同的执行节奏。
另外两点:它正在变成一家重资产的算力公司,过去 12 个月资本开支约 7.5 亿美元,自由现金流为负 6.8 亿美元;做空股数约占流通股的 11.6%,解禁前后多空博弈会很激烈。
我的判断
- 技术:没有输。晶圆级芯片在大模型上的结构性优势是真的,英伟达那句“快 4 倍”不公平;
- 生意:处在最难的一段。最大的客户有了别的选择,最强的对手正面入场,自己还在烧钱建数据中心;
- 股价:11 月 10 日前有约占总股本七成的股票解禁,这是确定的压力;
- 木头姐:她的逻辑能自洽,押的是五年后的市场。但她的买入不能当成“底部”的信号,她在这只股票上从 300 美元以上一路买下来;
- 我会怎么做:不在解禁前动手。等两件事落地再评估:三季度财报里 OpenAI 相关收入有没有继续增长,解禁之后股价在哪里站住。如果要参与,这是一个只能用小仓位、能承受腰斩的位置。
该写进档案的证伪信号
- OpenAI 相关收入环比下降,或 RPO 下降;
- 2027 年“核心收入三倍以上”的说法被收回或下调;
- 独立测试显示 LPX 在大模型上也不输 CS-4;
- CS-5 推迟到 2027 年以后,或发布时片上内存和并发能力没有改善;
- 和 AMD 的联合方案、亚马逊云平台的上线时间推迟;
- 核心毛利率跌破 35%;
- 解禁之后高管继续大额卖出;
- 到 2027 年,写代码以外仍没有第二个愿意为极速付溢价的场景;
- 反过来,如果 OpenAI 公开确认新一代模型的高速档继续用 Cerebras,最重的那条利空就解除了。
金豆划重点
- 跌破发行价,三件事叠加:OpenAI 极速档传闻、高管卖出超过 3 亿美元、解禁。11 月 10 日前还有约 1.71 亿股解禁;
- 木头姐四次买入都在利空之后,押的是快速推理和不需要 HBM 的芯片;
- “快 4 倍”比的是旧系统,CS-4 和 LPX 谁更快没有定论;两家片上内存几乎一样,天花板也一样;
- 片上内存加不上去是它最大的短板。解法是在晶圆上叠一层 DRAM,要等到 CS-6,时间没有公布;CS-5 目标 2027 年,速度再翻倍;
- CS-4 的芯片没换代,靠把供电贴到晶圆背后让性能翻倍;
- 它不受先进封装和 HBM 缺货影响,但有自己更难的组装工艺,而且 LPX 同样绕开了这两样;
- 机房成本两家打平;Cerebras 只租不买,2027 年底前 600 兆瓦里约 500 兆瓦要交给 OpenAI;
- OpenAI 是客户、债主加股东;亚马逊那条线 2027 年年中才有收入,还没计入在手订单;
- 智能体是最大的顺风,三道坎:活流向便宜模型、普通 GPU 可能已经够快、长上下文撞上片上内存的短板;
- 估值全看 2027 年收入能不能做到三倍以上。
资料来源:Cerebras 2026 年二季度财报、电话会和监管文件;英伟达关于 Groq 3 LPX 的公告;ARK 每日交易披露的相关报道;The Decoder、beri.net、TechTimes、Shattered 对两家产品的技术分析;FinanceFeeds、Trefis、Benzinga、Briefs、Business Chief 等媒体报道;StockAnalysis 的行情和估值数据;SemiAnalysis、The Register、DCD、Futurum、XenoSpectrum 关于 CS-4 和两家整机功耗、散热的报道;JLL、STL Partners 等机构的机房造价基准;Futurum 对招股书和亚马逊合作的解读;Peak FLOPS 对晶圆级芯片组装工艺的分析,Cerebras 在 2026 年 Hot Chips 会议上公布的路线及 ServeTheHome 的报道,以及关于 CoWoS、HBM 供应和三星代工 LP30 的行业报道;Cerebras 二季度 10-Q 及 Digi Power X、CleanCore、Compute Nordic 等合作方的公告。OpenAI 极速档所用硬件一事来自 SemiAnalysis 的判断,未经 OpenAI 或 Cerebras 证实;Cerebras 的速度数字为公司自报。
本文仅为研究和信息分享,不构成任何投资建议。