供应商和大客户之间,大多数关系是零和的:客户拼命压价,供应商想办法锁住客户;客户做大了就想自己干,供应商做大了就想往客户的生意里伸手。
奈飞(NFLX)和亚马逊(AMZN)的云服务 AWS,是少数真正"一起长大"的案例。2008 年奈飞决定把整个公司搬上 AWS,十八年后:
- 奈飞:收入从 13.65 亿美元涨到 2025 年的 451.8 亿,涨了 33 倍;营业利润率从 8.9% 升到 29.5%;
- AWS:从一个亚马逊都不肯单独披露的"副业",变成 2026 年二季度单季收入 422 亿美元、贡献亚马逊约六成营业利润的业务;
- 股价:2008 年 8 月到 2026 年 9 月,按复权价格计算,奈飞约 163 倍,亚马逊约 63 倍。
更反常的是:亚马逊在 2011 年就推出了在线视频,和奈飞正面竞争。一家公司把整个系统放在竞争对手的机器上,不但没被坑,还和对方一起做大了。
这篇把这次合作当成一个商业案例来拆:它为什么能成、机制是什么、有哪些条件缺一不可,以及这套逻辑放到今天的 AI 公司和云厂商身上还成不成立。
先把几个词讲清楚
| 词 | 通俗解释 |
|---|---|
| 云计算 / AWS | 按需租用别人的服务器、存储和数据库,用多少付多少;AWS 全称 Amazon Web Services,是亚马逊的云服务 |
| 可用区 / 区域 | 云厂商的机房分布:一个"区域"是一个地理范围(如美国东部),里面有几个相互独立的"可用区"(独立供电的机房) |
| CDN | 内容分发网络:把视频、图片提前放到离用户近的服务器上,减少远距离传输 |
| 控制面 / 数据面 | 控制面是"指挥系统"(账户、推荐、计费、决定播什么);数据面是"运输系统"(把视频数据真正送到你的屏幕) |
| 微服务 | 把一个大程序拆成很多只干一件事的小服务,一个坏了不影响其他 |
| 出口流量 | 从云上往外传的数据量;云厂商通常按这个收费,对视频公司来说是一笔大钱 |
一、合作的起点:2008 年,双方各缺什么
任何好的合作,都始于双方各自有一个自己解决不了的问题。
| 2008 年 | 奈飞 | AWS |
|---|---|---|
| 所处阶段 | 收入 13.65 亿美元;2007 年 1 月刚推出在线看片,正从寄 DVD 转向流媒体 | 2006 年 3 月推出存储服务、8 月推出计算服务,才两岁 |
| 刚发生的事 | 8 月数据库损坏,三天寄不出一张 DVD | 客户以创业公司和开发者为主 |
| 缺什么 | 能随流量弹性扩张的基础设施;没有单点故障的系统;走向全球的能力 | 一个家喻户晓的大公司,证明核心业务可以放心放在云上 |
| 最大的风险 | 把命交给一家供应商——而且这家供应商的母公司卖 DVD、以后还会做视频 | 大客户上来后出重大事故,砸了招牌 |
奈飞为什么决定上云?把它后来公开的理由归纳一下,核心是四条:
- 流量没法预测。流媒体刚起步,几年后需要多少服务器,谁也算不准。自己建机房,猜少了服务崩,猜多了钱烧在空转的机器上;云可以用多少租多少;
- 钱要花在内容上,不是服务器上。对奈飞来说,每一块钱的边际价值,放在版权和自制剧上远高于放在机房里;
- 单点故障不可接受。2008 年那次事故证明,集中式的机房,一个地方坏了全盘皆输;
- 速度。自建数据中心要找地、拉电、装机,以年计;云上开一批服务器以分钟计。
为什么选 AWS?奈飞后来给的理由是规模和服务的丰富程度——在当时,AWS 是唯一一家能同时提供大规模计算、存储和数据库服务的云厂商。换句话说,奈飞没得选,AWS 也没得选:一个是唯一能接住这个需求的供应商,一个是唯一敢把全部业务放上来的大客户。
二、分工:租"大脑",自建"血管"
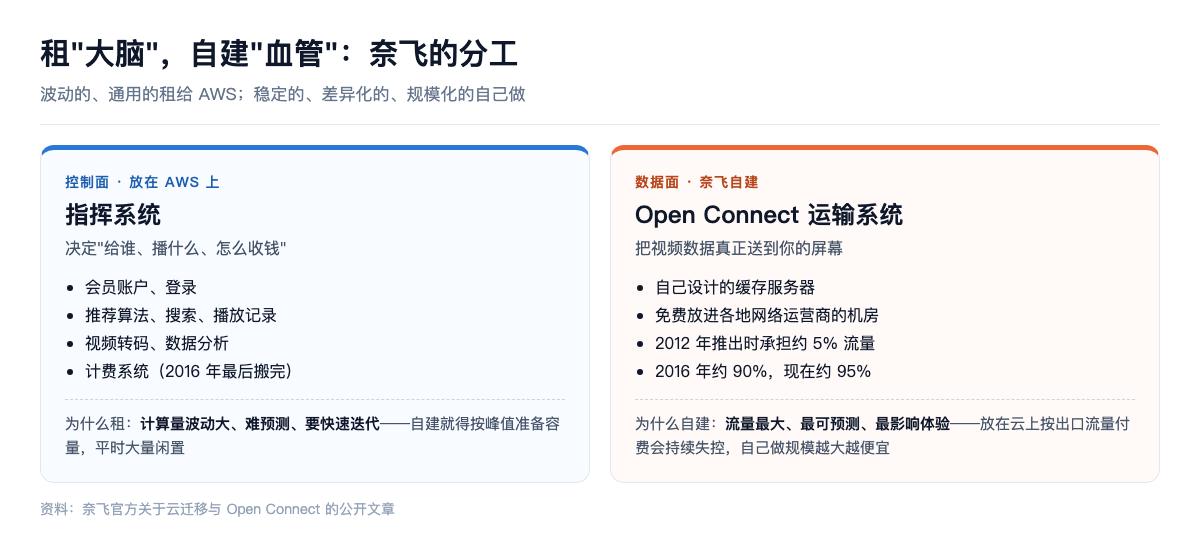
这是整个案例里最值钱的一个设计,也是最常被忽略的一点:奈飞并没有把"所有东西"都放在 AWS 上。
放在 AWS 上的,是控制面——会员账户、推荐算法、搜索、播放记录、视频转码、数据分析,以及最后搬过去的计费系统。这些业务的特点是:计算量波动大、难预测、需要快速迭代,正好适合按需租用。
自己建的,是数据面——把视频数据真正送到用户屏幕上的那部分。2012 年 6 月,奈飞正式推出自建的内容分发网络 Open Connect:它自己设计缓存服务器,免费放进各地网络运营商的机房里,把热门视频提前存到离用户最近的地方。刚推出时只承担约 5% 的流量,2016 年约 90%,现在约 95% 的奈飞流量通过它和运营商直连传输。
为什么这样切?因为两部分的经济性完全相反:
- 视频传输是奈飞最大、最稳定、最能拉开差距的那部分。流量巨大且可预测,如果放在云上按出口流量付费,会是一笔持续失控的成本;自己做,规模越大越便宜,而且播放质量直接决定用户体验;
- 控制面的计算是波动的、多样的、非核心的。自己建,得按峰值准备容量,平时大量闲置;租,才能把闲置的成本转给云厂商去摊。
所以奈飞真正的规则不是"全部上云",而是:波动的、通用的租;稳定的、差异化的、规模大到自己做更便宜的,自己做。
这条规则有一个反面对照,正好证明它是对的。Dropbox 在 2015 年做了相反的选择:把用户文件从 AWS 的存储服务搬回了自建的系统。根据它上市招股书,两年里因此省下约 7,460 万美元的运营成本。原因很简单:对 Dropbox 来说,存储就是它的核心产品,而且规模大、需求稳定——这正是奈飞留给自己的那一类。同一套规则,两家得出了相反的结论,都是对的。
三、双方各自得到了什么
AWS 给奈飞的
第一,弹性和速度。搬家的七年里(2008 年 8 月到 2016 年 1 月),奈飞的流媒体会员涨了 8 倍,观看总时长涨了约一千倍。这种增长如果靠自建机房去追,几乎不可能不出事。2016 年 1 月,奈飞在同一天把服务开到 130 多个国家,靠的是 AWS 在各大洲已经建好的区域。
第二,成本。奈飞后来公开说,云上每一次播放的成本,只有当年自建机房时的一小部分。
第三,也是投资人最该看的:一张极轻的资产负债表。看奈飞的资本开支(买设备和建设施的钱)占收入的比例:
| 年份 | 收入(亿美元) | 营业利润率 | 资本开支占收入 |
|---|---|---|---|
| 2008 | 13.65 | 8.9% | 3.2% |
| 2012 | 36.1 | 1.4% | 1.1% |
| 2016 | 88.3 | 4.3% | 1.2% |
| 2020 | 250.0 | 18.3% | 2.0% |
| 2025 | 451.8 | 29.5% | 1.5% |
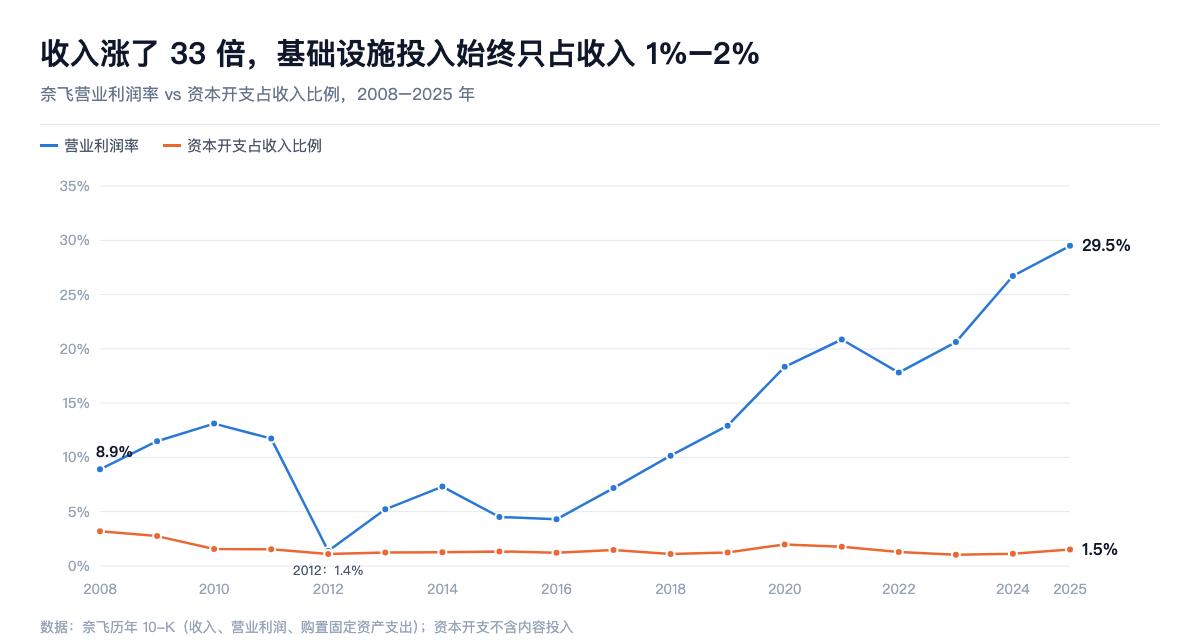
十七年里,奈飞的收入涨了 33 倍,但它花在设备和设施上的钱,几乎一直只占收入的 1% 到 2%。省下来的钱去了哪?去了内容——今天奈飞一年在内容上花的钱是这个数字的几十倍。这就是云给奈飞的真正礼物:它把一家本该是重资产的视频公司,变成了一家只需要在"内容"这一个地方重投入的公司。利润率从个位数升到接近三成,很大程度上是这个结构的结果。
奈飞给 AWS 的
这一半经常被忽略,但它可能比奈飞付的账单更值钱。
第一,示范效应。在云计算还被大公司普遍怀疑的年代,一家家喻户晓、晚上高峰期占掉北美大量网络流量的消费公司,把整个业务跑在 AWS 上,而且跑得比自建机房还稳。这对 AWS 说服其他大公司的作用,是任何销售团队都给不了的。
第二,方法论。奈飞在云上摸索出来的做法——微服务架构、多区域同时运行、在正式系统里主动制造故障来检验稳定性(著名的"混沌猴子"Chaos Monkey)——2012 年前后陆续开源,等于免费教会了整个行业怎么正确地用云。每一家学会这套方法的公司,上云的门槛都更低了,而它们大多也成了 AWS 的客户。奈飞在做大自己的同时,也在做大 AWS 的市场。
第三,压力测试。奈飞是 AWS 早期规模最大、要求最苛刻的客户之一。我的判断是:一个客户愿意把全部业务押上来、并且公开讲出每一次踩坑,对一个两岁的云平台来说,就是最好的产品打磨。
第四,人才。奈飞当年主导云架构的负责人阿德里安·科克罗夫特(Adrian Cockcroft),2016 年后加入了 AWS,负责云架构战略。
结果是:亚马逊在 2015 年 4 月第一次单独披露 AWS 的业绩——2014 年收入 46.4 亿美元,营业利润 6.6 亿,利润率约 14%。到 2026 年二季度,AWS 单季收入 422 亿美元、营业利润 166 亿,利润率约 39%,同比增长 36.7%。
四、风险是怎么被管住的
一段长期合作,光有互补还不够,还得扛得住三种风险。
风险一:供应商出事故
奈飞的做法是:默认供应商一定会出事,然后按这个假设设计系统。
- 2011 年 4 月 21 日,AWS 美国东部区域大故障,存储服务连锁崩溃一天多,Reddit、Quora、Foursquare 等网站成片宕机。奈飞基本没受影响——它没有把核心数据押在出事的那个存储服务上,而且系统本来就是按"随时会坏"设计的;
- 2012 年 12 月 24 日平安夜,AWS 一名工程师误删了负载均衡服务的部分关键数据,奈飞在美国、加拿大和拉美的电视端大面积无法播放,直到圣诞节早上 8 点 45 分才完全恢复。这次奈飞被打中了。之后它把系统改成多个区域同时在线,一个区域出问题,流量自动切到另一个。
这里有一个关键区别:奈飞从来没把"可用性"寄托在供应商的承诺上,而是用自己的架构去买保险。七年的重写、在正式系统里天天制造故障,都是这份保险的保费。
风险二:供应商就是竞争对手
2011 年 2 月,亚马逊把在线视频免费送给所有 Prime 会员,正面抢奈飞的用户。平安夜那次宕机时,有媒体注意到亚马逊自家的视频服务基本没受影响。
奈飞为什么还敢留下?我认为有两层原因:
- AWS 的商业模式依赖中立。AWS 卖的其实是信任。如果它敢因为亚马逊视频的利益去动客户的系统,所有和亚马逊有竞争关系的公司都会离开——而这几乎是半个美国商业界。AWS 要的是奈飞的账单,不是奈飞的生意;
- 奈飞把真正的差异化留在了自己手里。内容和版权是自己的;推荐算法虽然跑在 AWS 的机器上,但代码和数据是自己的;视频传输走的是自建的 Open Connect。AWS 能看到的是算力的使用量,碰不到奈飞赖以竞争的东西。
但中立也有边界。据《华尔街日报》2017 年报道,沃尔玛曾要求部分技术供应商不要使用 AWS。对零售商来说,亚马逊零售是生死对手,它们对"把数据放在对手的机器上"的容忍度就低得多。奈飞能留下,是因为亚马逊视频对它虽然是威胁,但它的核心能力(内容、推荐、全球发行)并不在 AWS 的可见范围之内。
风险三:被锁定
长期依赖一家供应商,最大的风险是失去议价权。奈飞的应对是:
- 规模本身就是议价权——它是 AWS 最重要的标杆客户之一,走不走都是大事;
- 把最大的一块成本(视频传输)从一开始就放在自己手里,AWS 账单再大,也不是奈飞成本结构里最重的那一项;
- 云原生的架构和开源的工具,让它的系统不依赖某一台机器或某一个机房。
五、为什么能"一起成长":五个条件
把前面拆开的东西合起来,我认为这次合作能成,是因为同时满足了五个条件。少一个,结局都可能不同。
条件一:能力互补,不重叠。奈飞的核心是内容和产品,AWS 的核心是基础设施。双方都不想做对方的事——至少在这段合作的核心期是这样。
条件二:客户守住了差异化的那一层。内容、推荐算法和视频传输,奈飞都握在自己手里。它租的是"通用能力",不是"竞争力"。
条件三:供应商的商业模式靠中立活着。AWS 如果背后使坏,损失的是整个云业务的信誉。供应商坑你的代价越大,你把命交给它就越安全。
条件四:双方在同一条增长曲线上。流媒体爆发,奈飞需要更多算力;奈飞用得越多、讲得越多,AWS 的名声越大、客户越多、规模越大、价格越低,又反过来让奈飞更划算。这是一个正循环,而不是一方吃掉另一方的增长。
条件五:客户为依赖付了"保险费"。七年重写、混沌工程、多区域运行,奈飞花了大量工程资源,确保"依赖 AWS"不等于"被 AWS 拖垮"。依赖可以,脆弱不行。
反过来看,这五个条件也是判断一段合作会不会变质的清单:当客户开始把核心能力交出去,当供应商开始做客户的生意,当一方的增长开始靠吃掉另一方——合作就会从"一起成长"变成"互相提防"。
六、用这五个条件,看今天 AI 公司和云厂商的合作
同样的剧本正在 AI 时代重演,而且规模大得多。AI 实验室和 AI 创业公司,就是 2008 年的奈飞:核心是模型和产品,算力需求增长快到没法预测,也不想把资本压在机房上。它们的"AWS",是大型云厂商和一批新型 AI 云。
用上面的五个条件去看几组代表性的合作:
| Anthropic 与 AWS | OpenAI 与微软 | AI 创业公司与新型 AI 云(如 Nebius、CoreWeave) | |
|---|---|---|---|
| 能力互补 | 是:模型 vs 算力和自研芯片 | 是 | 是 |
| 客户守住核心 | 是:模型自己训练 | 是 | 大多是 |
| 供应商是否中立 | 部分:亚马逊有自己的 Nova 模型,同时还是 Anthropic 的大股东 | 较弱:微软有自己的 MAI 模型,Copilot 产品和 OpenAI 直接竞争 | 较强:这类云不卖自己的前沿模型 |
| 同一条增长曲线 | 是:Anthropic 承诺超过 1,000 亿美元的 AWS 支出 | 是,但在松绑 | 是 |
| 客户是否在降低依赖 | 是:同时大规模使用谷歌的 TPU | 是,而且很激进:和甲骨文建"星际之门"、签 CoreWeave、Cerebras、AMD | 刚开始 |
三个观察:
第一,今天的供应商,远不如当年的 AWS 中立。大型云厂商几乎都在做自己的大模型,还往 AI 实验室里投了大笔股权。供应商、股东、竞争对手三重身份叠在一起,这是奈飞当年没遇到过的复杂局面。这也是为什么 AI 实验室都在多云并行,也是为什么"不卖自己模型"的新型 AI 云会有市场——我在 Nebius 那篇里讲过,中立本身就是它的卖点之一。
第二,头部 AI 公司正在做自己的"Open Connect"。奈飞在控制面租云、在数据面自建;今天 OpenAI 一边租算力,一边和甲骨文、软银一起建自己的超大数据中心,还在和芯片公司签定制合作(Cerebras、AMD那两篇都拆过)。逻辑一模一样:当某一层成本大到可预测、又直接决定竞争力,就该自己握住。对供应商来说,这是一个信号——最大的客户,迟早会把最大的那块业务收回去。
第三,真正的"奈飞式"双赢,大概率出现在中间层。超大 AI 实验室太大,会自己建;大型云厂商不够中立,会被提防。中等规模、快速增长、又不想被任何一家大厂绑住的 AI 公司,和一个靠中立活着的算力供应商之间,最接近 2008 年奈飞和 AWS 的关系。
七、投资上怎么用这个案例
如果你想在今天找到下一对"一起起飞"的公司,奈飞和 AWS 给了几个可以直接用的观察点:
- 看供应商最大的客户愿不愿意公开站台。奈飞愿意在各种场合讲自己怎么用 AWS,这是真实依赖的信号;只在新闻稿里出现一次的"战略合作",分量要打折;
- 看客户的资本开支占收入比例和利润率的走向。奈飞的 1%–2% 和不断上升的利润率,说明它真的把重资产转给了供应商,并且把省下的钱投到了能赚钱的地方;
- 看供应商和客户之间有没有利益冲突,以及冲突的代价由谁承担。AWS 使坏的代价由整个云业务承担,所以它不会;
- 看客户有没有开始把某一层收回来。这对客户通常是好事(利润率提高),对供应商则是一个"最大客户将要缩量"的信号。
最后提醒一句:一起起飞,不等于一路顺风。奈飞在 2011 年因为拆分 DVD 业务和突然涨价闹出大风波,股价从 2011 年 4 月到 2012 年底跌了约六成,营业利润率在 2012 年只有 1.4%。能拿满那 163 倍的人,必须熬过合作最艰难、公司最狼狈的那两年。
我的判断
奈飞和 AWS 的故事,常被讲成"奈飞眼光好,早早上了云"。这只说对了一半。
真正让这段合作变成双赢的,是奈飞在"依赖"和"独立"之间划的那条线:通用的、波动的能力租给 AWS,差异化的、稳定的、规模化的能力留给自己;然后花七年时间、用一只天天捣乱的猴子,确保这份依赖不会变成致命伤。AWS 这边,则是用"中立"这条商业模式底线,让一个竞争对手也敢把命交给它。
今天的 AI 行业,算力供需比 2008 年的云大几个数量级,但双方关系复杂得多——供应商在做模型,投资人在当供应商,客户在自建机房。用奈飞那条线去看,谁在守住自己的核心、谁的供应商靠中立活着,答案会比看合同金额清楚得多。
金豆划重点
- 结果:2008 年奈飞把整个公司搬上 AWS;到 2025 年,奈飞收入涨了 33 倍(13.65 亿 → 451.8 亿美元)、营业利润率从 8.9% 升到 29.5%;AWS 从 2014 年首次披露的 46.4 亿收入,到 2026 年二季度单季 422 亿、利润率约 39%、贡献亚马逊约六成营业利润;2008 年 8 月以来奈飞股价约 163 倍,亚马逊约 63 倍;
- 起点:奈飞缺弹性的全球基础设施,AWS 缺一个敢把核心业务放上来的知名大客户——双方都没得选;
- 分工:控制面租 AWS,数据面自建(Open Connect 现在承担约 95% 的奈飞流量);规则是"波动的、通用的租,稳定的、差异化的、规模化的自己做";Dropbox 按同一规则得出相反结论——存储是它的核心,所以 2015 年搬离 AWS,两年省下约 7,460 万美元;
- 奈飞得到的:弹性、全球化速度、更低的单次播放成本,以及一张极轻的资产负债表——17 年里资本开支一直只占收入 1%–2%,钱都投进了内容;
- AWS 得到的:示范效应、开源方法论带来的更大市场、最苛刻客户的压力测试,以及人才;
- 风险管理:用架构而不是合同来防宕机(2011 年扛住、2012 年平安夜被打中后改成多区域);AWS 靠中立活着,它要的是账单不是生意;但中立有边界,据报道沃尔玛就曾要求供应商避开 AWS;
- 五个条件:能力互补、客户守住差异化、供应商靠中立活着、双方在同一条增长曲线上、客户为依赖付了保险费;
- 放到 AI 时代:今天的供应商远不如当年的 AWS 中立(自己做模型、还当股东);头部 AI 公司正在建自己的"Open Connect";最接近"奈飞式双赢"的,可能是中等规模的 AI 公司和中立的算力供应商。
资料来源:奈飞官方关于完成云迁移、2011 年 AWS 故障经验、2012 年平安夜故障与 Open Connect 的公开文章;AWS 关于 2012 年 12 月 24 日负载均衡事件的官方说明;亚马逊 2015 年一季度及 2026 年二季度财报;奈飞历年 10-K(收入、营业利润、资本开支);Dropbox 上市招股书;《华尔街日报》2017 年关于沃尔玛的报道。股价回报按雅虎财经复权月线计算,截至 2026 年 9 月。表中对 AI 合作的评估为作者判断。本文不构成任何投资建议。
— 金豆